
多智能体工业流程出问题时,最终答案往往只是冰山一角。多数幻觉评测仍只比对最后一句输出,而真正的偏差常发生在中间的“思考—动作—观察”(Thought-Action-Observation)环节:跳过了必做步骤、引用了上一步并不存在的实体,或者越权调用了不该碰的工具。Trajel 这套数据集与评测框架,做的就是轨迹级审计——不只看答案对不对,还要定位偏差从第几步开始。
五类幻觉:把“错”拆成可判定的结构
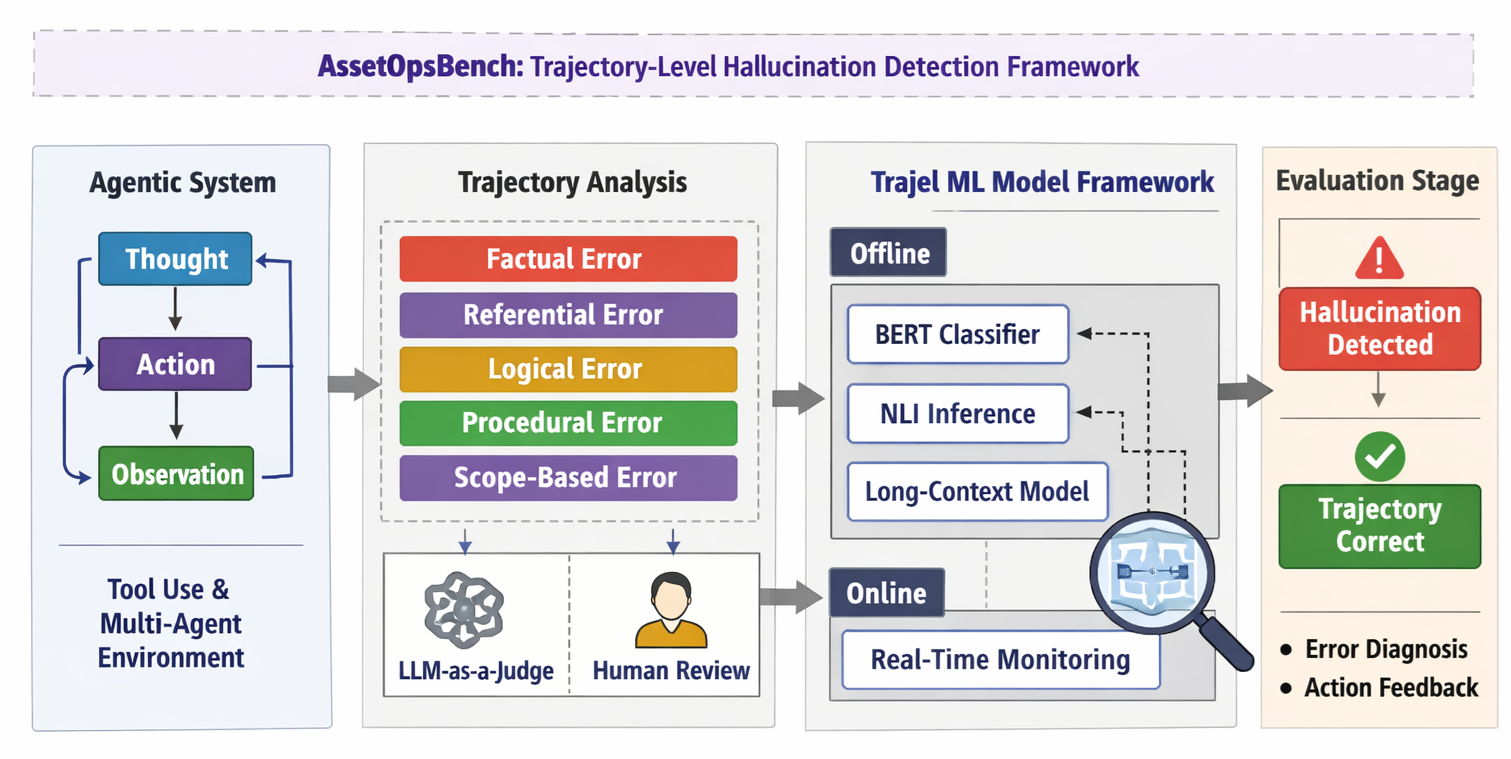
Trajel 把幻觉定义为轨迹上的结构化谓词,分为五类:事实型(陈述与证据不符)、指涉型(引用错误的实体、参数或上一步结果)、逻辑型(推理链不成立)、流程型(跳过或打乱规定步骤)、越界型(动作超出授权范围)。这个划分把“证据落地失败”“推理错误”“控制流违规”三类问题拆开,避免把工具执行失败也算成幻觉。标注结果显示,48.7% 的幻觉轨迹同时包含多种类型,因此必须按多标签处理,单一标签会丢信息。
225 条轨迹与两套评审
数据来自 AssetOpsBench 的 42 个工业运维任务,覆盖 6 个模型,共 225 条专家标注轨迹,在子任务与整条轨迹两个粒度上打标。每条轨迹同时经过 LLM 裁判与两家机构的盲审人工复核,人工识别的幻觉率为 68.3%,自动与人工判断之间的一致性只有 κ=0.456。这个数字本身就是结论:靠一个裁判模型打分并不可靠,按分类体系逐项核对才有意义。不同模型的幻觉率分布在 52.4% 到 81.0% 之间,流程型幻觉占已识别失败的 38.5%,说明“少做一步、顺序错了”比“事实说错”更常见。
三种检测器,输给一个轻量信号
作者比较了三类监督检测方案:子任务级用 BERT 分类、轨迹级用自然语言推理(NLI)、长上下文用 Longformer,分别对应不同幻觉类型所需的上下文范围。效果最好的监督分类器 AUC 只有 0.689。相比之下,智能体循环中本来就能采集的执行质量信号更强:清晰度与理由充分性(clarity-and-justification)的单变量 AUC 达到 0.908,明显高于所有训练过的分类器。也就是说,与其事后训练一个昂贵的判别器,不如在运行时记录“这一步有没有说清依据、有没有给出可核对的理由”,把它当作早期预警。
对工业落地的意义
这套方法给出的不是又一个排行榜,而是评测口径的改变:工业智能体的验收要落到轨迹上——每个动作是否有证据、是否按规程、是否在权限内。对多智能体系统而言,上游一个指涉错误会沿消息链放大,等到最终工单开错再回溯,成本已经付出。把轨迹级审计、多标签标注与运行时执行信号组合起来,才能在数据中心监控、设备维护这类高风险场景里,把“看起来答对了”与“过程真的对”区分开。
资料来源:Beyond Final Answers: Auditing Trajectory-Level Hallucinations in Multi-Agent Industrial Workflows — arXiv(2026-05)。本文为技术要点整理/编译,非原文全文。