
原子层沉积(ALD)的 AB 型工艺优化,是薄膜研发的日常活:找到前驱体与共反应物的最佳剂量时间,使过程自限制、每周期生长量接近饱和值,同时尽量缩短沉积时间。这活通常由人做饱和曲线,一轮轮加点。一篇 arXiv 论文把这件事交给推理型大模型智能体,在无人监督的闭环里与仿真反应器交互,并回答两个问题:推理模型做工艺优化到底行不行?它究竟是怎么想的?
智能体的两段式结构
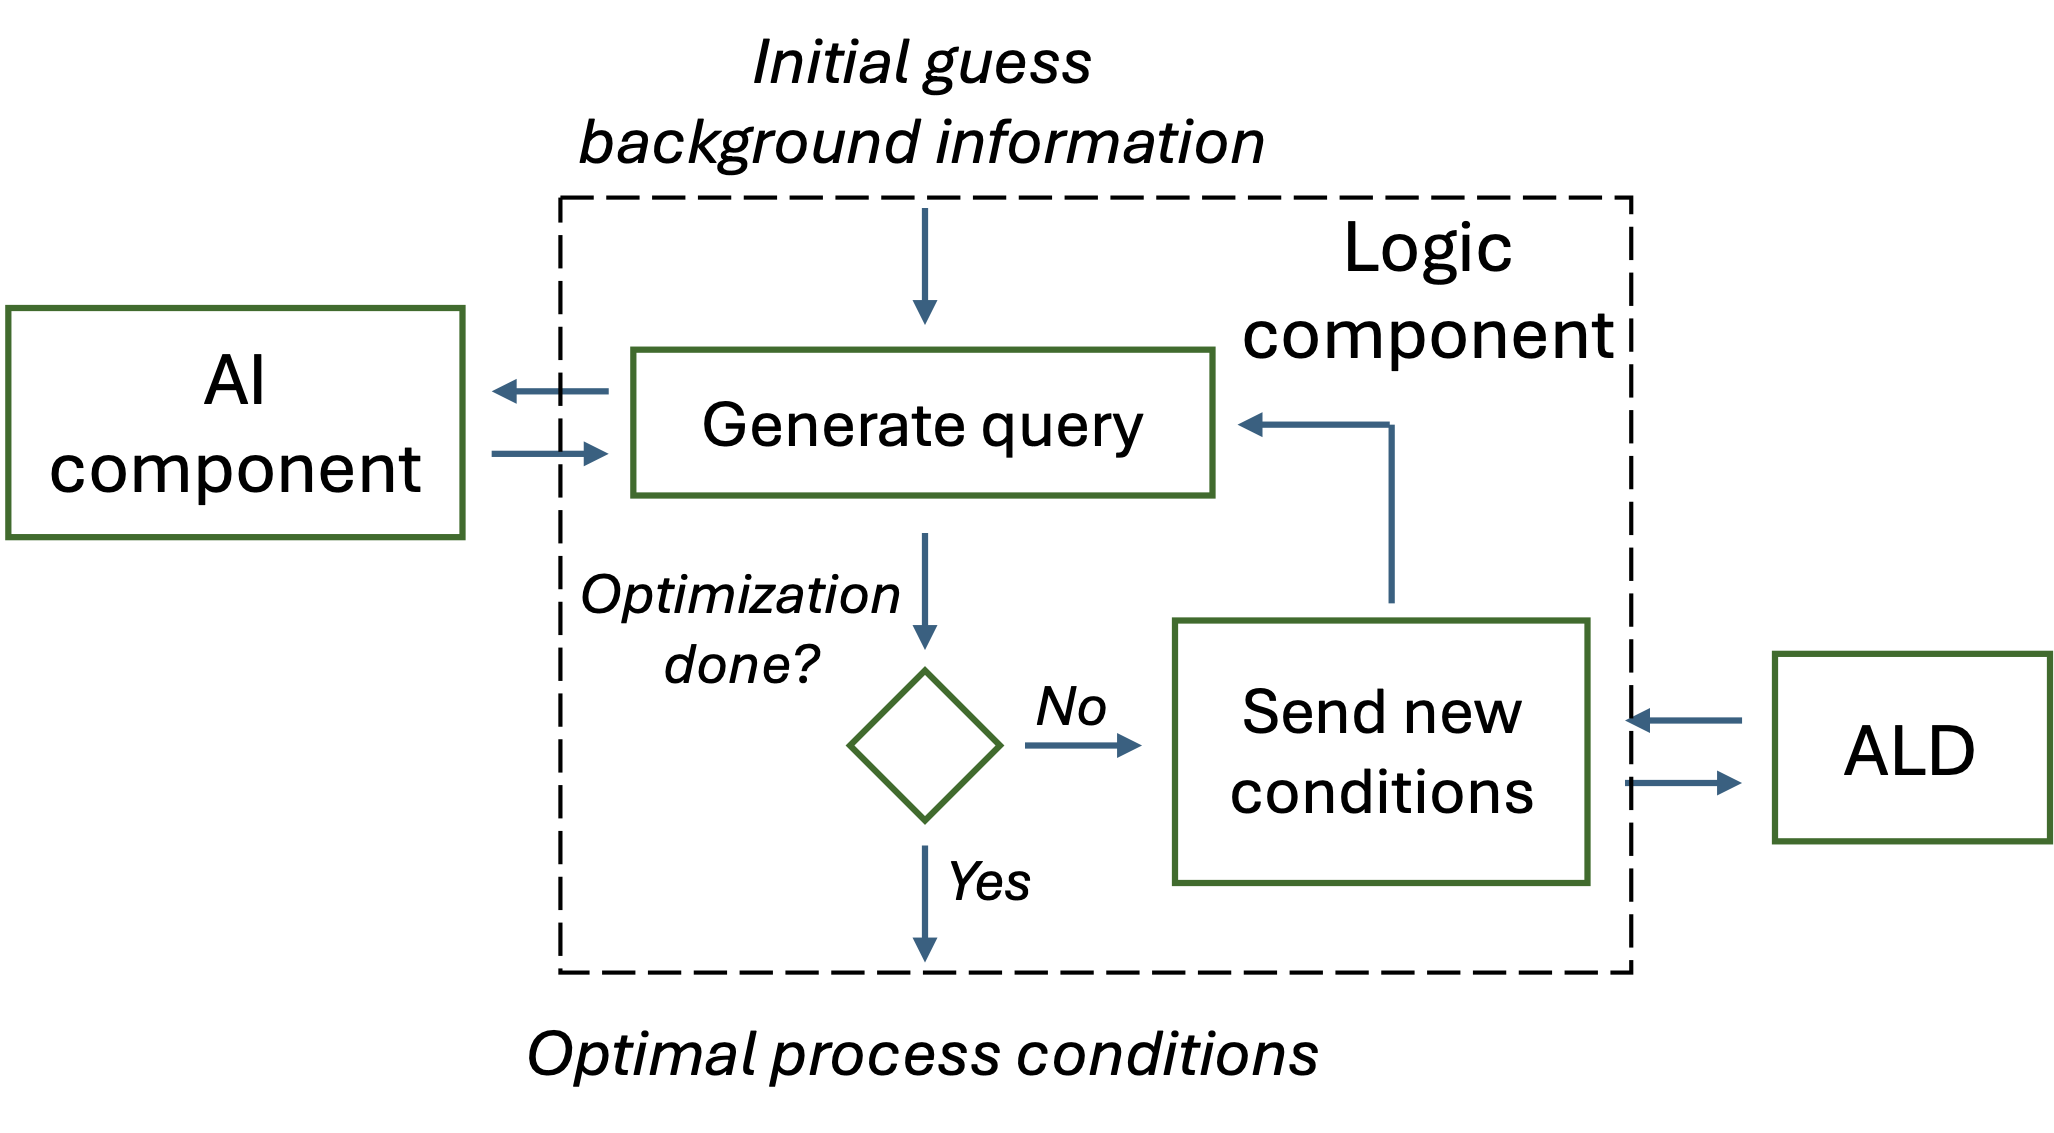
架构分逻辑组件与 AI 组件。逻辑组件负责与反应器打交道:把当前实验数据交给模型,按模型要求追加生长实验,或者在模型判定收敛后终止并返回最优条件。AI 组件每轮调用两次模型:第一次用开放式回答,让模型讲清推理过程并给出下一步建议条件、是否已优化、是否为非自限制;第二次把这段开放回答转成 JSON 结构输出,供程序执行。这样既保留了思维链,又拿到机器可读的指令。作者还做了记忆变体,把历次输出一并喂回,保持跨轮连续性。
五个工艺与两种初值
被测对象是参数化的 ALD 反应器模型:一阶不可逆 Langmuir 动力学,可含多条反应路径,也可叠加一个非自限制的 CVD 分量。五个代表性工艺覆盖快与快、快与慢、慢与慢、软饱和与快四类饱和曲线,饱和生长量取 1.0 与 0.3 埃每周期。每种条件跑十次独立实验,初值分别设为 0.2 秒与 2 秒,且不告诉模型任何先验生长量——相当于一条全新工艺的最坏情况。
结果:能收敛,但答案散
除软饱和工艺的一次运行外,基于 o3 与 GPT5 的智能体在所有运行中都自报完成了优化。问题在于重复性:同一工艺、同一初值,十次跑出的最优剂量差异明显。慢与慢工艺从 0.2 秒起步时,o3 智能体给出的剂量时间标准差达 1 秒,超过平均最优剂量的 30%。初值的影响也很大,从 0.2 秒起步常得到明显更短的剂量,部分运行的生长量低于饱和值的 95%。把全部工艺与初值合起来看,100 个点的相对误差中位数为 0.02,o3 与 GPT5 的 75 分位分别为 0.05 与 0.04。整体偏好略欠饱和的条件,在研发场景可以接受,在量产则未必。
样本效率是可比的。多数条件平均用 10 到 15 个样本完成优化;慢与慢、慢与快从 0.2 秒起步时,o3 平均超过 20 个;而从 2 秒起步的不少运行不到 10 个样本。快与快工艺只需 3 到 6 轮迭代,每轮通常要求 2 到 4 个新条件。完全没有初值时,平均需要 21 个样本;给出前驱体蒸气压、生长量或起始剂量等提示后,降到 14 个左右,减少约三分之一,而最终条件质量没有明显变化——提示主要买来的是效率。
推理是通的,但会被自己带偏
作者逐轮检查开放式回答,发现模型的逻辑站得住:它围绕“自限制”和“饱和”设计实验,用生长量是否随剂量增加而趋平来判断。但也观察到两类失误:一是被自己此前的选择锚定,探索空间越走越窄;二是两段式转换出错,某次运行中第二步把开放分析误读为“该过程非自限制”,直接终止了优化。这说明两段式结构在保留可解释性的同时,也多了一个可能出错的接口。
给工艺智能体的提醒
这项工作给出的结论并不夸张:推理模型能在无人监督下跑完 ALD 优化,样本量与人类专家的饱和曲线实验相当,但重复性差、对初值敏感、终止判定可能误读。要进产线,至少需要三样东西:把初值与先验作为受控变量记录下来,避免“起点决定结论”;对终止条件做独立校验,而不是只信模型的结构化输出;以及把多次运行的结果分布,而不是单次最优点,作为交付指标。
资料来源:Performance of AI agents based on reasoning language models on ALD process optimization tasks — arXiv(2026-01)。本文为技术要点整理/编译,非原文全文。