
质检模型最怕换产品。传统做法是一类产品训一个模型,新品类上线就要重新采集正常样本、重新标注、重新训练。IndusAgent 走的是另一条路:只给一张待检图,不给同类正常参照,让一个 8B 的多模态策略自己决定要不要放大、裁剪、测量、比对,再综合工具返回的证据给出诊断。
为什么“再看一眼”不够
论文指出的问题很具体:小缺陷在整图视角下容易与正常外观变化混淆,而仅在同一个视角上增加推理,歧义依然解不开。人眼的做法是凑近看、换个角度看、量一量、和旁边同类区域比一比。IndusAgent 把这套动作工具化,训练策略在不确定时主动获取新证据,而不是在原地反复猜。
六个工具与两轮推理
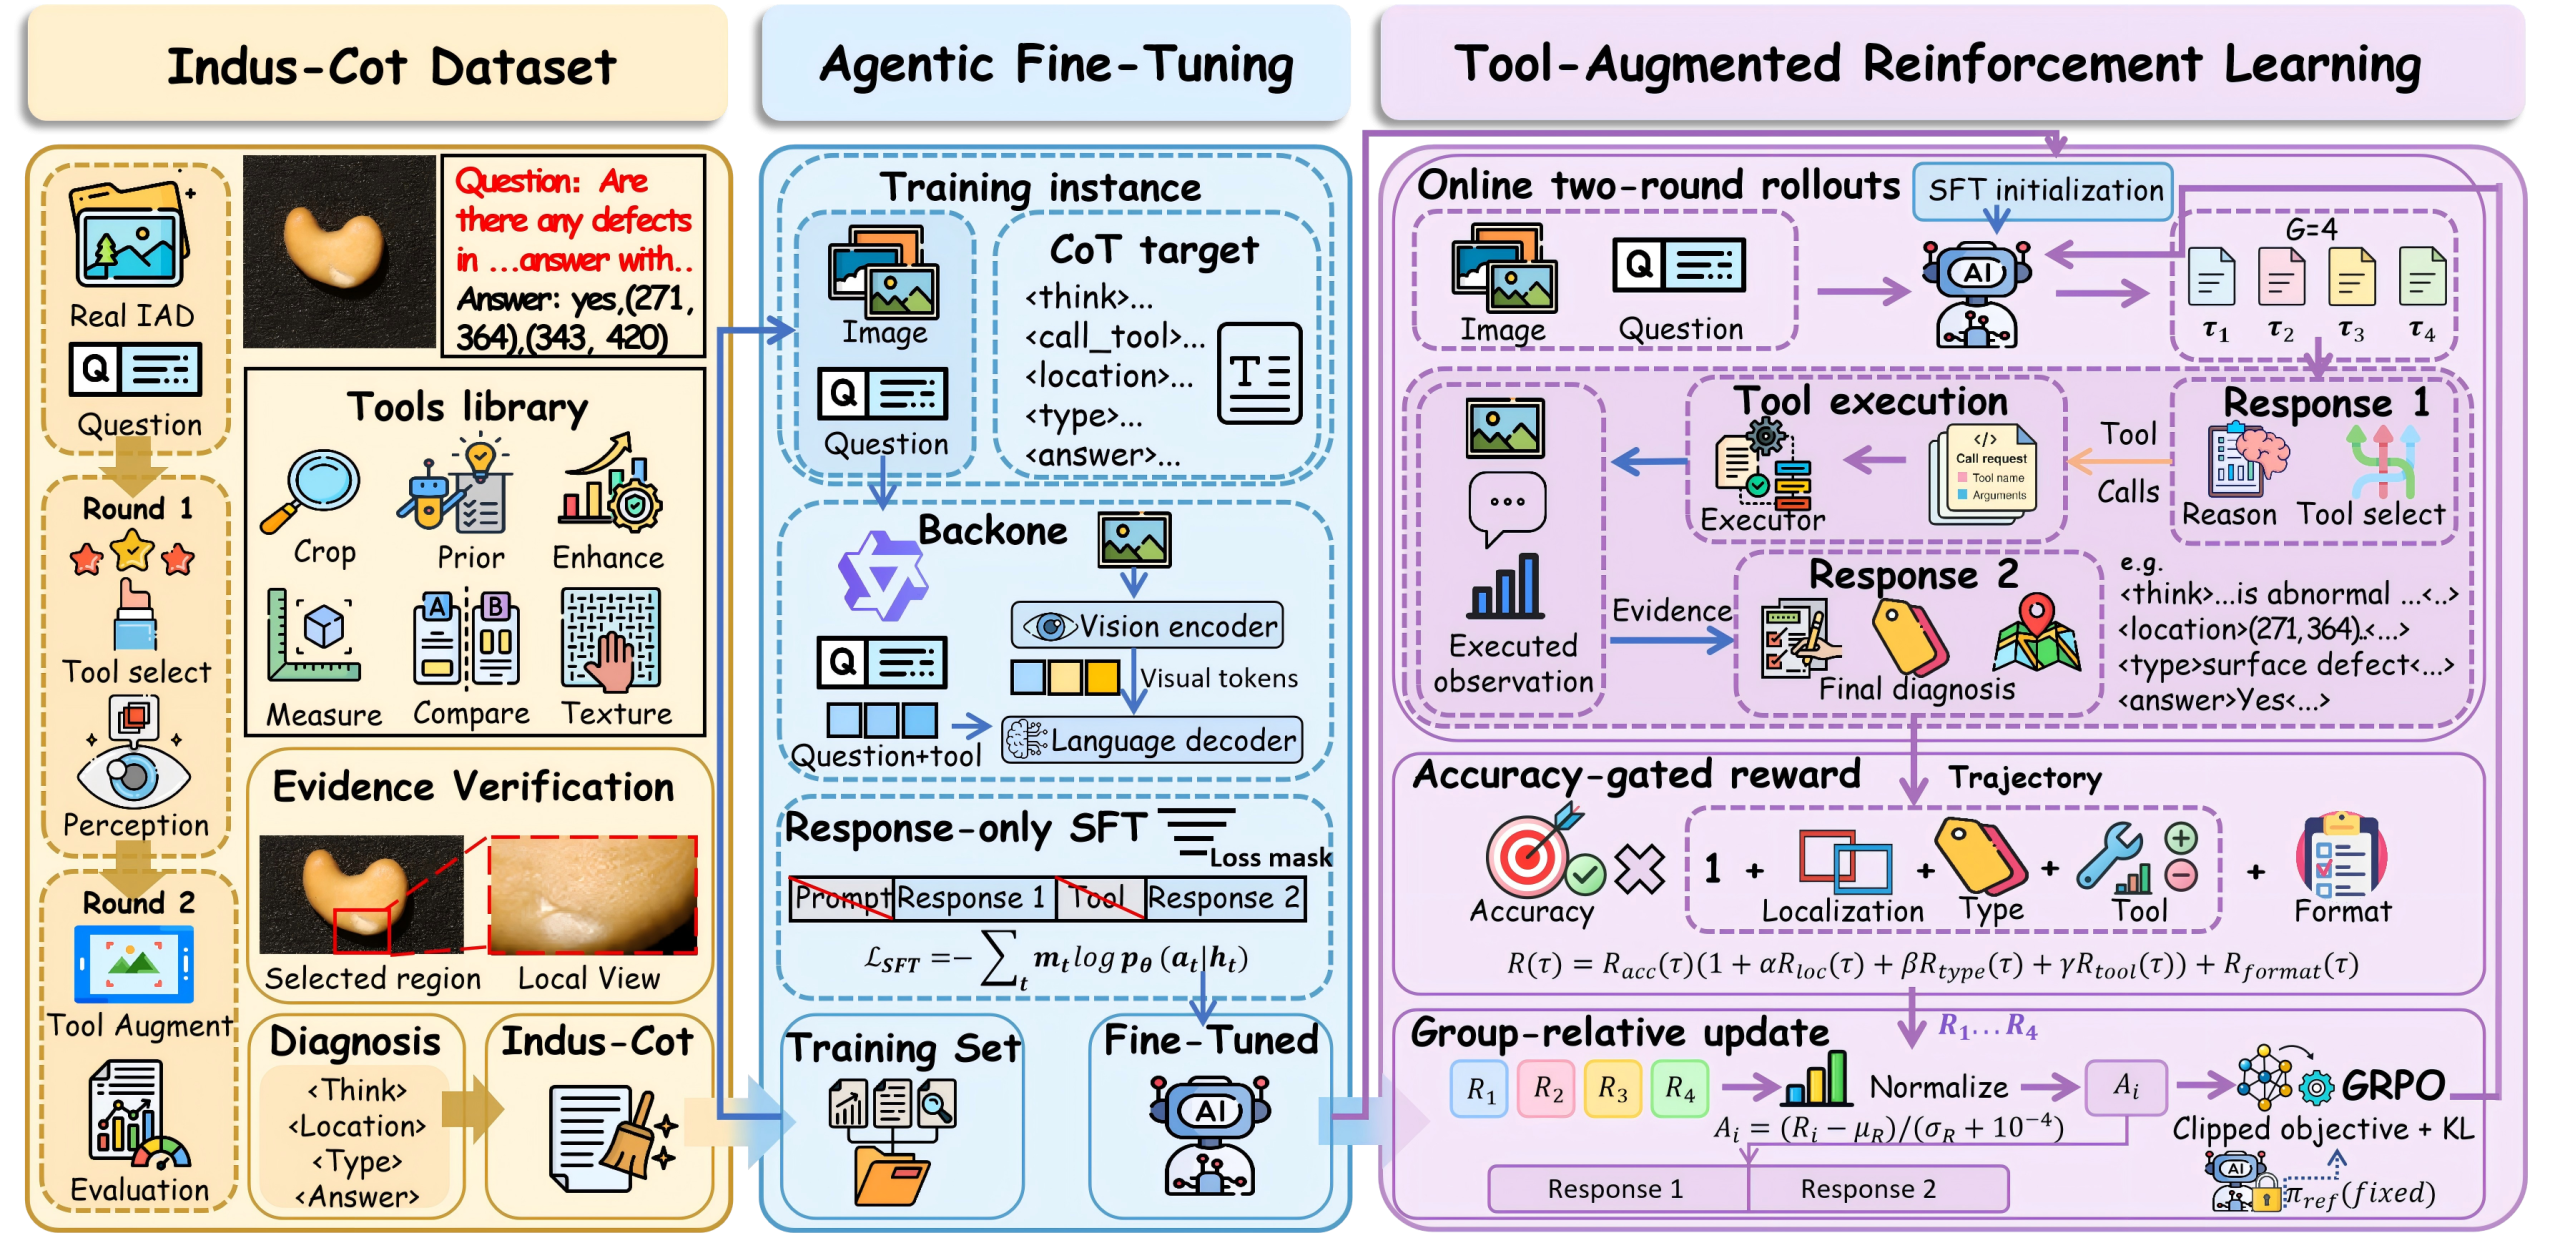
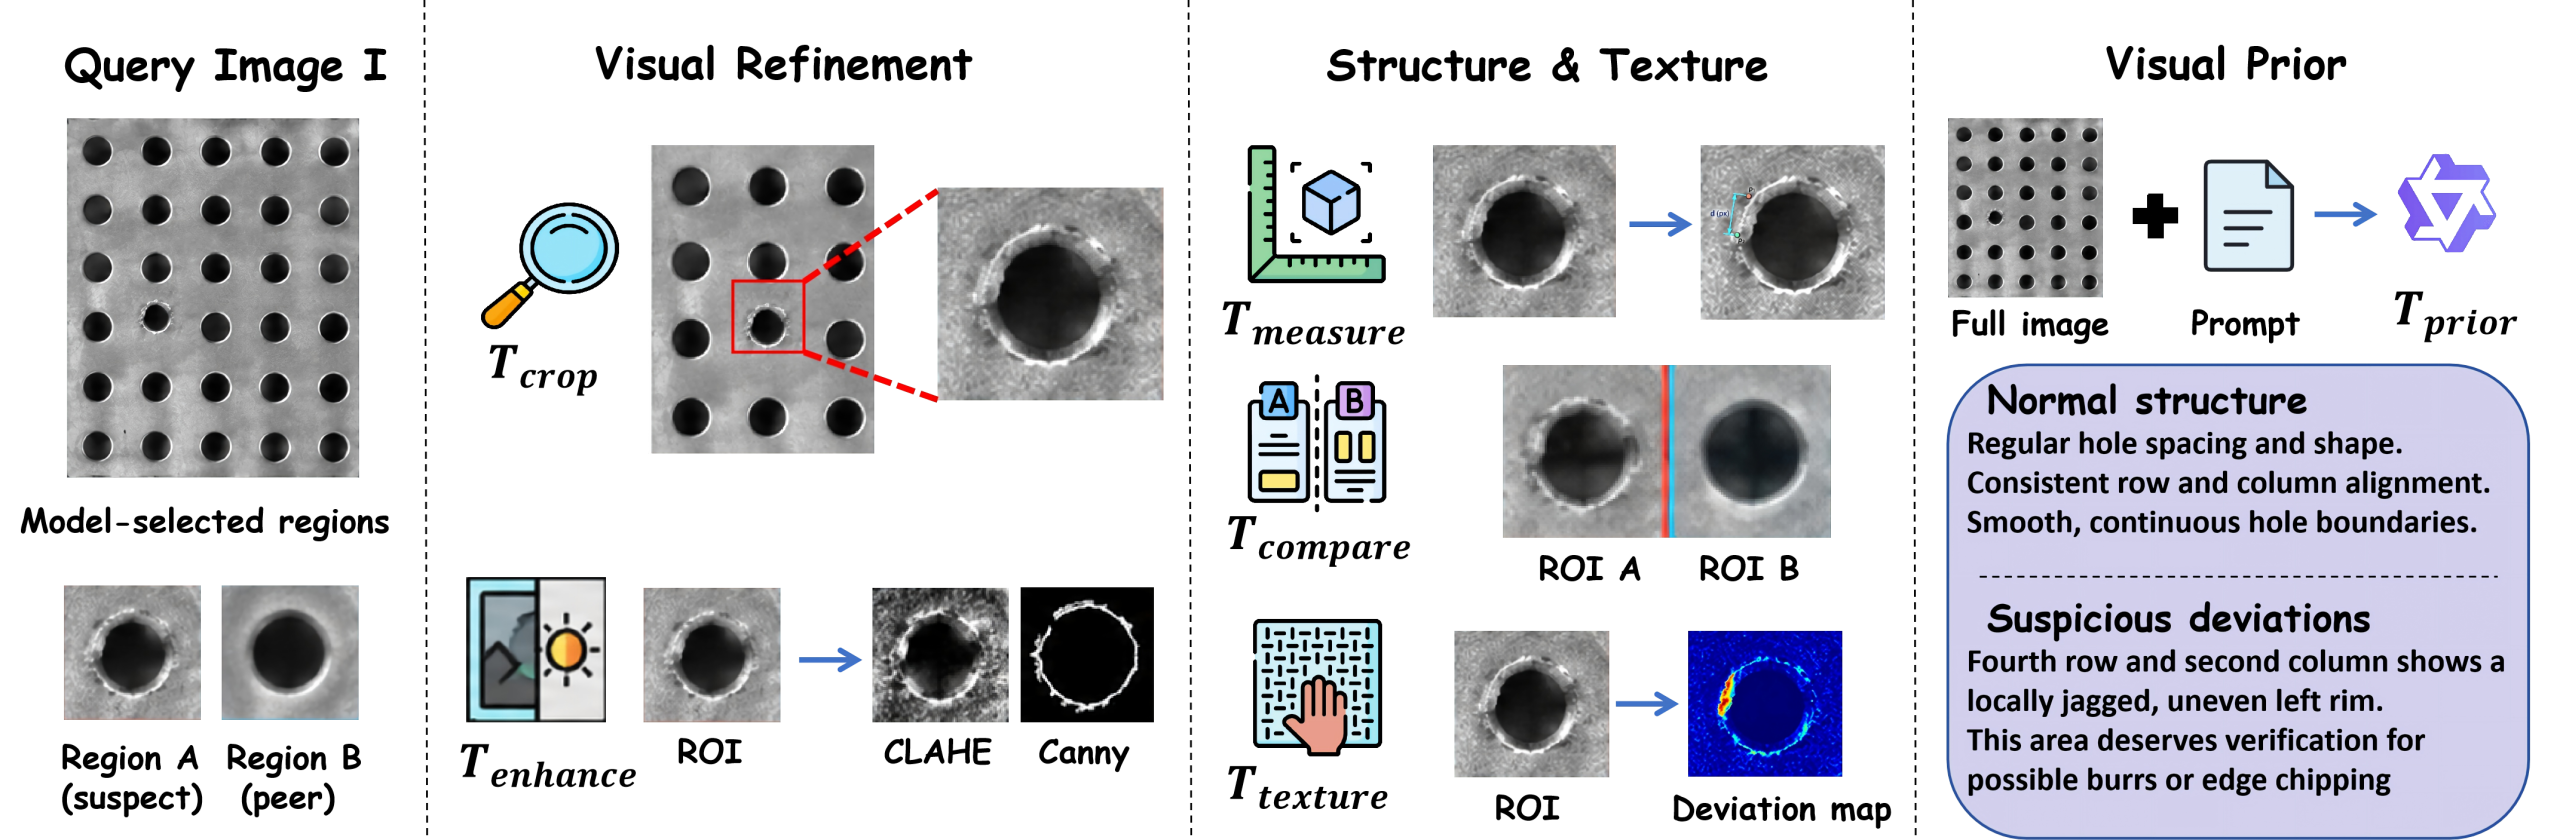
策略基座是 Qwen3-VL-8B。工具箱有六件:裁剪(Crop)取出模型选定的局部区域;增强(Enhance)用 CLAHE 与 Canny 算子凸显局部细节;测量(Measure)计算像素距离与角度;比对(Compare)在同一张查询图内对比相似区域;纹理(Texture)刻画局部纹理变化;视觉先验(Prior)调用 Qwen3-VL-Max 描述“正常结构应是什么样、哪些偏差需要核实”,但不给出是或否的结论。推理固定为两轮:第一轮给出初判并选择零个或多个工具调用,环境执行后返回图像或文本观察;第二轮结合观察给出最终诊断,若判异常还要给出原图坐标下的缺陷框与固定词表中的类型。没有选工具时,调用与观察列表为空,第二轮照常出结论。
用 3000 条轨迹教“怎么查”
训练数据 Indus-CoT 来自 Real-IAD 的 26 个品类,共 3000 条轨迹,正常与异常各 1500 条;与评测重叠的 4 个品类在建库前就被剔除,保证训练与评测品类不相交。教师模型在生成时不看真值、框、类型,也不看正常参照,只依据图像与指令选择工具并整合真实执行反馈;生成完成的轨迹再用标注筛一遍,才用于监督微调初始化。随后用 GRPO 做在线强化学习,优化两轮检查轨迹。
奖励闸门:答对才给过程分
这套方法最关键的设计是准确率闸门。若采用简单加和奖励,一条最终诊断错误的轨迹,仍可能因为中间字段碰巧与标注一致、或某次工具调用带来增益而拿到奖励,等于奖励了“看起来像在干活”。IndusAgent 把定位、类型与工具成本的奖励全部挂在最终诊断正确这一前提上:诊断错了,只剩独立的格式奖励;诊断对了,额外的工具调用才计成本。这样策略学到的是“用必要的证据换正确结论”,而不是“多调工具刷过程分”。
结果与启示
在五个工业异常检测基准上,IndusAgent 的平均平衡准确率为 83.5%,比直接调用 Qwen3-VL-Max 的 79.4% 高 4.1 个百分点;在三个训练随机种子下,带闸门的目标比参数量匹配的无闸门版本平均高 3.0 个百分点。这些提升不算惊人,但方向清楚:跨品类、无参照的质检,靠的是“会取证”的策略,而不是更大的模型。对产线而言,可复用的经验是三条:把检查动作做成有明确输入输出的工具;用真实执行反馈而不是模型自述来构造训练数据;让最终判定为所有中间步骤背书。
资料来源:IndusAgent: Agentic Reinforcement Learning for Cross-Category Industrial Anomaly Detection — arXiv(2026-05)。本文为技术要点整理/编译,非原文全文。