

把一个大模型直接塞进工业现场,先撞上三道墙:20–40GB 显存超过边缘与雾节点的 4–64GB 容量;1–5 秒推理延迟违反 100 毫秒级实时要求;云端 REST 调用又把机密制造数据送出工厂。SEMAS 的选择不是压缩一个大模型,而是把不同职责拆到边缘、雾、云三层,用 1–14B 的小模型承担领域任务。
三层各有各的智能体
边缘层通过 MQTT 接入原始传感器流,A1/A2 智能体做轻量特征提取与预过滤,把原始多变量读数压成特征向量;雾层 B/B1/B2/B3 智能体执行多样化集成检测与动态共识投票,输出异常分数与告警;云层 C 智能体负责可解释的维护响应生成,D 智能体用 PPO 持续优化全局策略,E 智能体做系统级监督。推理是异步、非阻塞的,云端的策略演化不挡住现场告警。
检测器也不是单一模型:B1 用离线训练的 Isolation Forest(污染率 0.32),B2 用 Isolation Forest、One-Class SVM、Local Outlier Factor、Elliptic Envelope 等五模型集成,通过多数投票聚合。共识层再按权重融合不同智能体的输出,权重与阈值都可以被云端策略更新。
三条反馈回路维持多时间尺度适应
局部反馈从雾层回到边缘:检测性能指标触发窗口大小、特征模式、采样率的快速重配,不经过云端,目标是亚秒级跟上局部漂移。全局反馈从云层下发到雾与边缘:演化智能体分发经过验证的策略更新,修改共识权重、告警阈值、LLM 提示模板与边缘预处理参数。第三条是雾到云的迭代循环:检测结果、响应评价与操作员反馈双向流动,用于实时策略细化与模型改进。三条回路把“一次训练、长期固定”的静态系统,变成可分段更新的系统。
结果:快两个数量级,但准确率不是全面胜出
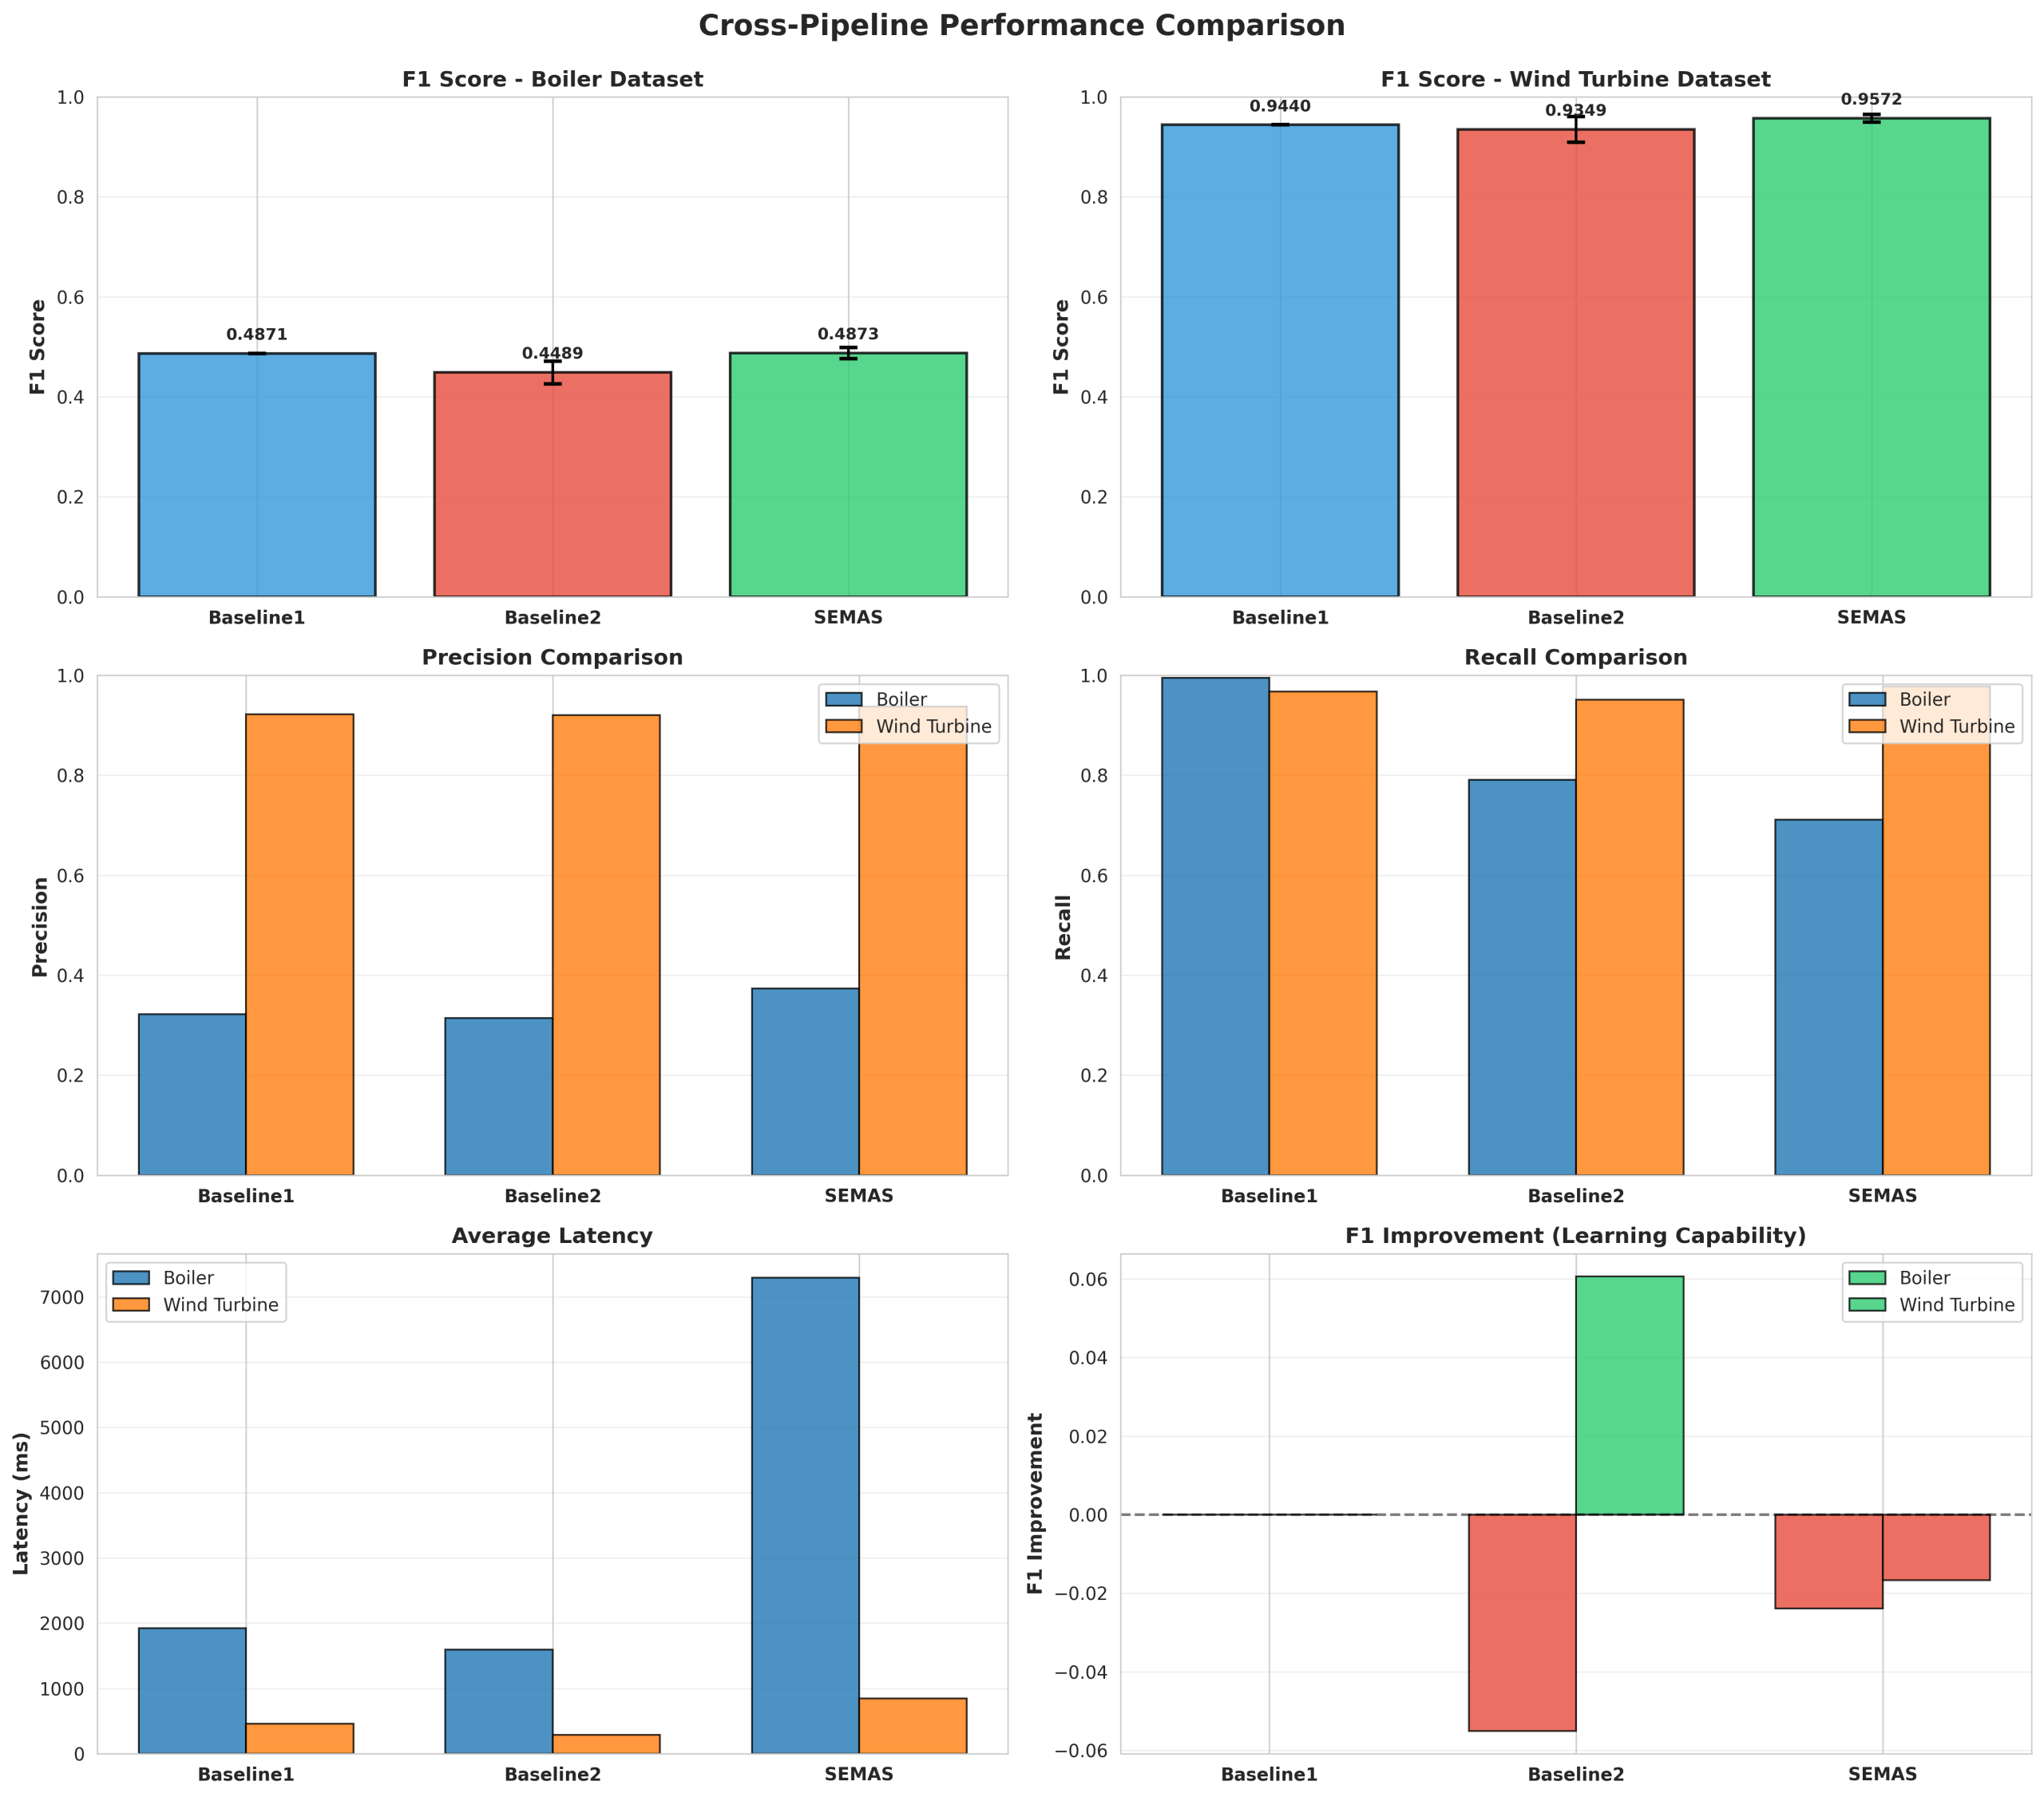
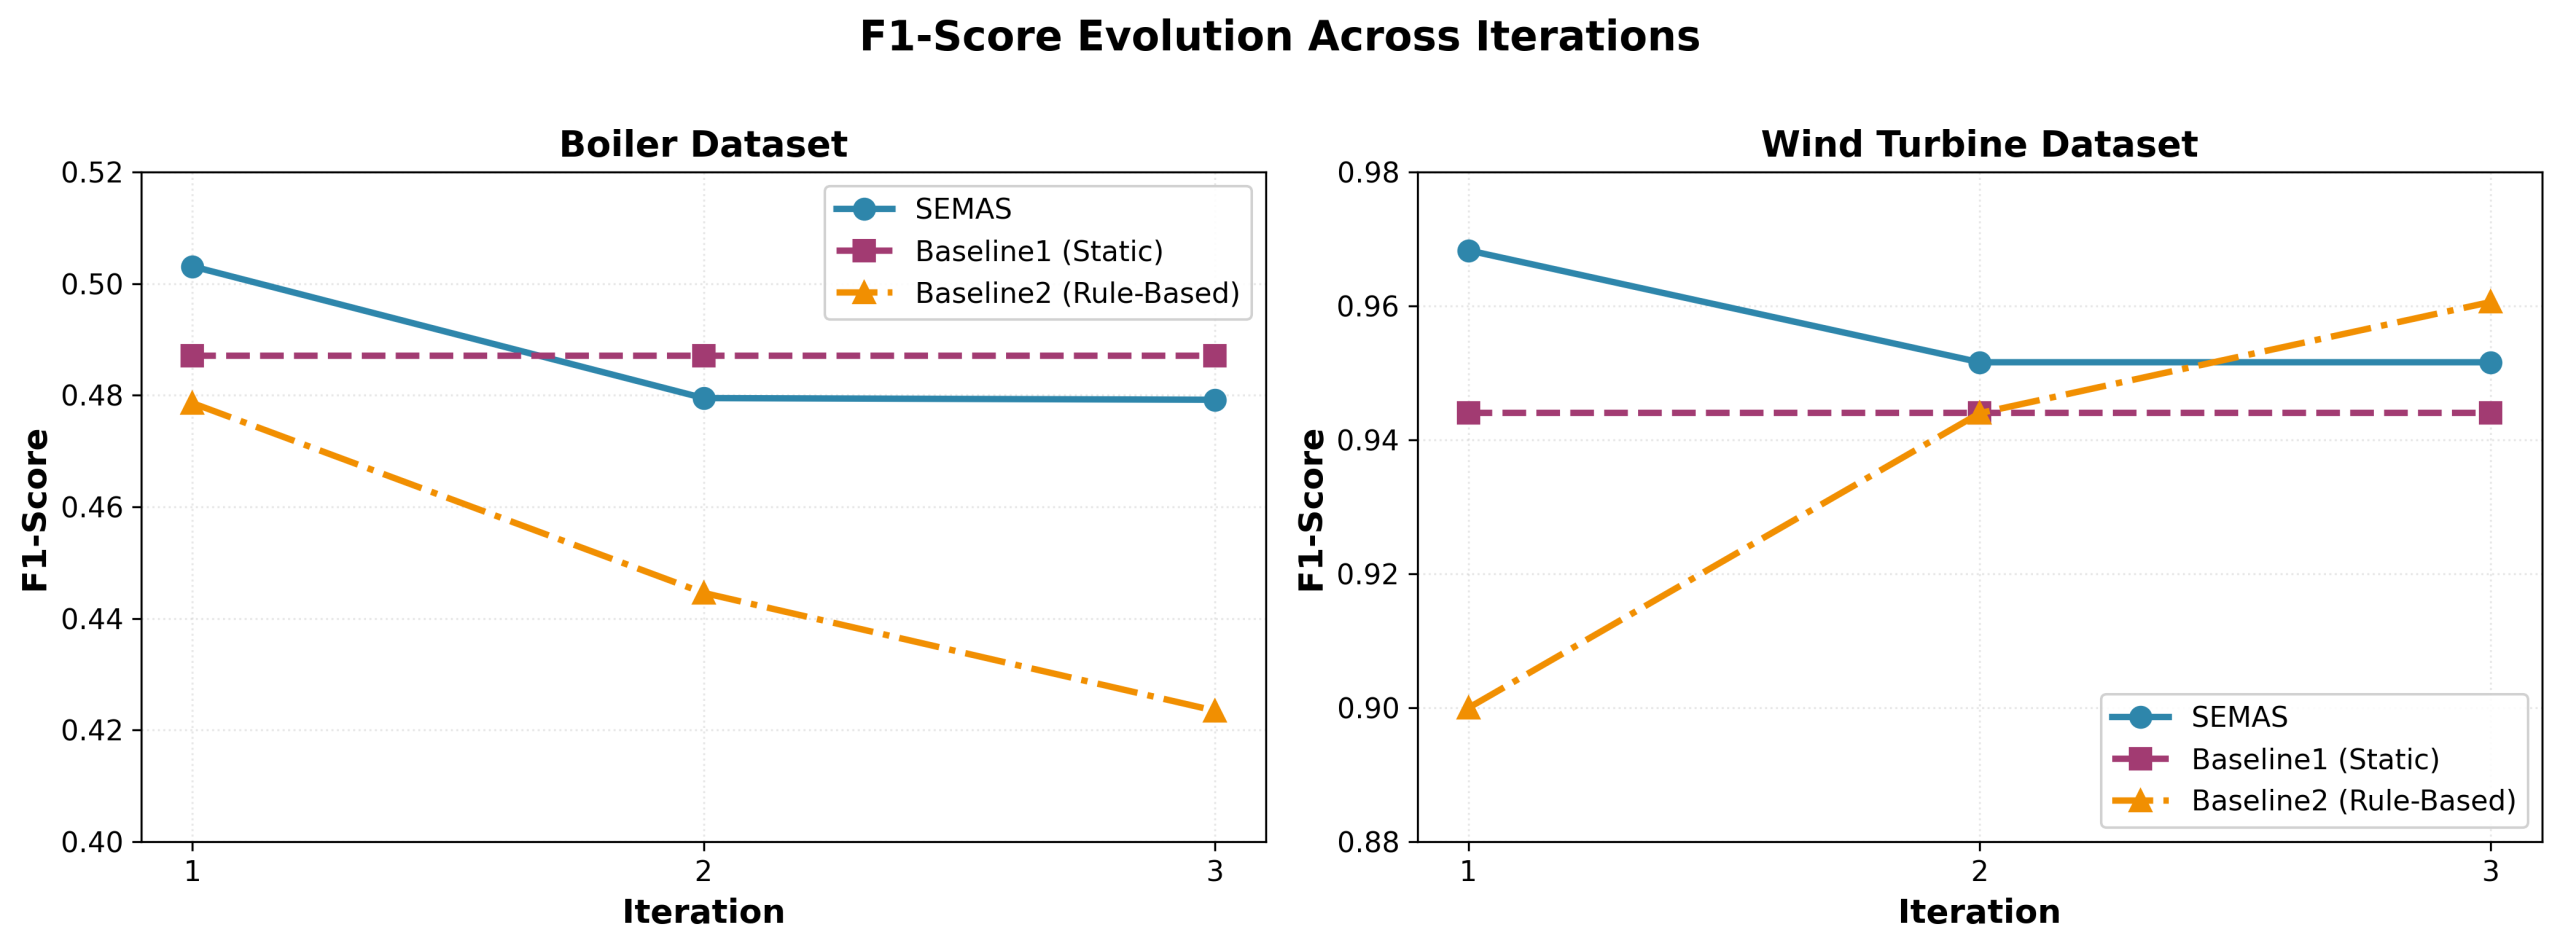
在两个工业数据集上:锅炉仿真器 10,000 个样本、异常占比 36.8%,风机 IIoT 500 个样本、故障占比 45%。SEMAS 的最佳 F1 分别为 0.4873 与 0.9571;相对规则式自适应基线,锅炉上高 8.6%(t=4.21,p<0.001,d=2.1);但相对调得很好的静态基线,锅炉上 ΔF1 仅 0.0002(p=0.94),没有统计显著优势。它的强项在效率与稳定性:延迟 0.30–1.22 毫秒,对比基线的 286–1923 毫秒,约 200–1500 倍加速;学习轨迹上,锅炉 ΔF1 为 −0.0239、风机 −0.0166,而规则式基线在锅炉上退化 −0.0550(−11.5%)。
消融显示各部件都有贡献:共识投票影响 6.5% 的 F1,PPO 优化 3.5%,联邦聚合 2.0%;LLM 解释获得 82% 的操作员接受度,基线为 41%。代价是冷启动:新设备初始化约需 8 小时,作者把迁移学习列为高优先级,目标是用同类设备的预训练策略把冷启动压到 30 分钟以内。另一项限制是当前“联邦”只是参数聚合的轻量替代,并非带差分隐私的真联邦学习。
启发
这套架构的可迁移经验不是“用小模型”,而是按资源与时间尺度分配职责:需要毫秒级反应的部分留在边缘,需要跨设备共识的部分放在雾层,需要全局优化与解释的部分放云端。若把三层都塞进一个单体智能体,延迟、显存与数据边界会同时成为瓶颈。
资料来源:Self-Evolving Multi-Agent Network for Industrial IoT Predictive Maintenance — arXiv(2026)。本文为技术要点整理/编译,非原文全文。