

工业维修的困难不是没有数据,而是证据彼此错位:工单是自由文本,仪表是低频、语义各异的读数,FMEA 又常常停留在工程文档里。直接把大模型接上 CMMS,得到的往往是流畅但无法追溯的解释。Condition Insight 的做法是先把证据做成结构化包,再让模型在约束内说话。
两段式:确定性造证据,LLM 做解释
第一阶段是分析与证据构建,产出 asset_facts:工单抽象从历史记录中抽取反复出现的症状、干预与结果,形成维修经验模式;仪表抽象按语义把累计型、增量型、分类型读数转成趋势、变点、复位、漂移与异常模式,而不是把原始读数直接丢给模型;失效知识对齐则把工单描述与 FMEA 中的失效机理、退化模式嵌入同一向量空间,用非平衡最优传输(UOT)计算分布级匹配,构造“观察行为—工程失效语义”的假设空间。整个阶段是确定性的,输出可审计。
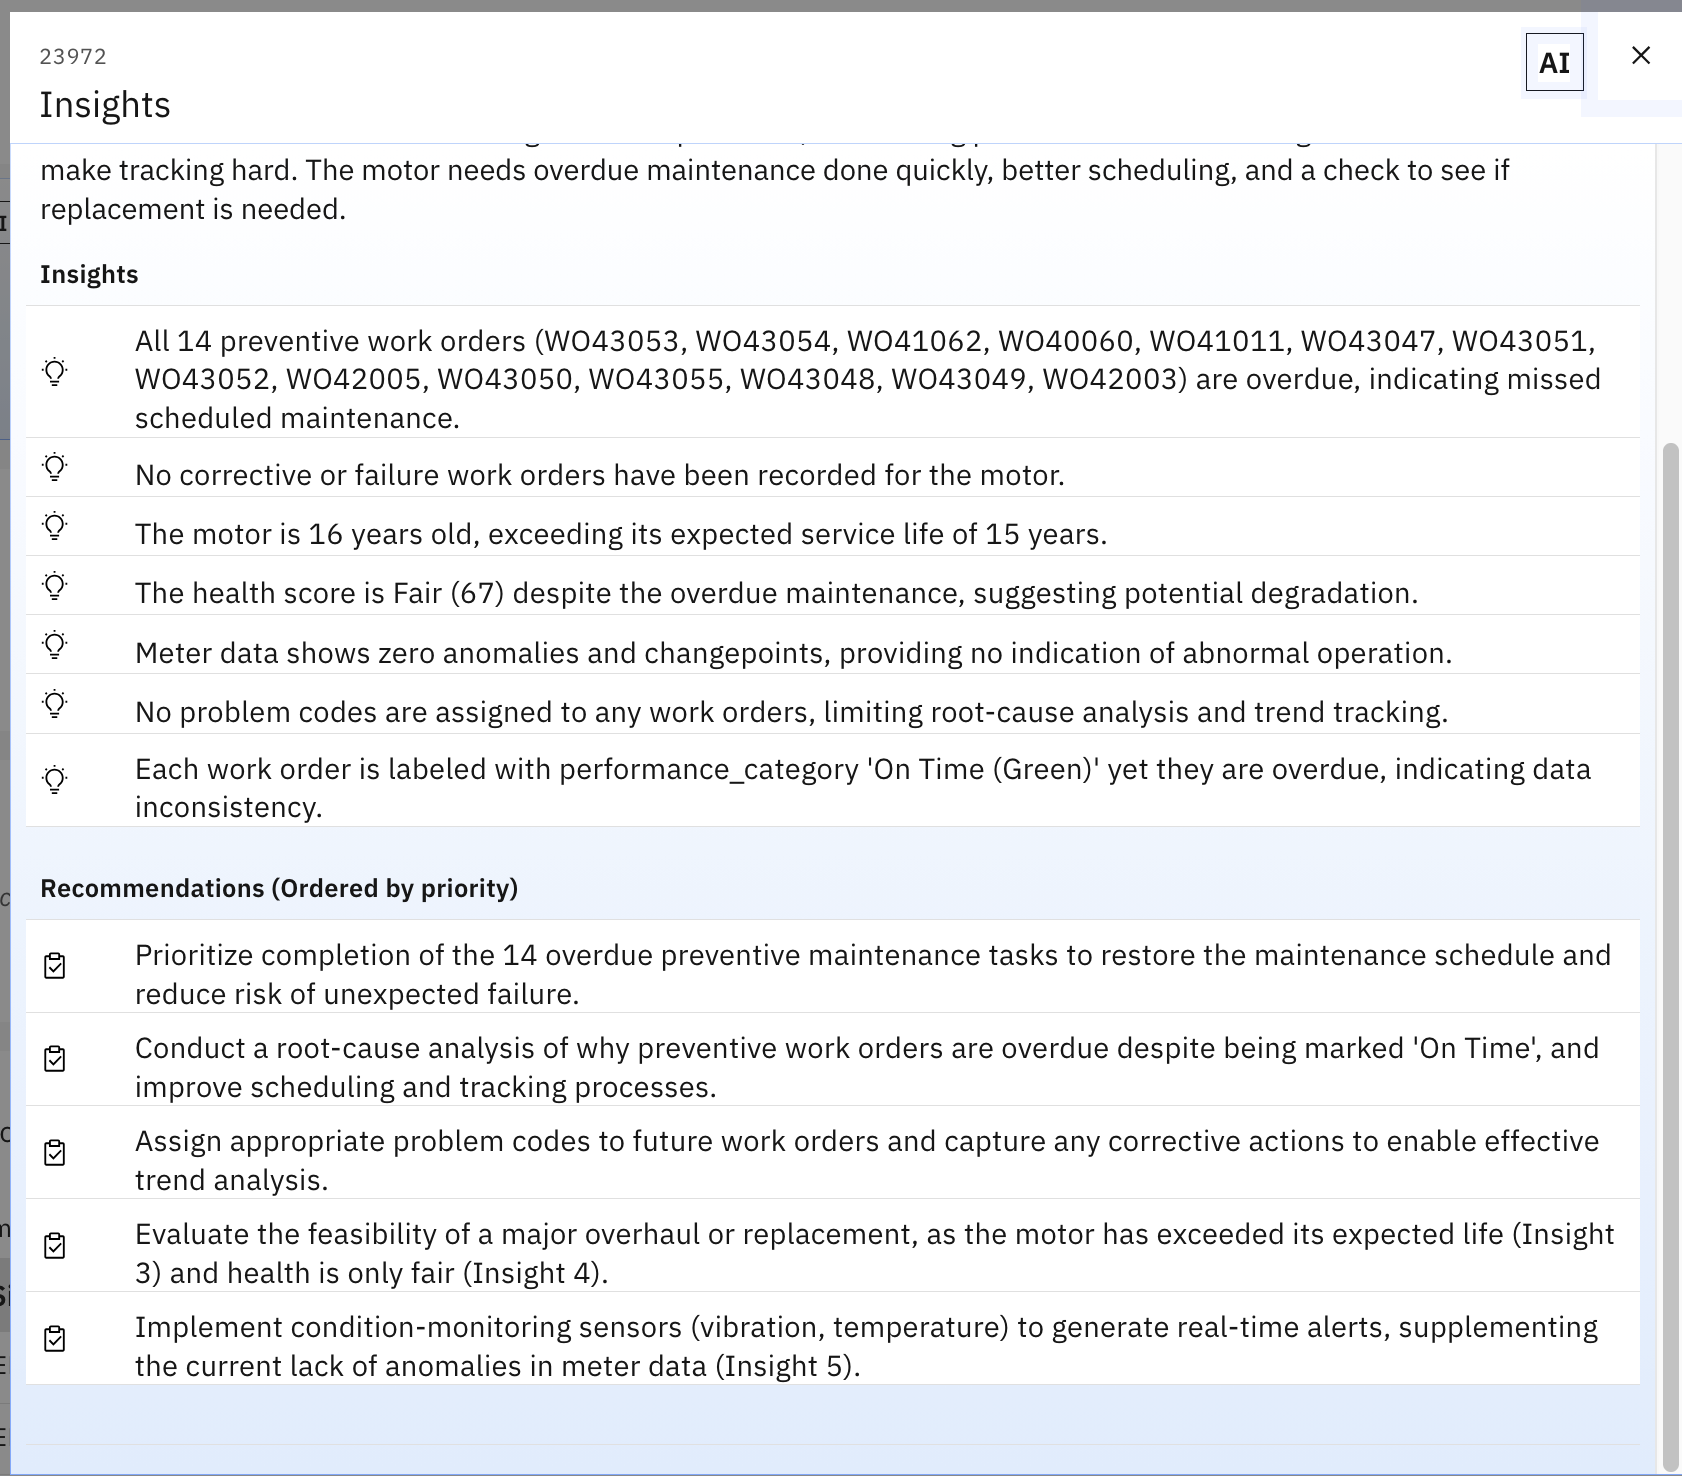
第二阶段才是受限的 LLM 推理。模型读取证据包,输出 Condition Insight Summary:有证据支撑的洞察与建议。关键不是让模型自由发挥,而是把解释限制在证据与失效语义允许的范围内。
生成之后,必须过一道规则校验
系统要求模型给出总体状态类别:Normal、Needs Attention 或 Not Enough Data。与此同时,一条并行的确定性管线用同一套准则计算:未关闭或延迟的工单、紧急干预、告警、仪表异常。两条路径的结果逐项比较,差异被用来识别推理错误并回改提示词;没有证据支持的结论会被修订或直接抑制。建议始终是建议性的,不触发自动动作,人在回路保留最终判断。
这套“生成—校验”分离解决的是可靠性问题:LLM 负责把证据组织成可读的因果叙述,规则负责守住分类与安全边界。它不追求让模型替人决策,而是把模型限制在一个可验证的推理包络里。
企业级部署的数字
案例 A 作为企业 CMMS 的早期访问能力上线,只使用现场可用的生产数据;案例 B 覆盖约 1,500 台资产、16 个资产类别、14 个站点。相当一部分资产被归入 Not Enough Data,这是稀疏证据下的保守行为;类别分布在站点间保持稳定,说明阈值没有过拟合局部条件。被标为 Needs Attention 的资产,洞察能对应到具体失效机理与资产类别历史。
效率上,传统条件分析要在一个资产上花约 20–30 分钟:CMMS 查维修记录约 5 分钟,楼宇管理系统看传感器与 SCADA 约 10 分钟,再到外部分析或 IoT 平台看告警、趋势与元数据 10–15 分钟。框架把单资产分析压到约 15–30 秒。人工验证仍不可少,但证据整合的负担被大幅削减。
评估还给出一个反直觉结论:效果主要由证据结构与提示约束决定,而非骨干模型。证据从“工单+资产画像”扩到“仪表抽象+失效知识”后,无支撑陈述率 UCR 从 0.007 降到 0.003;约束提示把规则一致率 CAR 从 0.68 提到 0.89(有限证据),从 0.70 提到 0.91(完整证据),同时把平均洞察数 MIC 从 4.9 降到 3.2。矛盾率与冗余率在所有配置下都接近零。测试过 Mistral-Medium、LLaMA-4-Maverick、Granite 与 GPT-OSS 等骨干,差异相对架构因素更小。
可复用的原则
对工业智能体而言,“先造证据”比“换更强模型”更划算:把工单、仪表与失效知识整理成模型能读、审计能追的结构,再让规则与模型分工。Condition Insight 的边界也很清楚——它做优先级排序与解释,不做自动执行;数据不足时宁可说“不够”,也不硬给结论。
资料来源:Evidence-Driven Reasoning for Industrial Maintenance Using Heterogeneous Data — arXiv(2026)。本文为技术要点整理/编译,非原文全文。