

FFF 打印的切片参数看上去合法,并不代表程序安全:温度、挤出、冷却或附着设置可能在几何不变的情况下把零件做废。LLM-ADAM 把“打印前审查”做成一个可审计的三段式智能体流程,输入是 G 代码与打印机/材料手册,输出是缺陷类别和理由。
三个角色,一条确定性中轴
Extractor–LLM 先把 G 代码映射到固定的工艺参数 JSON 模式,覆盖热设置、挤出量、层高、线宽、喷嘴与耗材几何、回抽、空移、风扇策略和附着设置;缺失字段显式记为 null。Reference–LLM 再把对应打印机与材料的手册转成同一模式的推荐区间。两者之间是确定性比较层:逐参数计算数值、上下界、带宽和偏离方向,生成偏差表。Judge–LLM 最后拿到参数、区间、偏差表与 G 代码证据,只做证据整合,输出类别、置信度、依据与引用。
这个分工是“模型与机器无关”的:打印机、材料、缺陷集合乃至各阶段的模型供应商都可替换。论文在 Prusa MK4S 与 Bambu Lab P1S 两种机型、PLA 与 ABS 两种材料上验证,缺陷分为无缺陷、欠挤出、过挤出、翘曲和拉丝五类。
为什么把算术拿出来
单个提示词要同时完成参数抽取、手册回忆、数值比较和分类,任务异质,模型很难每项都强。LLM-ADAM 把数值比较外置为确定性中间产物,让最后一次模型调用从“读长代码”变成“整合证据”。G 代码过长时,预处理器只保留配置块、初始化序列、前三层与最后一层的指令,既控制上下文成本,也保留最可能暴露设置错误的片段。抽取后还有单位归一化,避免不同切片器与机型因单位不一致而误判。
这种拆分带来的不只是准确率,还有可定位的失败模式:错误可以追到抽取、手册解释、数值比较或最终判断中的某一环。Reference 阶段按“机型—材料”成对构建,而非每个文件重复构建;抽取产物可以留档复现。
实验:28 个百分点的差距来自结构
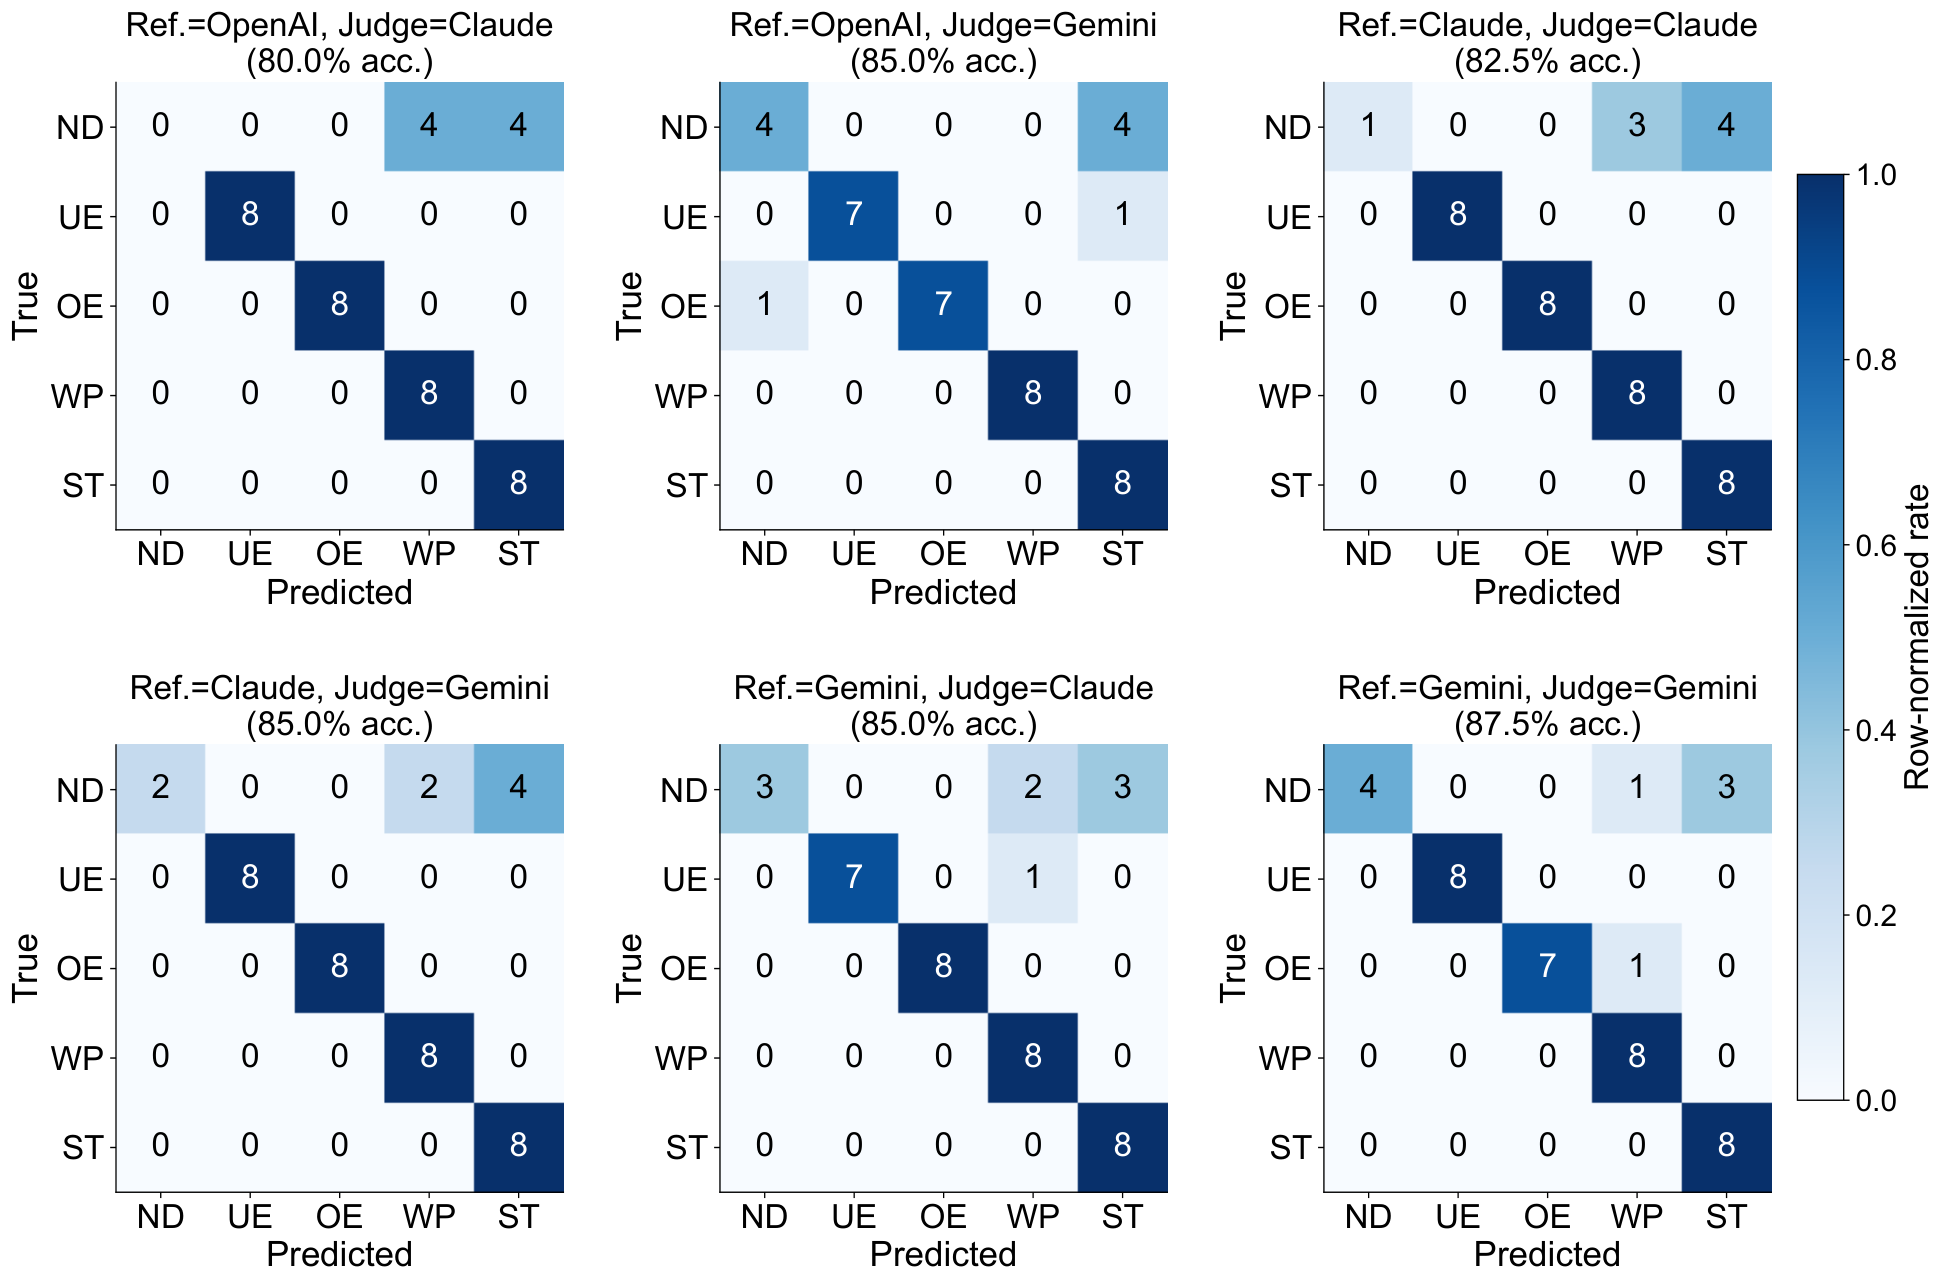
先用 3×3 的 Reference–LLM × Judge–LLM 网格在 40 个样本上做模型选择,再到 200 个样本的完整语料上评估。结果显示 Judge 角色主导端到端结果:以 Gemini 为 Judge 的列平均为 85.8%,Claude 为 82.5%,OpenAI 为 72.5%;Reference 行的差异反而较窄(79.2%–81.7%)。
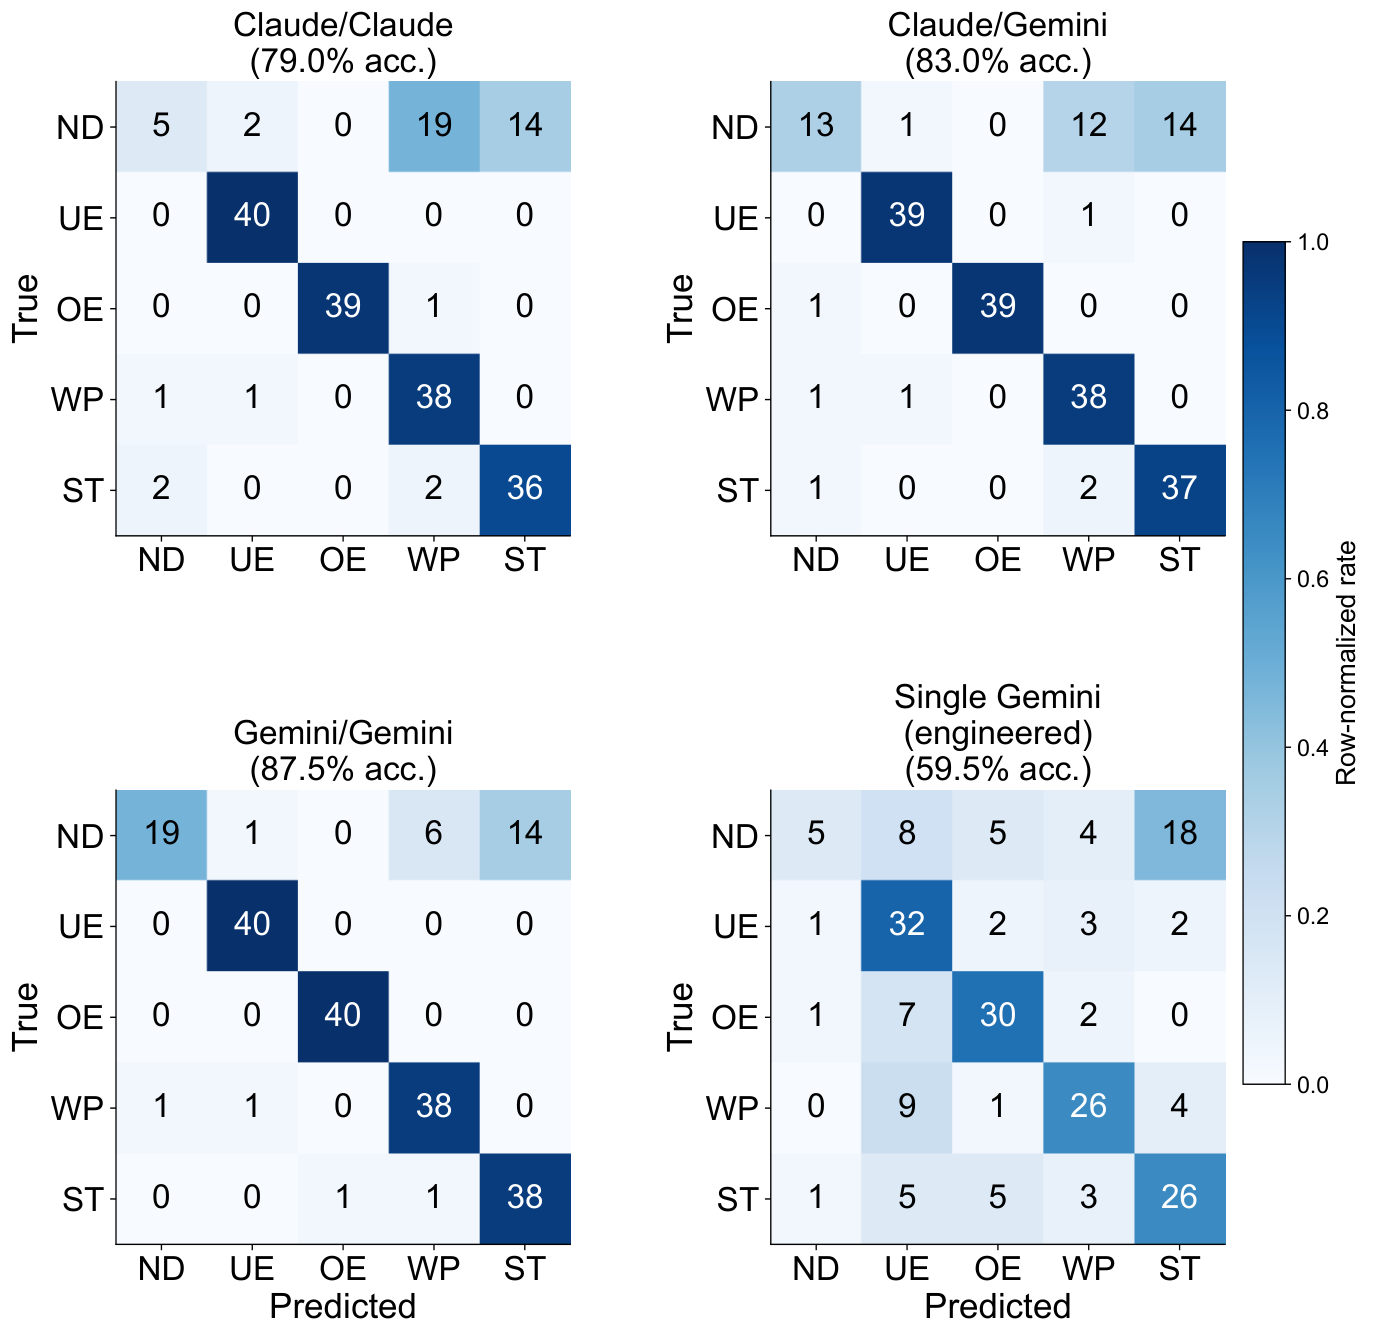
完整语料上,Gemini–Gemini 达到 87.5%,Claude–Gemini 为 83.0%,Claude–Claude 为 79.0%;经过提示词工程的最强单模型基线为 59.5%,差距 28.0 个百分点。四个机型—材料组合分别为 80%、88%、90%、92%,对应基线为 68%、52%、56%、62%。剩余错误主要集中在“无缺陷”类的保守误报:系统宁愿把边界样本标成翘曲或拉丝,也不轻易放行;对打印前筛查而言,误报可转人工复核,漏检则可能浪费材料与机时。
边界
这套方法依赖可获得的机型与材料手册,因此牺牲了一部分自主性;它目前只能识别并解释异常,不能自动修改切片参数或 G 代码。论文也提醒,结论应理解为“任务分解有效”,而不是某个模型供应商更强。对工业软件来说,真正可复用的部分是把手册、程序与判定拆成可审计的接口,而不是再写一条更长的提示词。
资料来源:LLM-ADAM: A Generalizable LLM Agent Framework for Pre-Print Anomaly Detection in Additive Manufacturing — arXiv(2026)。本文为技术要点整理/编译,非原文全文。