
用仿真做排产优化,最常见的做法是把仿真器当黑盒:提交一组策略,得到一个0到100的总分,然后靠搜索算法换参数。分数能排序,却不告诉你为什么丢分、该改哪一行逻辑。arXiv上的这篇论文换了个用法:让大模型读事件级仿真轨迹,自己提出瓶颈假设,再直接改调度策略的代码。
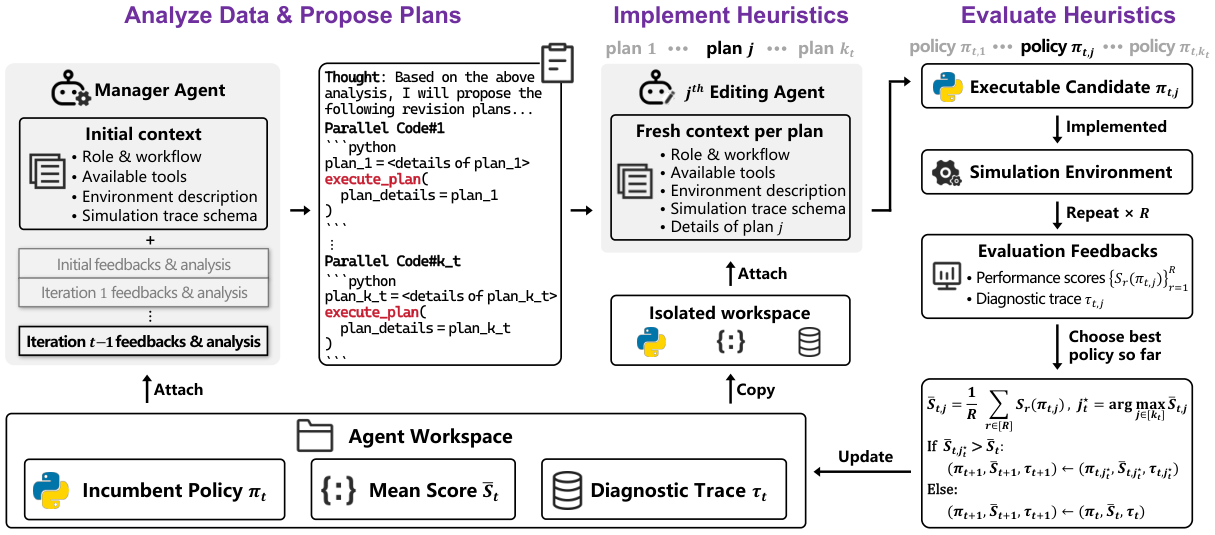
经理提假设,编辑改代码
框架把“评估”和“诊断”分开。每个候选策略跑R=10次独立复现取均分,同时把得分最低的那次复现重放,生成一份可查询的轨迹数据库——包含订单事件、资源状态变化、队列与缓冲区、AGV任务与充电、故障与恢复,以及各项指标随时间的取值。经理智能体(manager agent)据此提出瓶颈假设;多个编辑智能体(editing agents)并行产出代码级修改;候选先过执行检查,再重复评估,只有超过现任者均分才晋级(best-so-far)。大模型只在两批评估之间动手,单次仿真内部仍由固定策略控制,保证可复现。
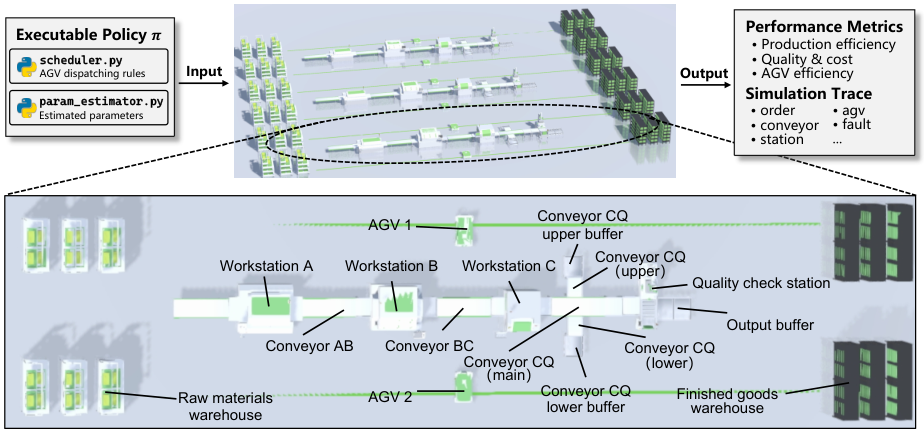
案例是一个三条产线的离散事件模型,改造自FreezoneX 2025智能工厂调度环境:工位、输送带、缓冲区、质检、仓库、AGV俱全,还有动态订单、返工、充电和随机故障。策略由产线选择、运输任务排序、AGV分配、充电四组可执行规则组成。仿真把八项绩效归一化后加权成总分,生产效率、质量成本、AGV效率三组权重分别为40%、30%、30%。默认仿真时长500分钟,订单每10分钟到达。
轨迹指出的四次转向
得分最高的一次Gemini-3.1-Pro运行,从初始策略62.49分爬到78.61分,十轮迭代提升约25.8%。第一轮诊断很具体:AGV几乎不主动充电,总是耗尽电量后被强制充电;到达任务起点前的空驶也太多。于是候选策略加入“就近任务优先”,并让低电量的空闲AGV主动去充电,均分升到70.28。第二轮,充电改善后轨迹显示产出仍低、返工流转延迟,智能体转而提高“清空下游缓冲区、让产品更接近完工”的任务优先级,同时继续调空驶惩罚和充电阈值,第五轮达到75.98。之后又出现新问题:策略过度偏向下游,上游工位拿不到新料。智能体再平衡前段供料与下游清空,第八轮达到78.61;最后两轮只做小幅数值调整,没有超过现任者。
比MILP、135种规则组合和元启发式都高
基线包括滚动混合整数规划(MILP)、135种规则组合的穷举,以及GA、DE、PSO在规则组合空间上的搜索,最好成绩都在六十出头。五次独立运行,Gemini-3.1-Pro的最终均分平均77.51。更严格的检验是100个配对随机种子:最佳策略在每一个种子上都优于各基线代表,并通过双侧配对Wilcoxon检验(Holm校正);在加入随机设备故障、不重新优化的情况下仍保持优势;把仿真时长拉到3000分钟、订单间隔改为5–15分钟均匀分布后重新优化,结果同样领先。
消融也诚实:每轮只生成一个候选时,最好一次仍达78.56,但最差从76.10掉到62.36(GPT-5.4-mini从70.94掉到62.29),平均迭代数从9.2降到5.8;关掉轨迹数据库、只留聚合KPI,成绩也下降。可见稳定的提升来自“并行试错+能查证的轨迹”,而不是某次灵光一现。
对工厂的启示:仿真器不缺,缺的是把“分数低”翻译成“哪条规则错了”的中间层。轨迹就是这层翻译。
资料来源:LLM-Guided Heuristic Design from Simulation Traces: A Case Study in Dynamic Production and AGV Scheduling — arXiv(2026)。本文为技术要点整理/编译,非原文全文。