
制造即服务(MaaS)场景里,用户往往只说目标,不说工艺细节。论文提出一套意图驱动框架:微调过的指令模型把自然语言意图翻译成结构化 JSON 需求模型,再映射到符合 ISA-95 的 Neo4j 知识图谱,取出相关子图并更新关系属性,让后续系统能对结构化需求做推理,而不是猜一段模糊文本。
三步流水线
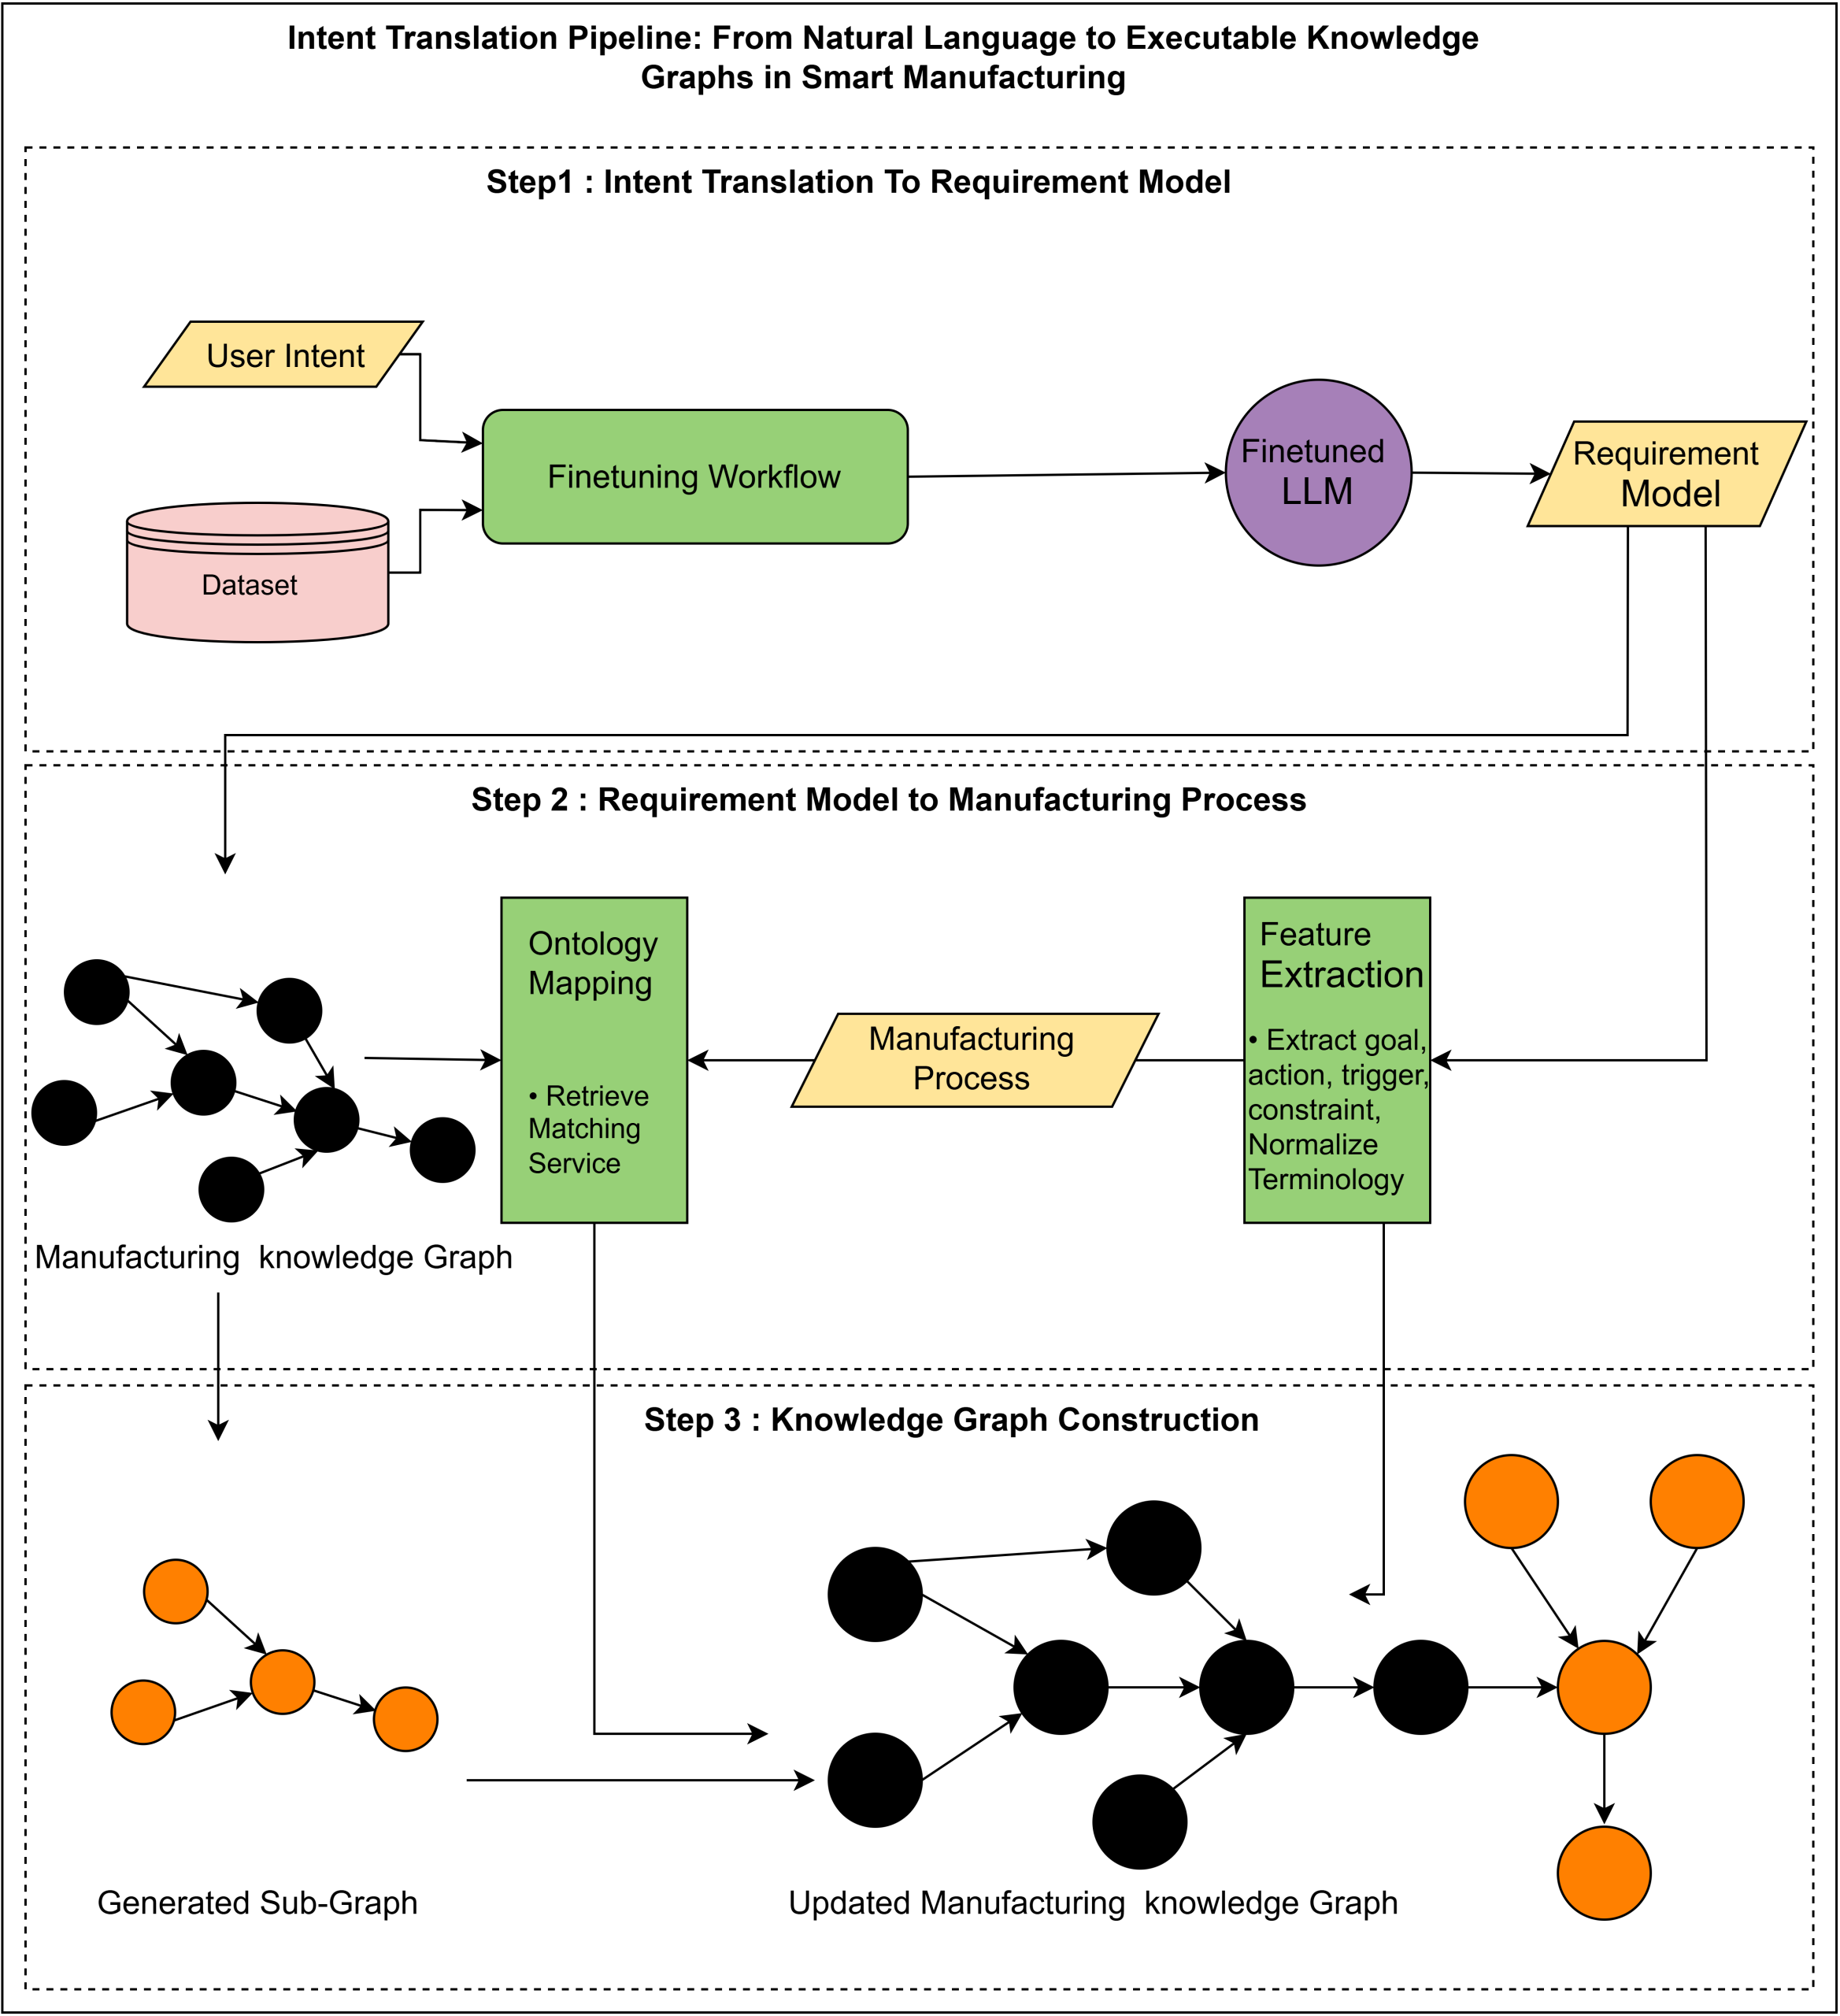
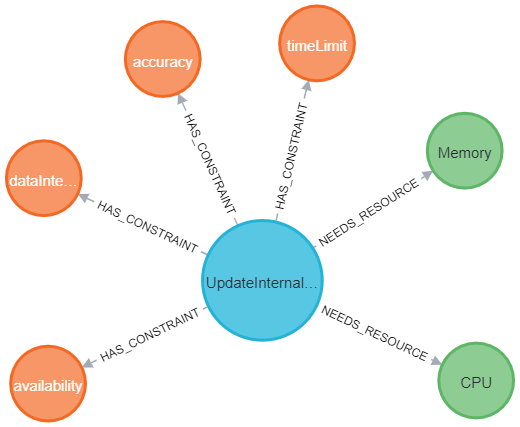
第一步,意图翻译。用户用自然语言表达运营目标,系统通过指令提示让微调后的 LLM 生成 JSON 需求模型,字段包括目标、模式、触发条件、动作以及约束。论文给出的例子是“5 秒内自动更新内部车队计划,准确率至少 99.9%,数据完整性 100%,可用性 99.99%,CPU 与内存占用不超过 65%”。第二步,需求模型到制造过程:抽取目标、动作、约束等语义成分,用检索—匹配机制对齐制造过程本体。第三步,知识图谱构建:把过程模型转成知识子图并合并进全局图谱,用 Cypher 查询子图、更新关系属性。
本体只有三类核心实体
图谱本体围绕 ISA-95 设计,核心实体是制造过程(MP)、制造资源(MR)与过程约束(PC)。制造过程是基本单元;制造资源覆盖原材料、生产设备、人员,也包括 CPU、内存这类计算资源;过程约束则声明参数、约束与 KPI,描述过程的行为、性能期望和质量标准。本体声明过程与资源之间的映射,表示执行任务所需的依赖;每个过程再关联约束,从而把 MaaS 环境中的制造操作准确表达出来。给定意图后,系统查询图谱实例,既取回相关实体与关系,也更新这些关系的属性值。
小模型 + 轻量微调
底座选 Mistral-7B-Instruct-v0.2,理由是结构高效、结构化输出稳定、适合资源受限的微调:滑动窗口注意力与分组查询注意力降低长上下文计算成本,4 位量化配合 LoRA 只更新注意力层中的少量参数,基础模型保持冻结;训练用 2×10⁻⁴ 学习率,数据按 90% 训练、10% 评估划分。数据集由团队自建,共 2,580 条标注样本,覆盖内部车队计划更新、空箱请求、动态集装箱路径优化三类过程,意图由模板加 AI 改写扩展,再由熟悉工业运营的标注者人工校验。
结果:89.33% 精确匹配
模型在第 6 个 epoch 达到最高准确率 97.29%,此后验证损失趋平、准确率回落,出现早期过拟合迹象,因此第 6 轮作为停止点。与零样本、少样本基线相比,微调模型在 JSON 合法性、精确匹配与约束抽取等指标上全面领先:精确匹配 89.33%,总体准确率 97.27%。按字段看,多数键的 F1 接近 1.00,只有可用性等约束因表述差异略低(0.86);推理时间随批大小线性增长,平均每样本 54 毫秒,具备实时部署的潜力。
边界在哪里
这套方法把“意图”变成可查询的图结构,价值在于可解释与可复用:JSON 需求模型可审计,子图抽取把执行范围限定在相关实体上。但它仍是受控数据集上的结果,真实工厂语言的歧义、跨本体对齐与权限控制尚未覆盖;论文也把与知识图谱的深度联动列为后续工作。
资料来源:Intent-Driven Smart Manufacturing Integrating Knowledge Graphs and Large Language Models — arXiv(2026)。本文为技术要点整理/编译,非原文全文。