

供应链问题常常不是查一条资料就能回答。“哪些特斯拉部件用到澳大利亚矿区的锂?”没有任何一份文档写着答案;证据散落在采矿承购协议、企业申报、电池供应商公告与行业分析里,需要跨层级拼接。传统检索增强系统只是把网页摘要拼成一段话,既没有结构,也说不清每条结论有多可信。
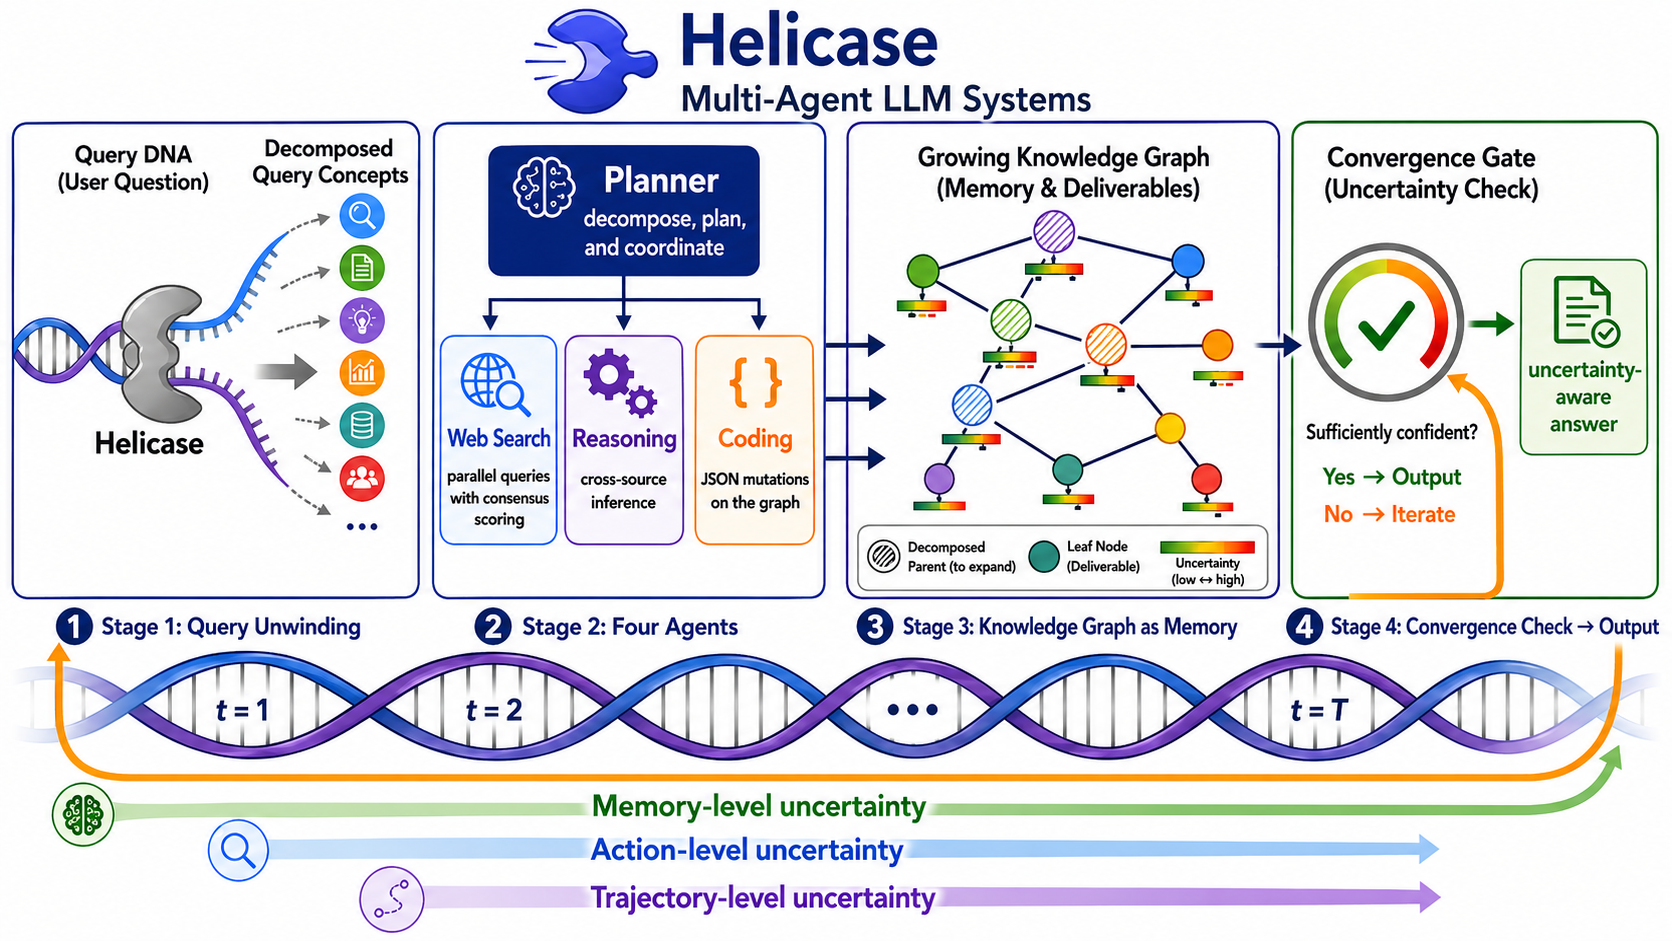
Helicase 把这类问题当成“结构推断”:让多智能体自主搜索、抽取、建图,并给每条事实标注不确定性。它的主张是,供应链情报要从“被动检索”转向“主动、带置信度的图发现”。
螺旋循环:规划器决定下一轮查什么
规划器在顶层,先把查询拆成初始动作集,之后每一轮都根据当前知识图谱与不确定性分布,生成瞄准高不确定区域的新动作。三类执行智能体并行:网页搜索智能体做多查询、多来源的证据检索与抽取,覆盖静态 HTML、PDF 报告(监管申报、可持续报告、风险披露)、表格记录(CSV/Excel 供应商目录、贸易媒体排名)以及社交平台上的供应商公告与断供预警,每种模态先由专用 reader 归一化;推理智能体综合证据、做跨源推断,判断该更新哪些结构;编码智能体把决定写成确定性的 JSON 变更,创建、合并或修订节点与边,并用模糊实体匹配防止重复。
规划器与执行智能体由一个“螺旋”闭环绑定:每轮把当前图与不确定性态势反馈给规划器,驱动下一轮动作,直到不确定性停滞并发出收敛信号。不断演化的图既是调查的结构化记忆,也是最终答案的容器。
三层不确定性,各有各的算法
动作层衡量单次执行是否可靠。网页搜索智能体并行发出多条查询,再由大模型对返回结果做事实共识打分:事实、实体、数量一致则低不确定,部分重叠有缺口则中等,互相矛盾则高。论文特意不用向量相似度——段落级文本的余弦值几乎总是接近 1,会把风格差异误当成事实一致。
轨迹层用嵌入相似度对比历史动作,判断系统是在发现新信息还是在重复劳动。记忆层把图中每条事实的不确定性做乘性累积,再聚合成 [0,1] 的系统级置信度,0 表示完全确信,1 表示完全不确定。
这些数字不是摆设,直接进入策略:并行查询数在 1 到 10 之间动态调整,目标不确定度超过 0.3 就加查;高不确定事实阈值 0.7;冗余标记阈值 0.8;相对变化低于 5% 且连续 3 轮停滞即收敛;常规上限 10 轮,最难象限放宽到 20 轮。图级 F1 按实体 0.6、关系 0.4 加权。
80 道题,四个象限
SCQA 基准把 80 道题按“推理复杂度 × 信息可见度”分成四象限,每格 20 题:单跳/多跳,高可见/低可见。低可见不是机密,而是公开却难找、需要跨源推断的信息,例如某连锁快餐的薯条土豆主供应商,或某日化企业含两种活性成分的护发产品及其共同供应商。
对照系统包括 Claude Opus 4.6、Qwen3-235B-A22B、DeepSeek-V3.2、GLM-5 的直接提示,以及带 Serper 搜索与 Jina 读页的 ReAct、思维树。结论是前者在四象限的答案准确率上都明显落后,且只有 Helicase 同时给出可校准的不确定性。
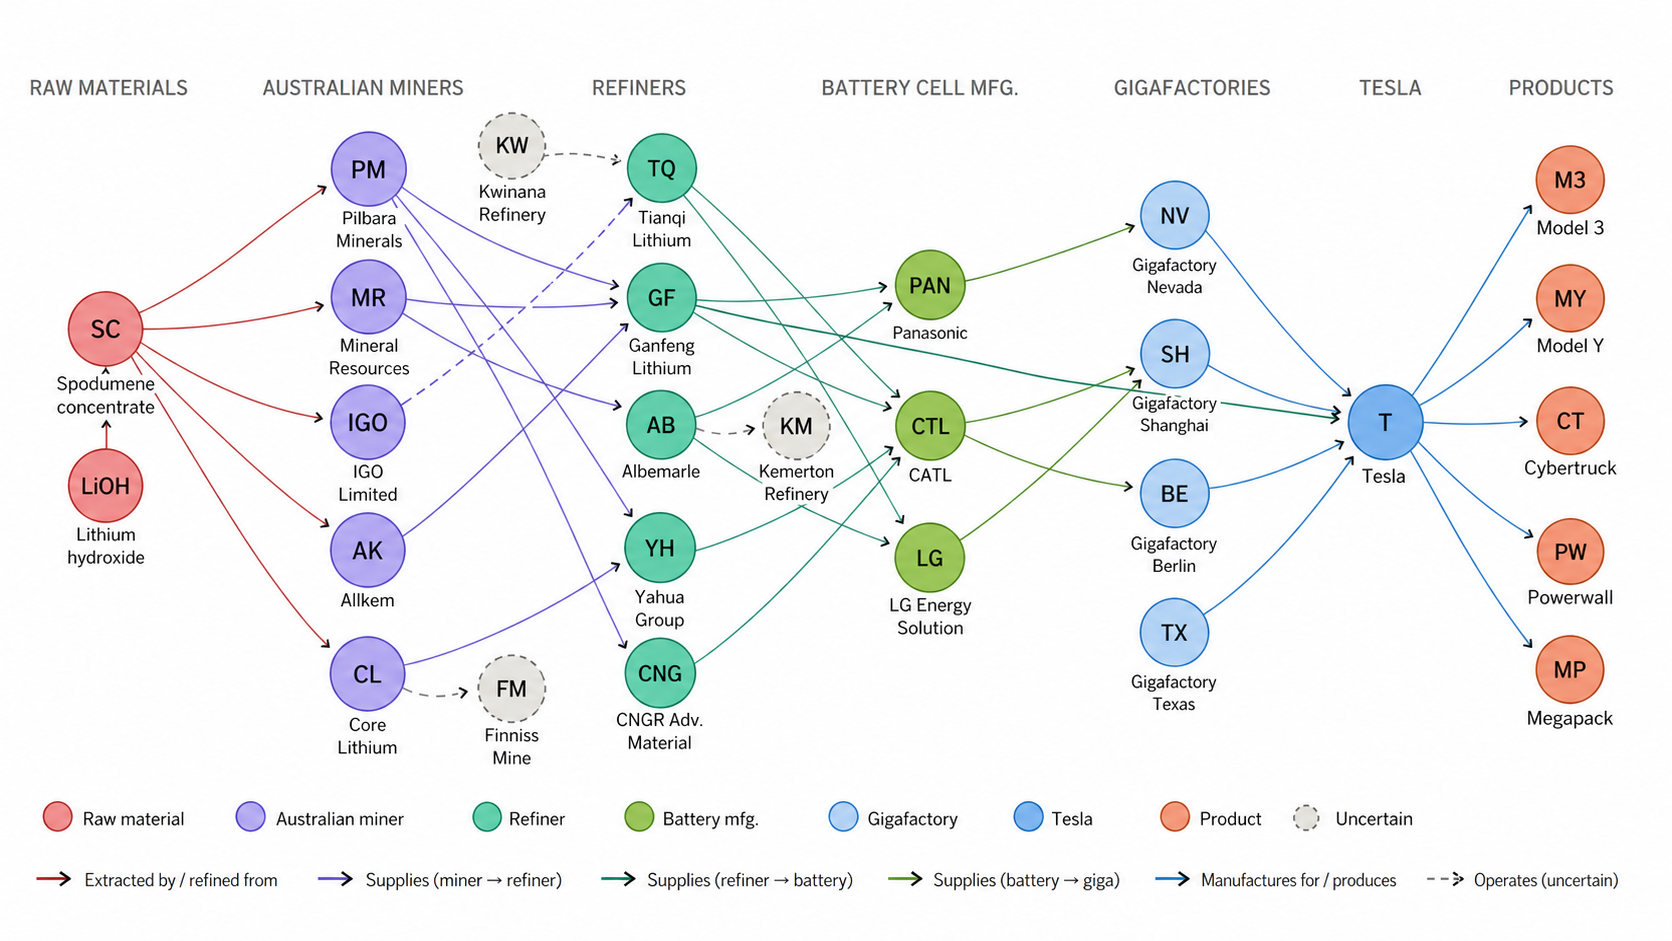
两个案例能说明图长什么样。特斯拉锂供应链题跑了 5 轮,得到 7 层、28 节点、45 边的图:25 个确认实体(2 种原料、5 家澳洲矿企、5 家精炼厂、3 家电芯厂、4 座超级工厂、特斯拉本身、5 个下游产品),另有 3 个高不确定实体被标灰;记忆层不确定性从 1.00 降到 0.20,上游采矿—精炼环节仍高于 0.30,下游工厂—产品低于 0.10。宝洁护发题跑了 4 轮,得到 17 节点、29 边的二分图,图 F1 为 0.85,校准误差 UCE 为 0.25。
消融:不确定性引导是承重墙
在最难的 Q4 象限做消融:去掉不确定性引导,图 F1 掉 0.12;把乘性累积换成取最小值,不确定性在第一轮观测后就停滞,UCE 恶化到 0.41;关掉动态并行搜索,收益变小但仍有意义;把多智能体压成单智能体,图 F1 跌到 0.45,只略高于 ReAct 的 0.32 和思维树的 0.39。也就是说,图的价值不来自“事后抽取一个结构”,而来自不确定性引导的搜索、增量建图与证据累积三者紧耦合。
成本约每查询 0.20—0.45 美元,与最强基线同档,但产出是带逐条置信度的结构图,而不是一段文字。论文明确不主张替代专家,而是把分析师花在初始取证、拼图与不确定性排序上的力气降下来。
资料来源:Helicase: Uncertainty-Guided Supply Chain Knowledge Graph Construction with Autonomous Multi-Agent LLMs — arXiv(2026)。本文为技术要点整理,非原文全文。