

多级供应链的库存管理有一张经典考卷:每一层只看得到自己的库存、在途、缺货与需求,向上游下单,目标是让整条链的总利润尽量接近集中优化得到的上界。启发式方法(基准库存、需求跟踪)好解释,却要针对场景人工调参;多智能体强化学习能学策略,但样本成本高,还要有与真实数据校准过的仿真器。
这篇论文问的是:大模型智能体能不能直接做这道题?答案是“能,但只在一种场景里能”。
先把题面写清楚,再谈策略
实验把每一层建模为一个智能体,动作为订货量;环境按订单到达、需求履约、发货、利润结算推进,未满足的需求转为缺货并计罚。智能体观察的状态包含自身库存、在途、缺货、需求等维度,层数越多维度越高。
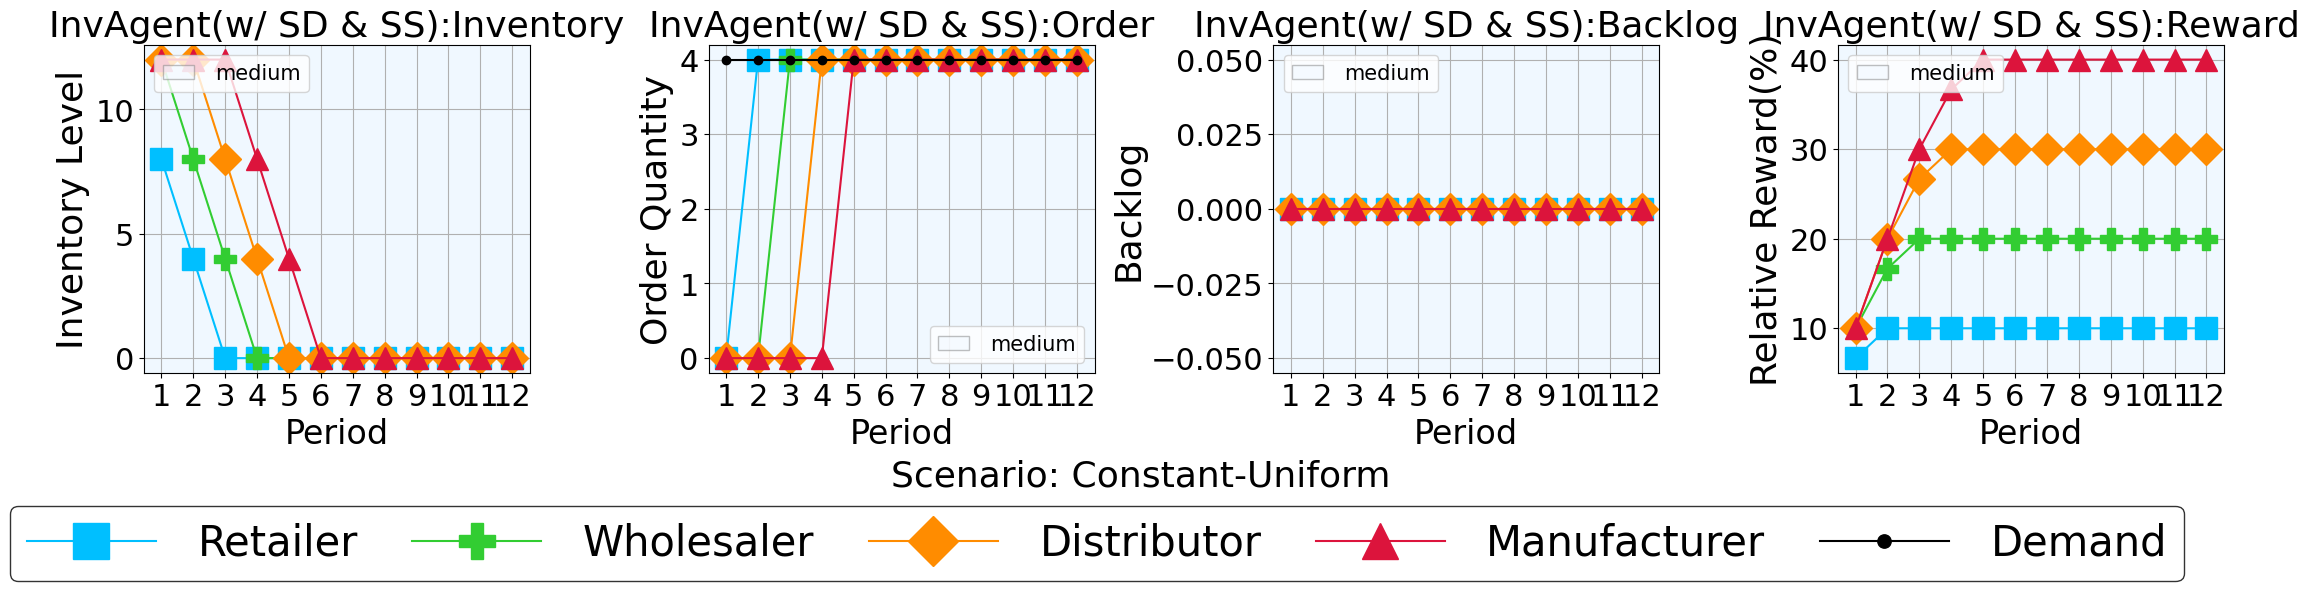
原始提示只给了角色与目标,缺少订单到达与时序等关键信息。作者先补上一段逐步流程说明,把“什么时候下单、货什么时候到、发货受什么限制”讲清楚;再插入安全库存策略:安全库存按需求标准差、提前期与服务水平的经典公式计算,目标消耗量等于提前期加一期的预测需求再加安全库存,订货量取目标与预计库存之间的缺口。这样,智能体不必从零发明策略,而是在一个可解释的框架里做数量判断。
测试覆盖五种场景:各层参数相同或不同,需求恒定、递增或递减。模型用 o4-mini,推理强度取高与中两档,每种配置跑 5 个回合;对照包括基准库存、需求跟踪两种启发式,以及 IPPO、MAPPO 两种多智能体强化学习。指标是相对最优解的差距。
结果一半是好消息:在“参数相同、需求恒定”的场景里,这套多智能体系统确实找到并执行了最优订货策略,作者称这是首次演示大模型多智能体能解出多级库存最优解。另一半是坏消息:同一套提示换到别的场景就不灵了,说明它学到的是特定题面的解,而不是可迁移的策略。
给智能体配一本“相似案例账”
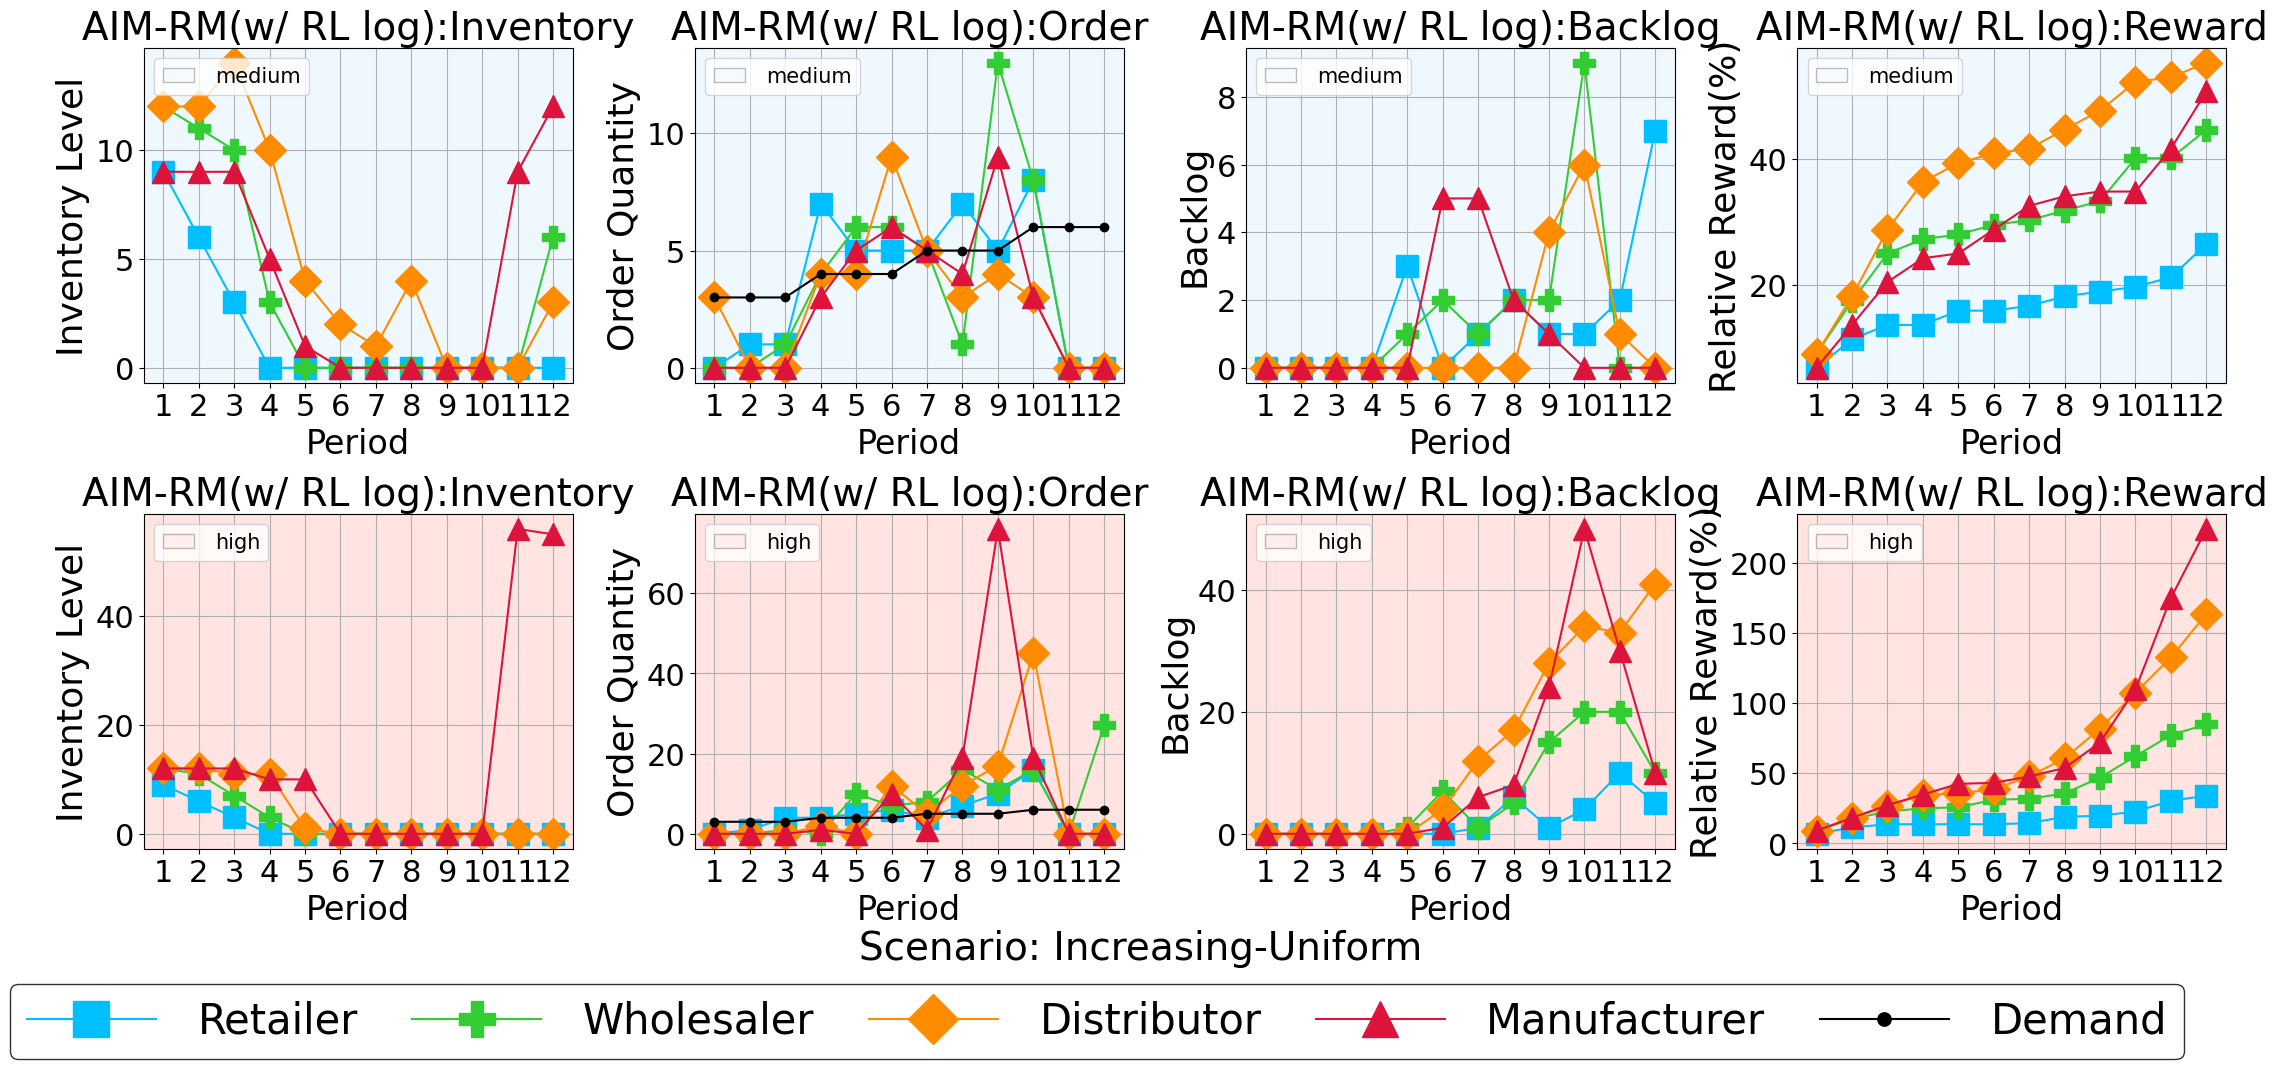
AIM-RM 的办法不是继续调提示,而是给智能体加一个外部记忆:把历史局面存成(状态、订货量、利润)三元组,放进向量库。决策时用欧氏距离在当前状态与历史状态之间找相似案例,距离低于阈值 2 的视为相似,最多取最近 6 条,连同“如何使用这些案例”的提示一起塞进上下文。
记忆可以边跑边攒,也可以预装强化学习日志:把 IPPO 在每个场景下各层的最优动作存进去,智能体参考这些案例时,实际上是在与其他层的动作做隐式协调——分布式架构里没有中央调度,但共享的历史结果让各自的选择彼此兼容。
实验显示,带记忆的 AIM-RM 在多个场景下优于基准方法,并与强化学习方法表现相当。一个反直觉的细节是,提高推理强度并不必然改善表现;作者还观察到推理模型有时直接给出结论,跳过中间推理过程,因此很难判断它是否真的用了检索到的相似案例。
论文也列了三条限制:相似度用固定的欧氏范数与阈值,换数据分布是否仍有效没验证;需求设为确定性序列,是为了控制大模型调用成本,随机需求下的表现仍待测;评估回合数只有 5 个,统计功效有限。作者提出的下一步,是把“自我反思”写进记忆——不只存结果,还存“什么有效、什么失败、为什么”,让相似案例带上可执行的经验规则。
对工程落地的启示
这篇文章的价值不在“智能体能做库存”,而在它诚实地划出了边界:通用推理能力不等于可迁移的决策策略。供应链场景的参数、提前期、需求形态一变,提示里那点隐含假设就失效。把“过去类似局面的解”外置成可检索记忆,比让模型在每次对话里重新悟一遍更划算,也更便于审计——每条建议都能追到它参考了哪几个历史案例。
资料来源:AI Agent Systems for Supply Chains: Structured Decision Prompts and Memory Retrieval — arXiv(AAMAS 2026)。本文为技术要点整理,非原文全文。