

化工产线的工艺优化长期依赖老师傅:看曲线、听声音、凭经验调转速和压力。福建能化信科参与打造的“化工生产工艺智能优化与风险治理垂直模型”今年 3 月接入生产数据,在福建海泉化学、福海创等企业落地,试着把这件事变成可推演、可执行的系统。
先推演,再建议
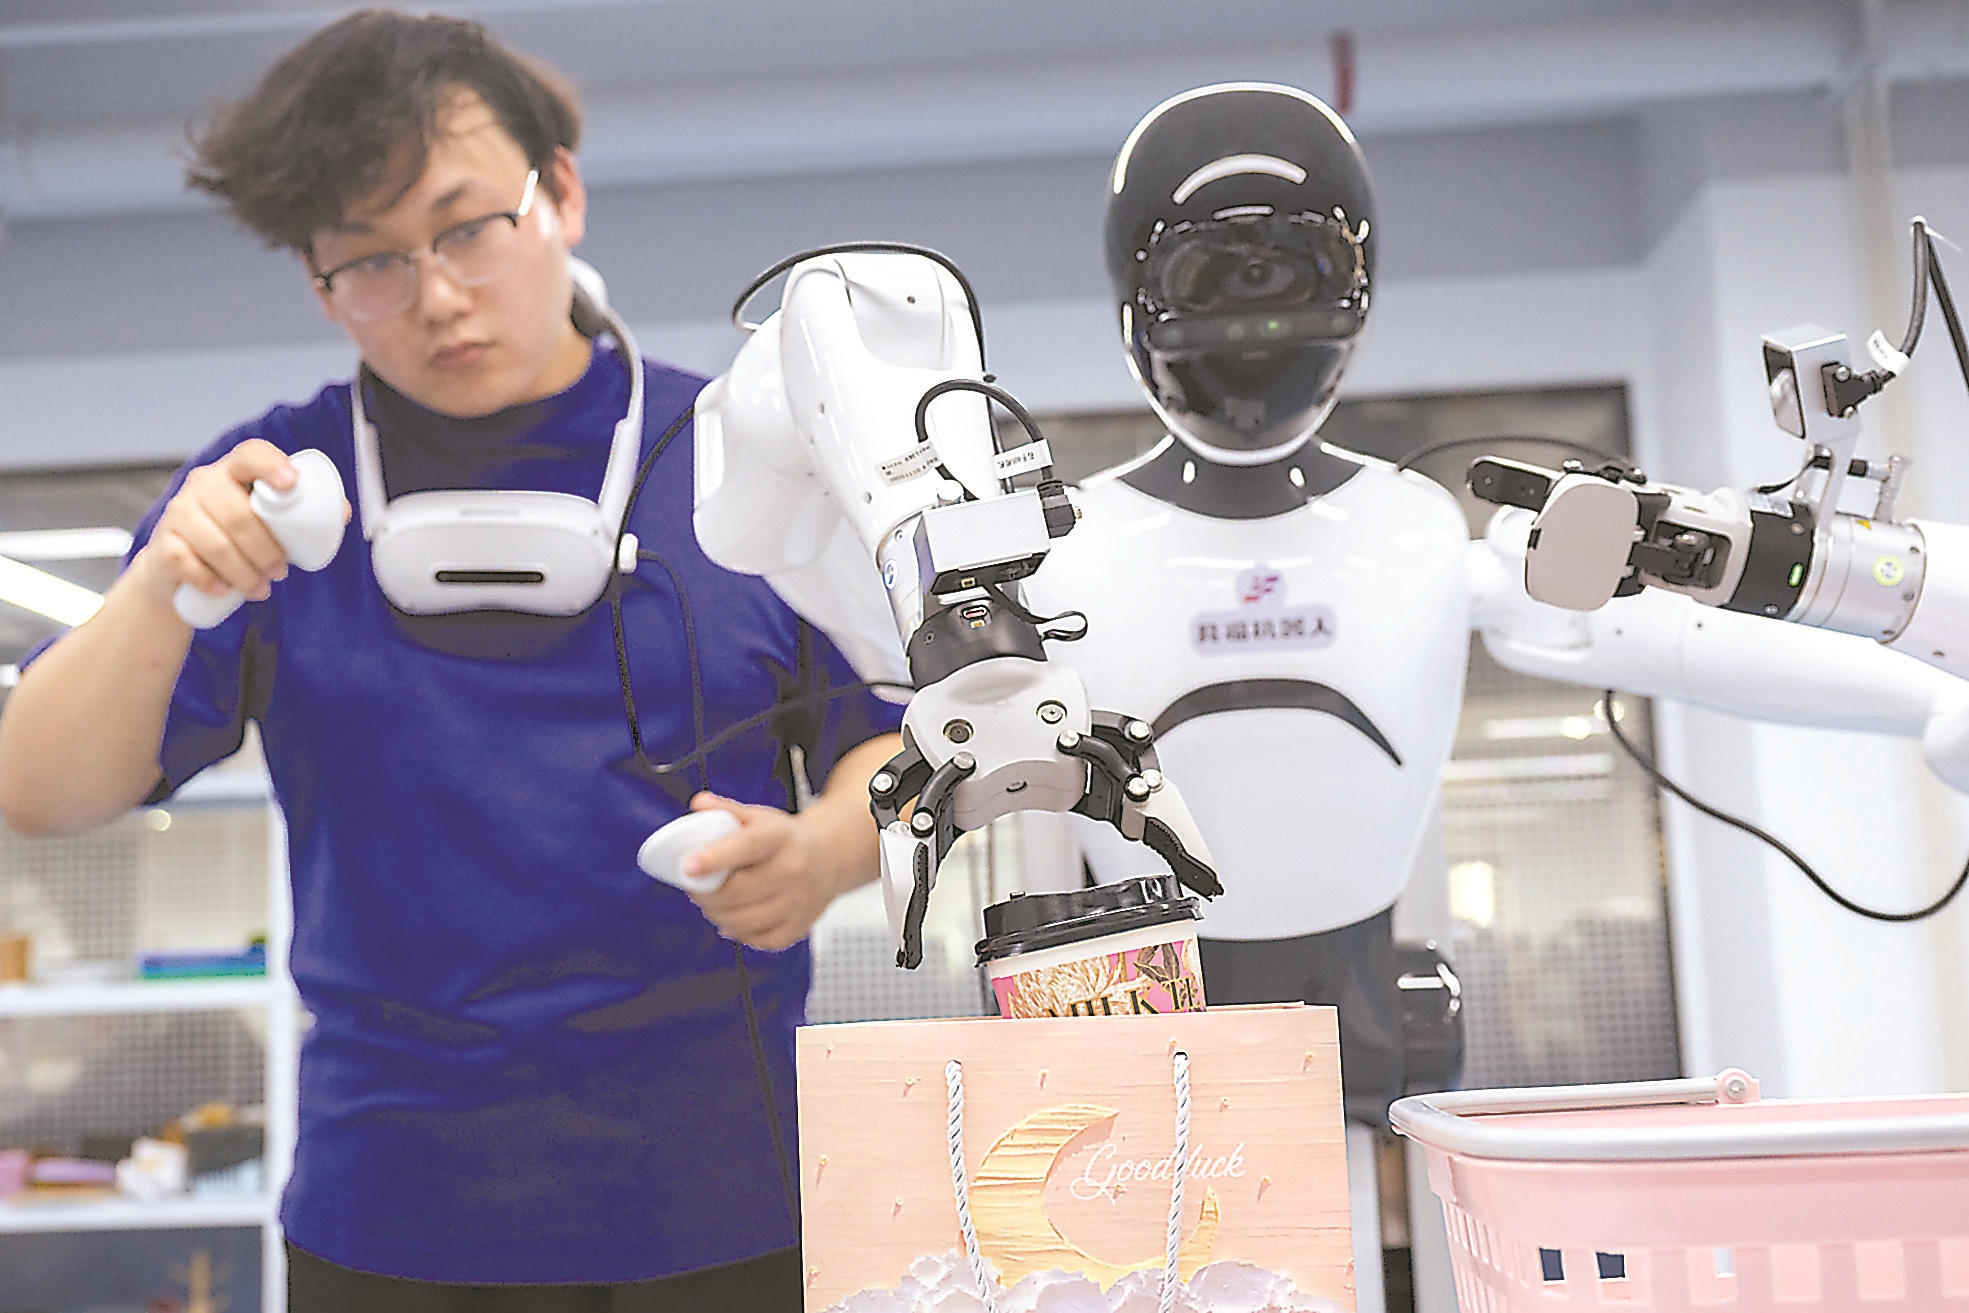
现场演示的是缩聚反应器智能预测系统:屏幕推演未来 15 分钟的产品质量曲线,指标一旦偏离就报警,并给出“转速上调、压力下调”这类专家级操作建议;算法还在历史数据里求解最优区间,让产线保持在功耗最低、黏度最稳的状态。这不是在产线旁外挂一个算法,而是底层有自研基座垂直模型和化工行业数据,上面长着以工艺优化和风险治理为导向的场景化应用。
一套“模型组合拳”
项目摸索出的核心是双架构:垂类大模型加时序预测算法。原因很实际——单靠大模型,数值预测容易跑偏;只用时序小模型,又不懂工艺“行话”。两者结合,时序算法负责稳准地算数据,大模型负责懂工艺、做决策,才把工业预测这件事拆开又合上。
这条路线的前提是数据。项目总负责人陈敏生的描述是“反复的战役”:采集、清洗、训练、场景测试、调算法,再测试、再调整。清洗环节的具体问题很典型:数据格式不统一、工控点位数据缺失、生产实时数据与化验分析数据时间戳对不齐。团队的处理是统一数据字典规范格式、剔除故障停机异常工况片段、用插值补全与阈值过滤修复缺失和跳变、按生产事件标签完成时序与化验数据的时间对齐、再结合工艺机理规则做二次校验过滤。
组织方式:模型团队与厂方专家各管一段
项目由福建能化信科成立研发团队、建设高质量数据集、研发模型;福海创调派化工专家提供工艺优化需求与生产核心数据,并协助验证评估。这个分工值得注意:工艺知识不是“喂给模型”就行,需要懂工艺的人定义什么算偏离、什么建议可执行、怎样验证有效。垂直模型是连接数字智能与物理世界的关键载体,但它能不能用,取决于现场专家愿不愿意把判断标准交出来。
不是孤例,但也不是万能
福建的路径是把垂类模型当产业基础设施来建:全省累计培育人工智能行业垂直模型重点项目 103 个,遴选发布首批试点应用成效明显的 38 个优质模型,工业领域占 36.8%,高于其他行业。针织领域的“织女”大模型是另一个例子:设计输出要做到像素级工艺表征,因为每个像素都对应机台上具体位置的针法,偏移一点就上不了机。
把这几件事放在一起看,结论并不浪漫:垂直模型的价值来自数据质量与工艺理解,而不是参数量。高质量数据集决定模型“智商与品性”的上限;工艺机理规则既是清洗时的过滤器,也是推理时的约束。对制造企业来说,先回答“我的数据能不能对齐、我的专家能不能把判断标准写下来”,比先选哪个基座模型更重要。
资料来源:AI+,从“通用”转向“垂直” — 福建省工业和信息化厅(2026-09-15)。本文为技术要点整理/编译,非原文全文。