

工业智能体记不住上一次是怎么修的,就会在同一个故障上重复劳动。MemOS 团队把记忆拆成一条工程链路,并在一个工业合作项目里把它落成了“工业记忆图谱”:老师傅的排障经验被结构化为“问题—原因—处理方案—结果”的记忆单元,再按关系组织成图。
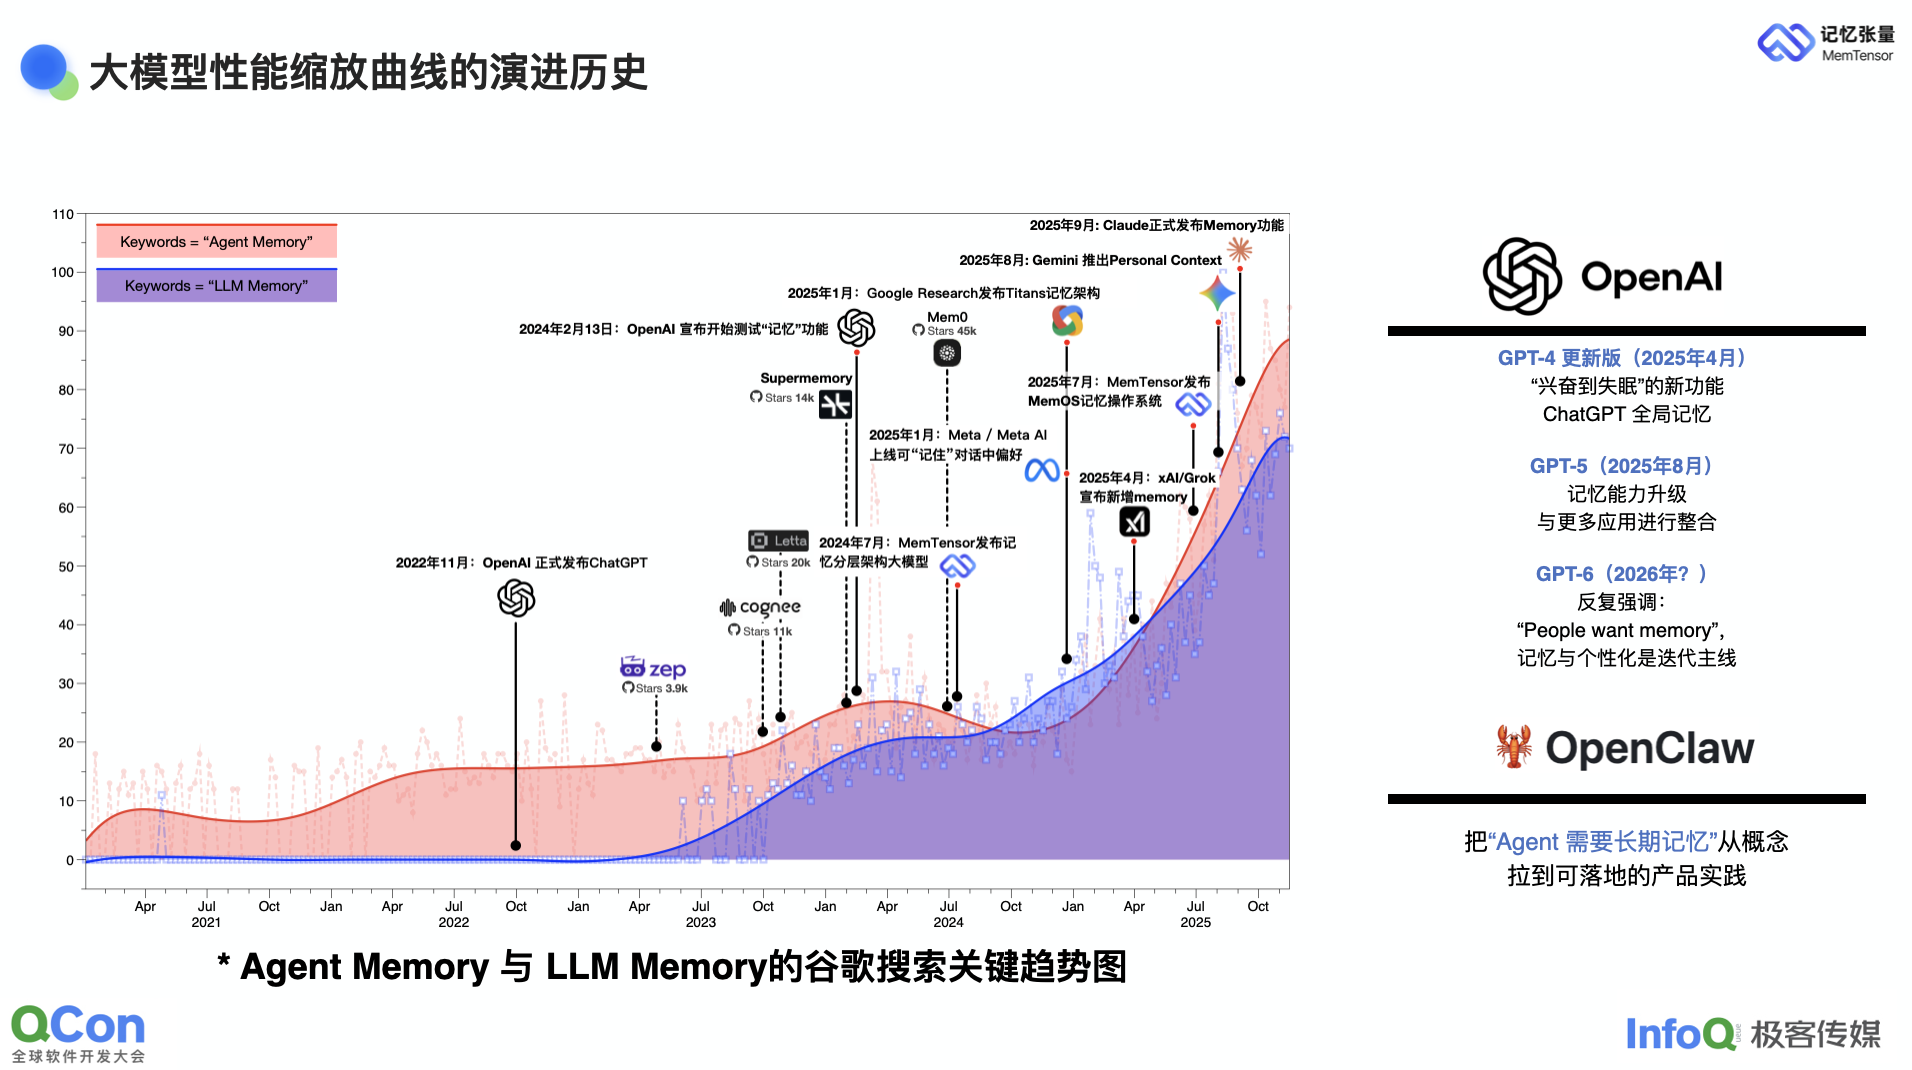
记忆不是检索旁路,而是可靠性部件
在长流程任务里,智能体如果记不准自己的状态、进度与环境反馈,就会出现重复执行、跳步或任务中断。因此记忆要从“提升召回”的辅助功能,变成支撑连续任务的基础设施。MemOS 把记忆增强拆成五类能力:抽取(从对话、工具调用、企业文档里识别关键事实、偏好、约束与知识片段)、组织(处理时间、版本与关系)、检索(在合适时机取回相关记忆)、更新(修正、替换、遗忘与隔离过时或冲突记忆)、共享(在多智能体、多应用间平衡复用与安全)。
存储上分三类:明文记忆可读可治理、更新便宜,但检索—生成链路有时延;激活记忆对应 KV Cache 管理,把合适信息提前放进缓存以提高命中率、降低首 token 时延;参数记忆沉淀在模型内部,读取最快、训练与更新最贵。关键不是选一种,而是把合适的记忆放到合适的位置,并在三者之间调度。记忆还会随时间、版本与关系演化,因此需要用图结构表达事件之间的逻辑、冲突与时间关系——这正是工业场景需要的部分。
落地形态:从经验到记忆单元,再到图谱
工业合作方的痛点是经验分散:设备说明书、检测报告、运维手册、故障记录各在一处,没有统一整理与结构化沉淀,AI 无法直接继承。改造后,这些经验被写成“问题—原因—处理方案—结果”四段式记忆单元,同类单元再组织成工业记忆图谱。智能体与一线工程师处理故障时,系统按相似处理逻辑召回,辅助定位与决策;每次维修反馈又能生成新的记忆单元,反哺记忆库,形成“沉淀—复用—反馈”的闭环。
要让这条链路可靠,还需要三件工程配套。其一是去重:SHA-256 精确哈希、向量余弦检查、大模型判断组成三层漏斗,官方给出的最高压缩率约 75%,减少冗余与漂移。其二是版本化:按策略保存关键状态快照,对偏好、任务目标与核心事实的变化做版本管理,能判断哪些记忆该淘汰、替换、回滚或遗忘。其三是可观测:Memory Viewer 提供时间线、向量空间与热力图,质量看板盯重复率、关联强度、召回命中率与技能成功率,溯源能记录每条记忆来自哪个会话、被哪些任务引用、经历过几次合并去重。
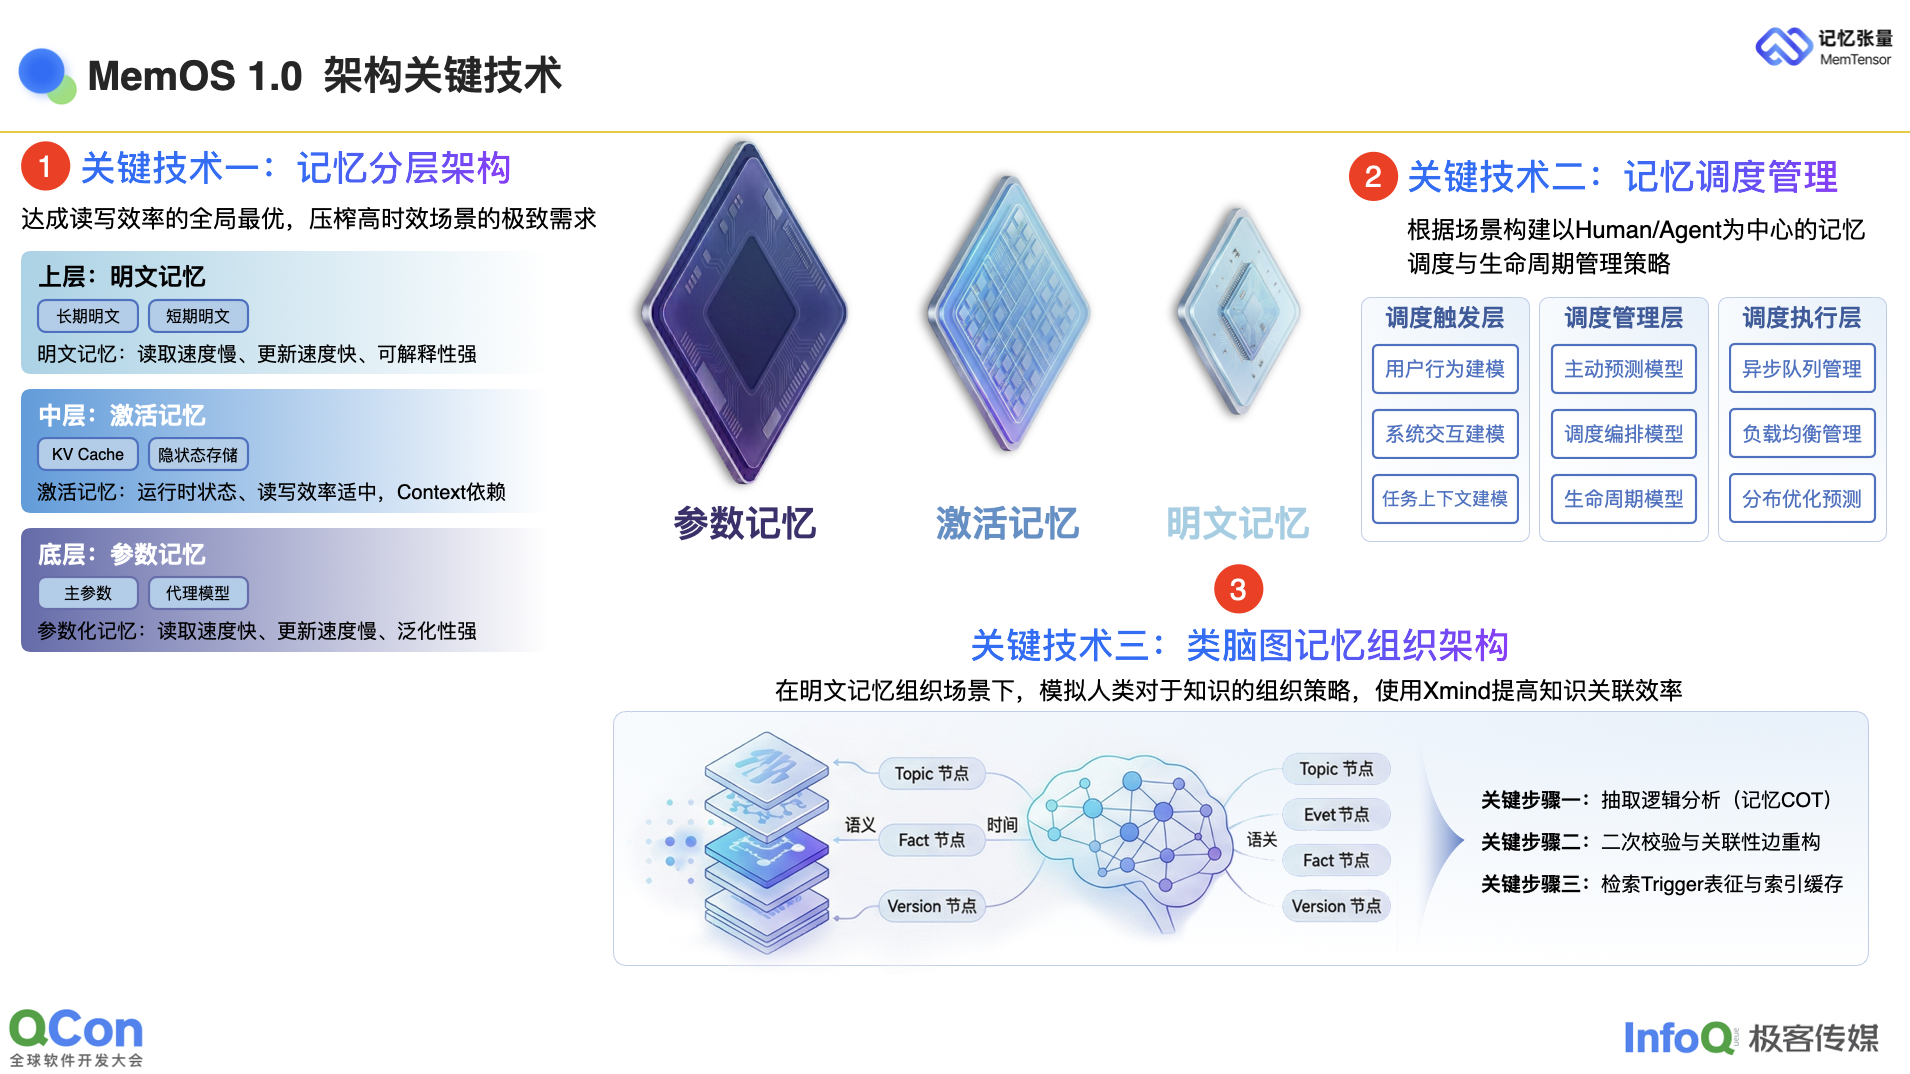
从记忆到技能,需要一道反事实校验
Mem2Skill 把对话碎片转成结构化任务,再沉淀为参数化技能:先捕获、去重、归档,再从归档记忆里归纳复杂事件的处理逻辑。为了防止偶然相关信息被误当成技能,系统引入反事实校验,判断某条记忆证据对技能形成是否有稳定贡献。这与工业知识工程的老问题是同一个:一条“上次这么修好了”的记录,不等于可复用的因果规则。
治理上没有免费的午餐。生成模型在抽取与归纳阶段会出错,而错误记忆一旦写入,会在后续检索、更新、共享中持续传播,比单次回答的幻觉更难清除。所以记忆系统必须带校验、版本与治理,而不是只追召回效率。对企业而言,最有价值的资产往往不是模型,而是这套被结构化、可追溯、可回滚的经验库。
资料来源:从上下文到经验资产:Agent 记忆系统的工程化路径与 MemOS 实践 — InfoQ(2026)。本文为技术要点整理/编译,非原文全文。