

智能工厂里的故障很少是孤立的。一台自主移动机器人(AIV)报导航失败,根因可能是车队管理软件 Mobile Planner 的参数配置,而不是车体硬件。要定位这类问题,运维人员得在几套设备、数百页手册之间来回翻,术语还不统一。单机文档的检索增强生成(RAG)能回答“这本手册里怎么写”,却很难回答“另一台设备的软件怎么影响这台设备”。
一个可复现的六层实验场
FactoryLLM 把自己定位成“安全的开源评测场”,而不是直接上线的维修助手。它把流程拆成六层:配置、知识摄入、交互、检索、推理、存储。
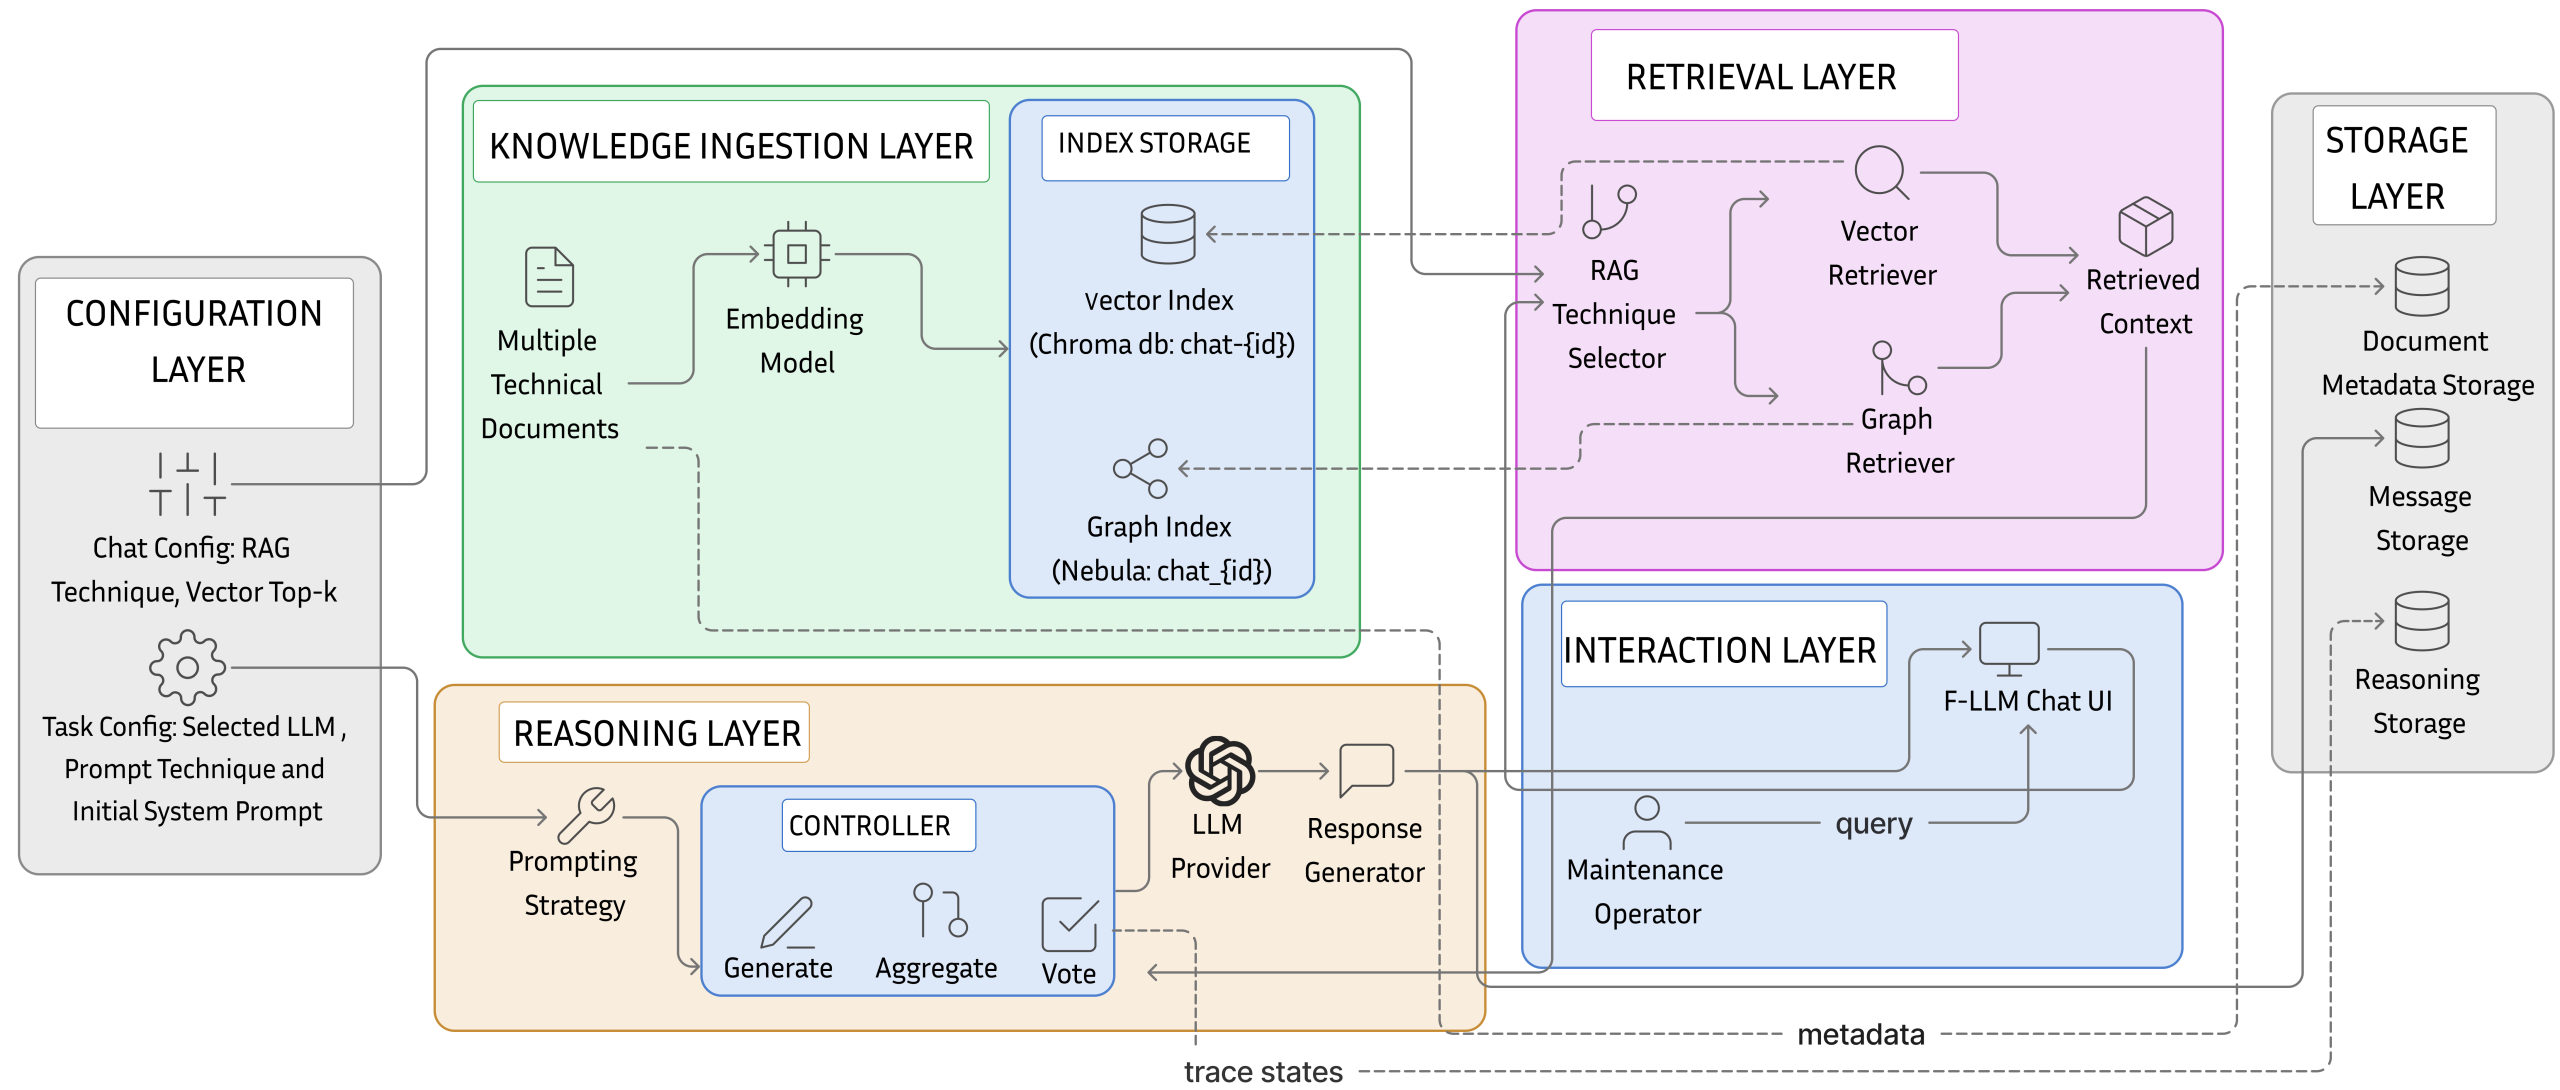
配置层允许选择模型提供方(OpenAI、OpenRouter、Gemini 或本地模型)、提示策略(直接输入输出、思维链、思维树、思维图)以及向量或图谱检索、top-k 数量,所有设置持久化,保证实验可复现。知识摄入层接收 PDF、DOCX、TXT,按预设 chunk 大小和重叠切分,向量检索写入会话级 ChromaDB 集合,图谱检索写入会话级 NebulaGraph。检索层在同一个统一索引上工作,所以一次查询可以同时取到不同设备、不同软件手册的片段。存储层记录每一轮对话、提示、检索片段和中间推理状态,便于事后追溯和 RAGAS 评测。
用 600 页手册考 30 个跨设备问题
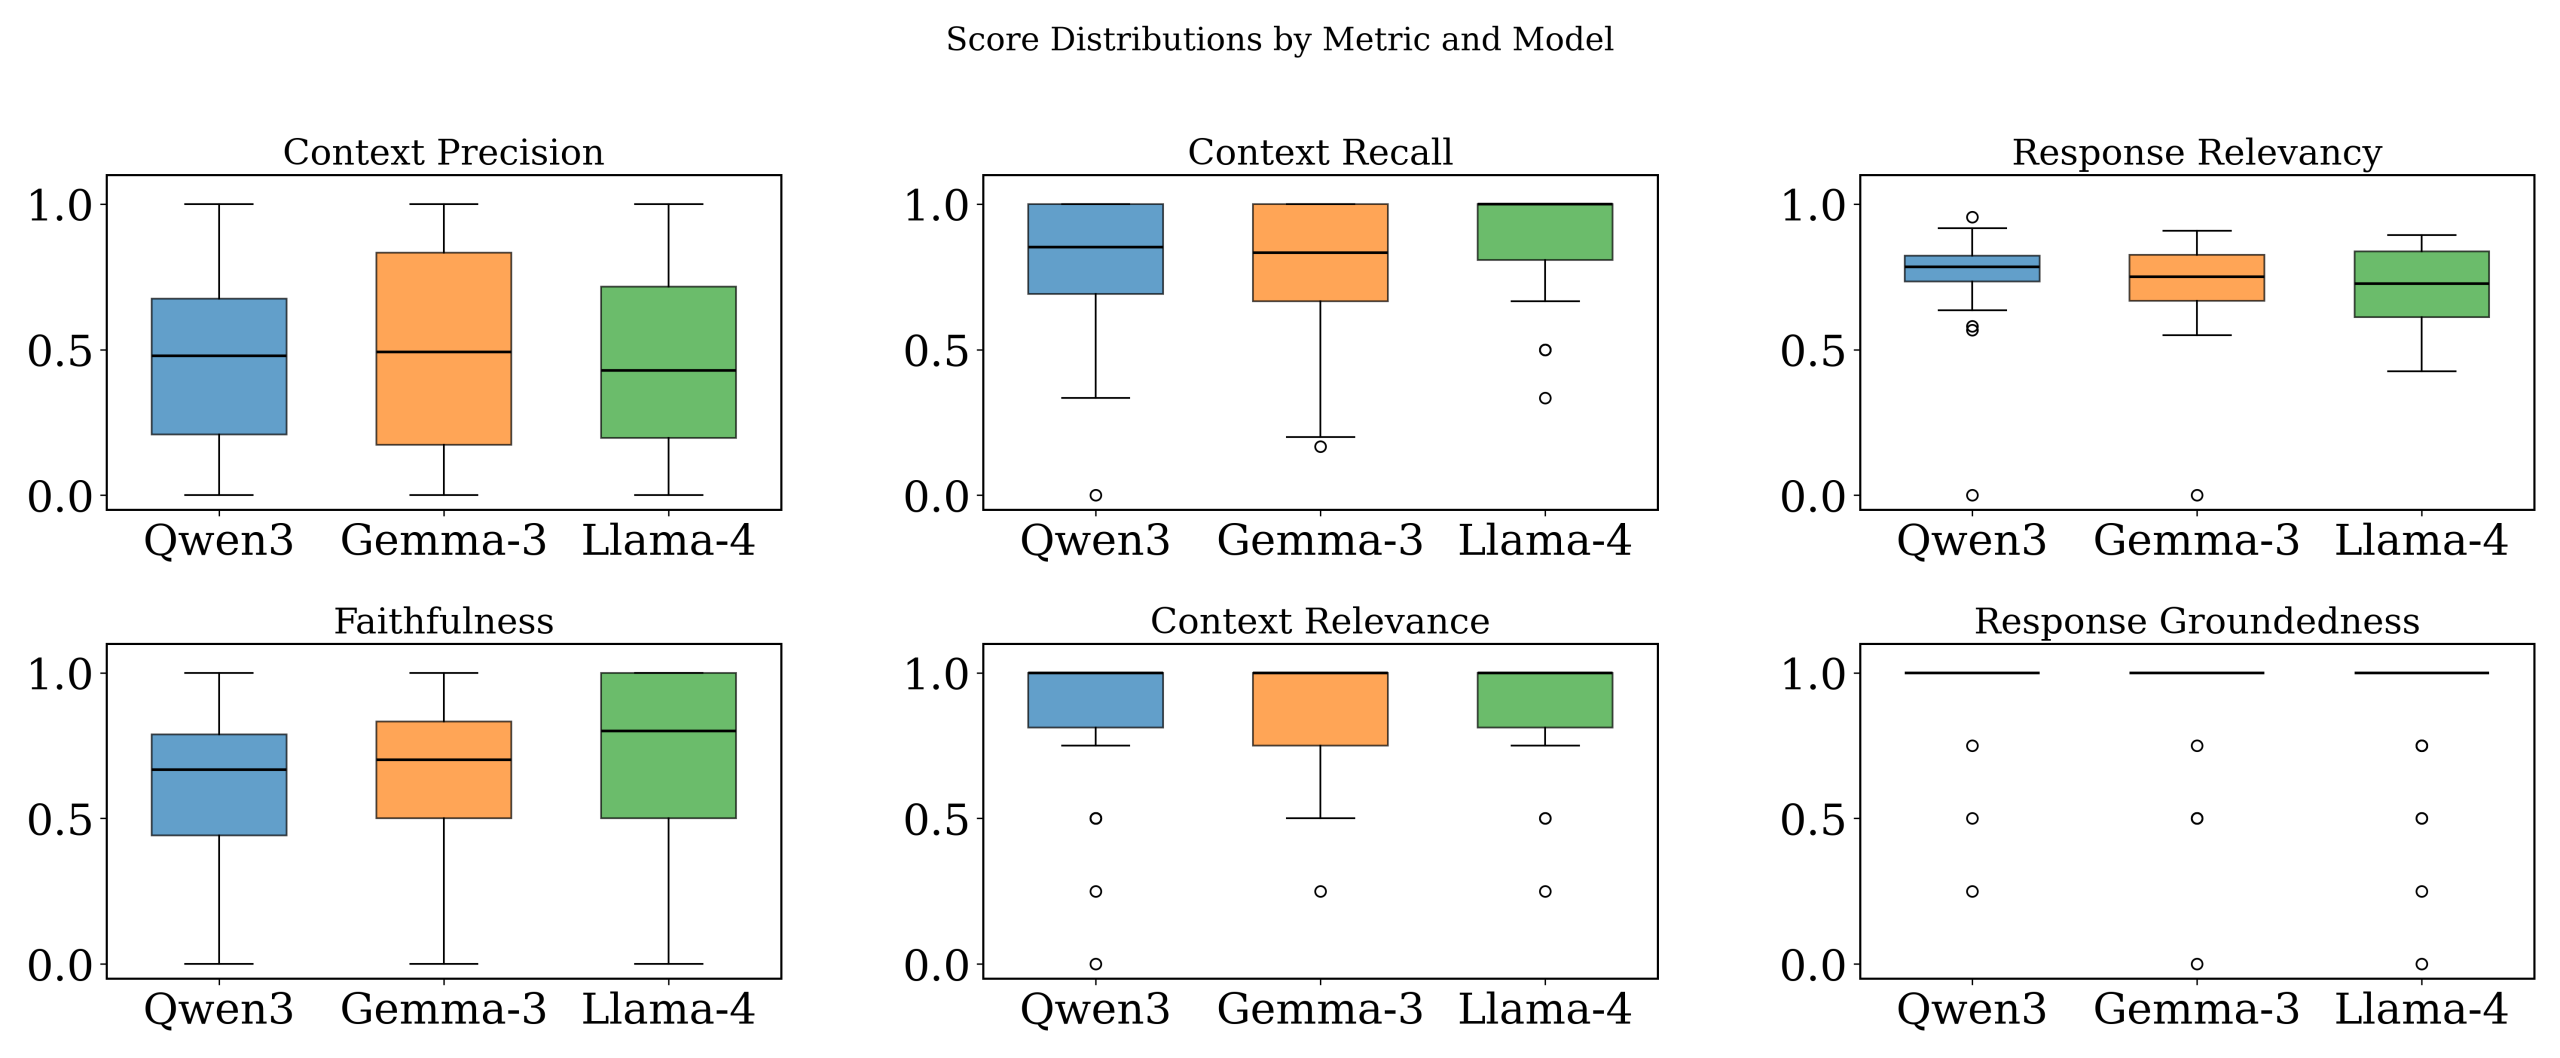
案例选了一对强耦合系统:AIV 与其车队管理软件 Mobile Planner,两边手册合计约 600 页。30 个问题全部是跨设备的,任何一个都无法只靠单本文档答全,覆盖故障诊断、配置指导和操作流程。实验固定 chunk 为 1000 token、重叠 200、top-k=10,比较三个可用模型,检索与生成分别用 RAGAS 和 NVIDIA LLM-as-judge 两套指标打分。
结果呈现出清晰的分层:整体均分在 0.73–0.76 之间,生成侧的 groundedness 达到 0.88–0.95,说明答案基本能落在检索到的原文上;但检索侧的 context precision 只有 0.46–0.51,约一半召回片段并不直接有用,有 6 个问题的精确率低于 0.20。context recall 为 0.76–0.89,说明相关信息其实找到了,只是被噪声稀释。faithfulness 为 0.62–0.72,有 7 个问题低于 0.50,跨设备推理仍会产生部分没有原文支撑的说法;response relevancy 为 0.72–0.75。
论文给了一个具体例子:用户问“给高载荷加装侧向激光器,应该接核心的哪个物理端口,哪个软件参数处理这些传感器数据”。系统从 AIV 硬件手册取到 RS-232 Aux Sensors 的 DB9 母头,又从 Mobile Planner 手册取到 Safety Commissioning 的菜单路径,两个来源拼成一条完整回答。单独看任何一本手册,都答不出来。
评测方法本身也是结论
这套实验最重要的发现,是“检索是瓶颈,生成不是”。如果只看 groundedness,很容易得出“RAG 已经够用”的结论;把检索精确率和召回率拆开,才会看到重排、查询分解和跨文档术语对齐才是下一步的着力点。双框架并行还提供了交叉校验:RAGAS 的 faithfulness 更严格,NVIDIA 的 groundedness 更整体,两者平均分相差约 0.25,分歧本身就能提示问题是局部的还是系统性的。
对制造企业来说,FactoryLLM 的可借鉴之处不在某个模型,而在评测骨架:会话级索引保证隔离,配置持久化保证复现,原始片段与中间推理全量留存,本地模型保证敏感文档不出厂。先有这样的实验场,再谈把维修助手接到工单系统,顺序才不会反。
资料来源:FactoryLLM: A Safe and Open-Source AI Playground for Evaluating LLMs in Smart Factories — arXiv(2026-06)。本文为技术要点整理/编译,非原文全文。