

流程工业的工艺优化,第一步往往就卡住:把一段口语化的生产描述和一张工艺流程图,变成可求解的数学模型。决策变量、目标函数、物料与能量平衡、热力学上限、安全联锁,一样都不能少。通用大模型直接写模型,常见毛病是“数学上像那么回事,物理上不成立”,比如漏掉一个储罐不能溢出的隐含约束。
三阶段工作流,两次人工确认
little m 的思路是把建模拆成人类工程师熟悉的项目流程,而不是让模型一步从输入跳到公式。
第一阶段是信息结构化:读文本描述和工艺流程图,抽取关键步骤、设备类型和运行模式,压成一份结构化摘要,由用户确认后才能进入下一步。第二阶段是策略设计:结合用户目标和检索到的领域知识,给出优化目标、模型类别、主要决策变量、所需信息和候选约束族,同样要用户点头。第三阶段才是数学建模:把确认过的策略翻成目标函数、变量、固定参数和约束,并为每个符号标注数据来源;最后由专家做语义审查,发现不符就触发多轮追问,把隐含的开停车顺序、安全边界等补回来。
知识库不是文档堆,而是“问题路径”
支撑这套流程的是一个领域知识库。它不以算法条目组织,而以“问题路径”组织:每个条目把可观察的工况或症状,连到一个主要优化目标、若干候选方法、可复用的数学与约束模式,以及适用边界。症状只作为检索锚点,不当作已确认的根因;候选方法必须连同使用条件和所需信息一起给出。检索用向量搜索加交叉编码器重排(bge-m3 与 bge-reranker-v2-m3),推理引擎是 Gemini 2.5 Pro。
IPC-Bench 与两类评测
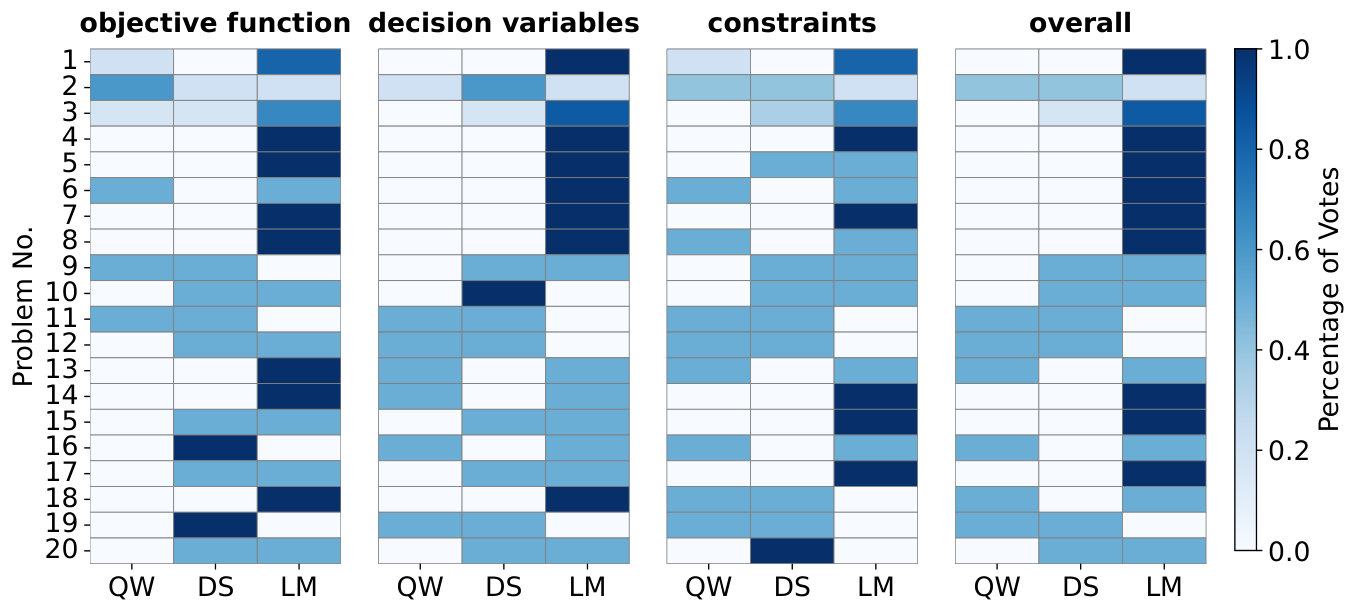
团队构建了 IPC-Bench,50 个取自流程控制与化工优化教材的典型场景,覆盖反应、分离、传热以及公用工程/调度,多数需要同时读文本和工艺图。评测分两路:8 位来自计算机、数据科学和控制工程的专家,对 20 个案例做双盲打分;另一路对全部 50 个案例做结构比对,变量按集合匹配,约束用二分图匹配算 F1。
专家偏好率上,little m 在目标函数、决策变量、约束和整体质量四个维度分别为 58.0%、60.0%、52.0% 和 66.0%,均显著高于随机(p<0.01);作为对照,Qwen 的决策变量偏好率为 14.0%,DeepSeek 为 26.0%。机器结构分上,little m 的决策变量得分 0.733、约束得分 0.418,均为最高;目标函数得分最高的是 DeepSeek(0.553),说明分阶段流程并非每个维度都占优。
消融进一步说明两路信息各管一段:去掉知识库,约束质量掉得最明显;去掉工艺图,目标函数和约束同时受损。交互恢复实验里,面对被刻意遮蔽的输入,允许 little m 追问后,决策变量和约束的得分明显回升,整体接近完整输入,但目标函数相关细节仍较难靠追问补回。
论文把边界说得很清楚:评测的是“建模表述质量”,不是求解器可行性、形式化物理有效性或闭环生产表现。这恰好划出了此类工具的正确位置——它是建模副驾,不是自动决策器;真正的价值在于把专家的隐性约束提前逼出来,让模型输出可审计、可修改。
资料来源:little m: An AI Agent for Industrial Process Optimization — arXiv(2026-09)。本文为技术要点整理/编译,非原文全文。