

车间里的助手要同时满足三个互相拉扯的要求:看懂工人眼前发生了什么,听懂口语并给出可执行步骤,还要在断网、算力有限、数据不出厂的条件下稳定运行。MICA(Multi-Agent Industrial Coordination Assistant)把这三件事拆成三段:深度引导的对象上下文、自适应装配步骤识别、以及带安全审计的多智能体推理。
先看对象,再判断步骤
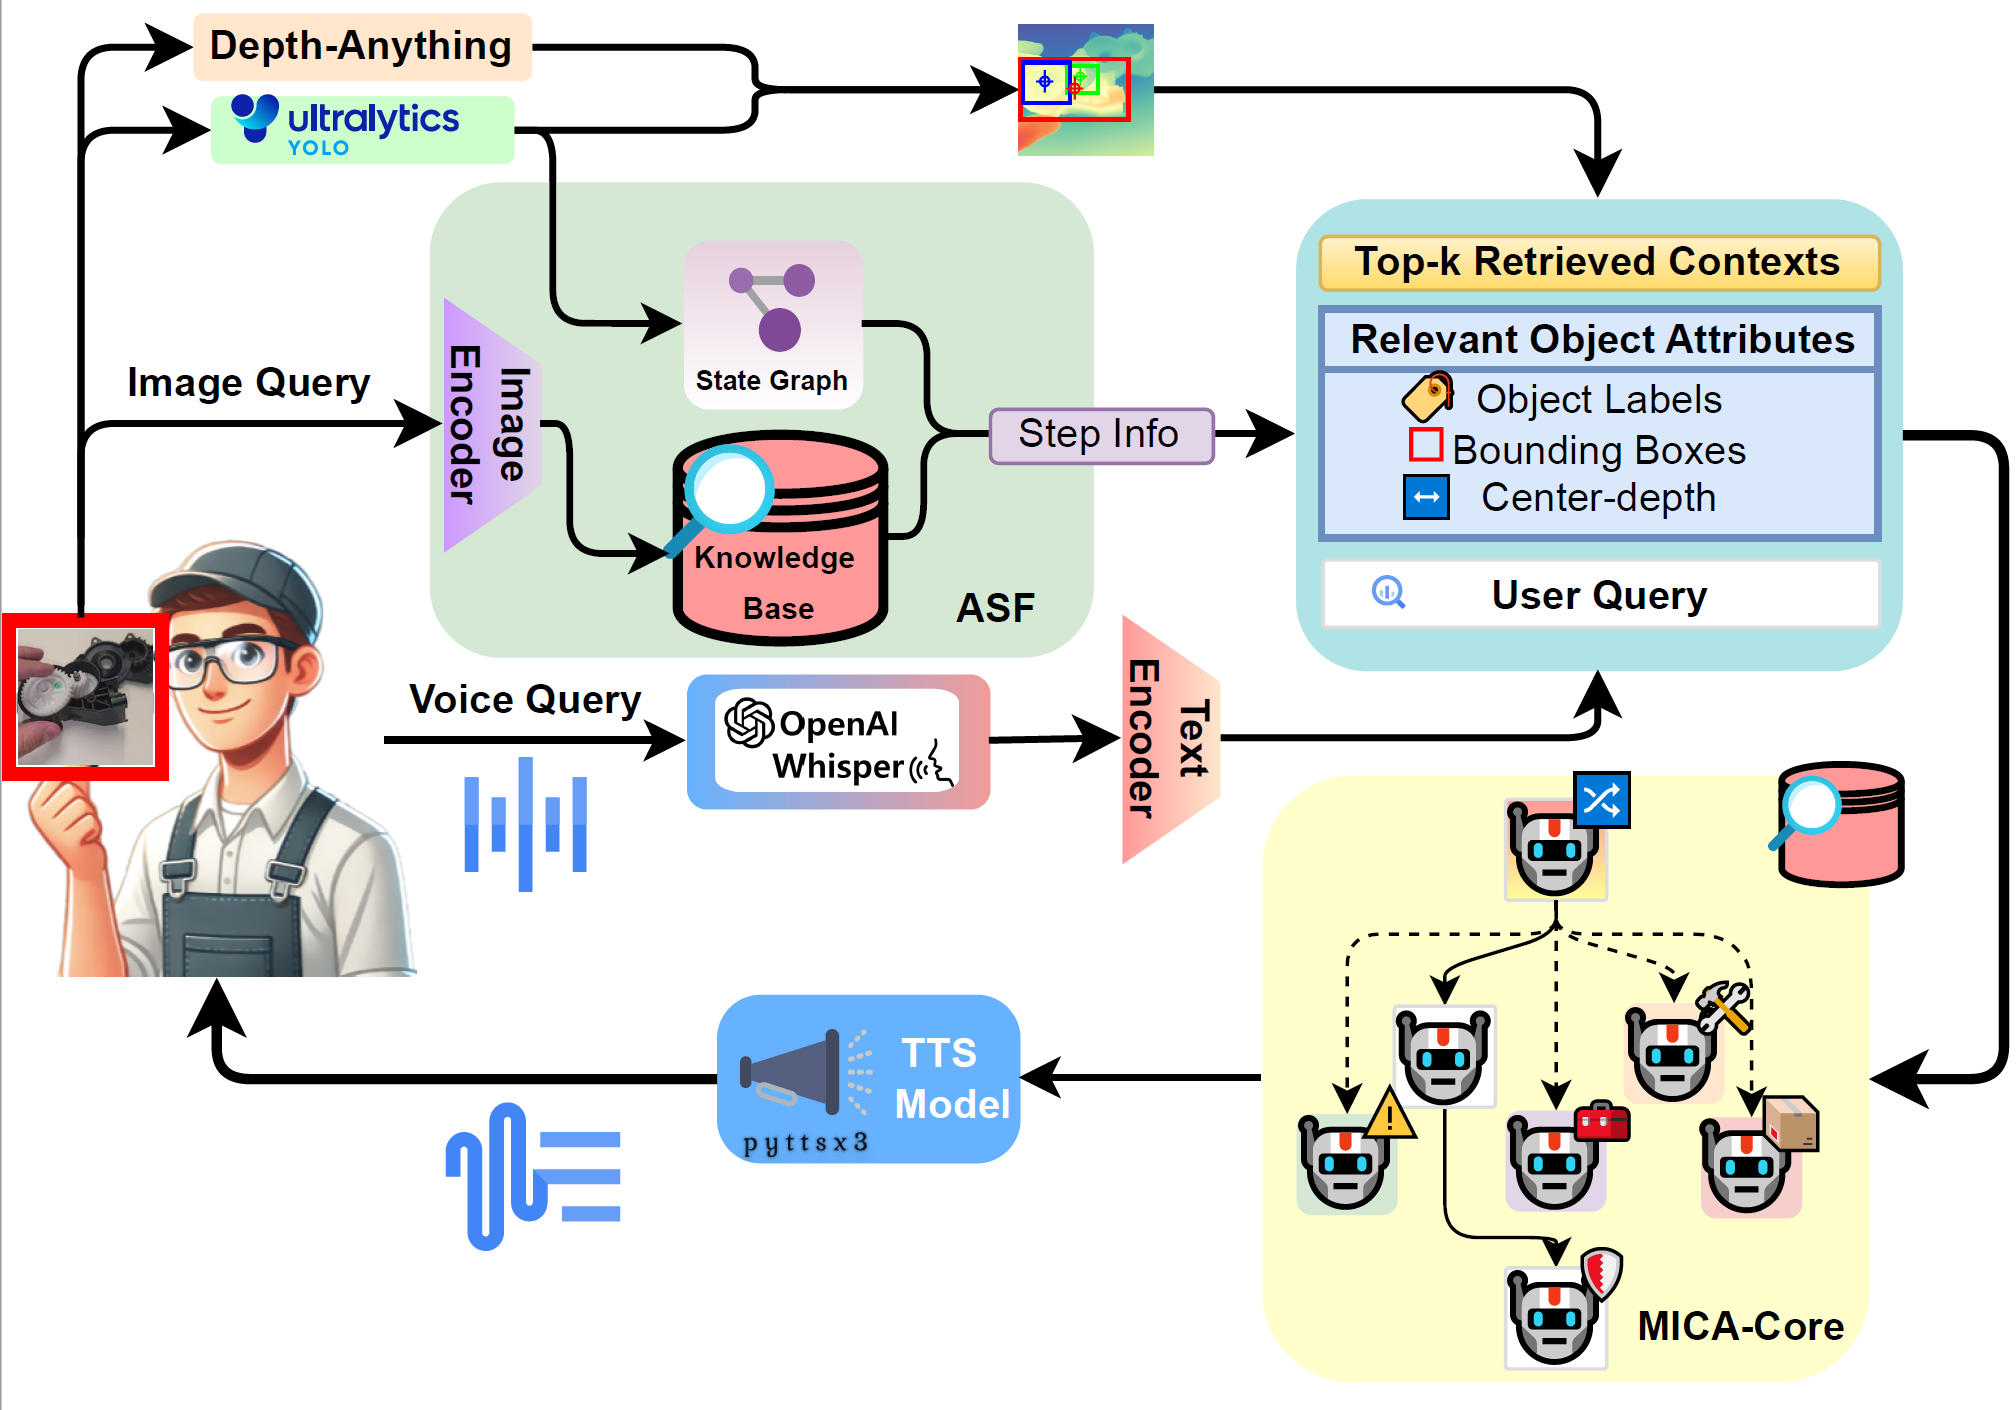
感知端用 YOLOv11-L 在 Gear8 数据集上微调,检测结果在滑动窗口内做多帧融合:交并比阈值 0.5、置信度阈值 0.4、至少 3 次检测、连续 5 帧保持。随后用 Depth-Anything-V2-Large 估计逐像素深度,把离相机中心最近的部件当作工人当前焦点,再把空间与深度阈值内的邻近部件纳入上下文。只有这份“深度细化”后的对象集合,才会进入后续模块。
步骤识别由两个互补检测器加一层轻量融合构成。状态图检测器从知识库自动导出每步的规则三元组:必须出现(all_of)、可替代出现(any_of)、禁止出现(forbid),并按部件数量计分,α 取 0.6;检索检测器则把当前帧与每步的参考状态图做余弦相似度。前者提供结构与可解释性,后者对遮挡和检测噪声更稳。
自适应步骤融合(ASF)在类别层面给两个专家分配权重与门控,并把“知识库覆盖率”和“不允许跳步”写成惩罚项。工人口头纠正会被当成标注:系统不做反向传播,而是按置信度与历史频次乘性更新权重、保守调整偏置,信任域上限 0.2、权重下限 10⁻³;高置信命中会被冻结,避免来回震荡。每步十次纠正,就足以把一套脆弱的融合器校准过来。
五个角色,一道安检
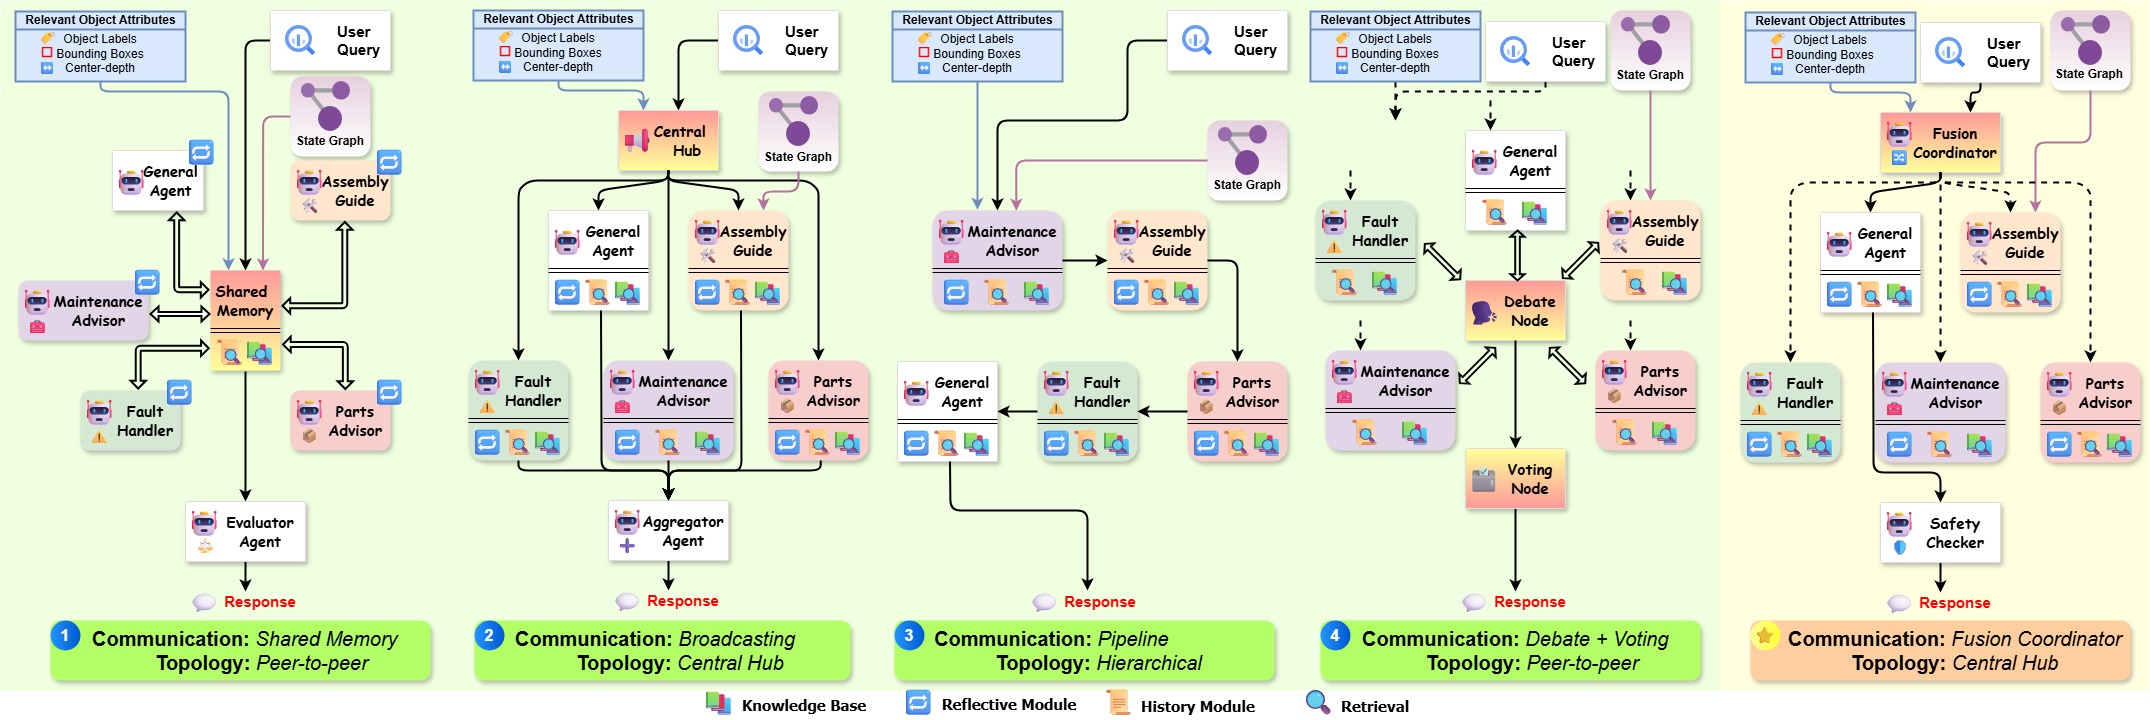
推理核心 MICA-core 用 Qwen2.5-7B-Instruct,加一个轻量路由,把查询分给五个专职智能体:装配指导、零件顾问、维护顾问、故障处理,以及兜底的通用智能体。每个智能体都在结构化知识库上做检索增强生成。所有输出还要过一道独立的安全检查器:核对工具使用、装配顺序与危险提示是否符合规则,防止不安全建议到达工人。
交互闭环由 Whisper-small 做语音转写、pyttsx3 做播报;工人可以口头确认或纠正步骤预测,这个反馈直接进入 ASF 的在线更新。整条链路跑在边缘设备上,不依赖云端。
四种协调拓扑,同一张考卷
为了公平比较“怎么协作”,论文固定工具、提示、知识库与底座模型,实例化四种拓扑:共享黑板(各智能体读写同一上下文,由独立评估器选答案)、中心广播(中枢广播状态、收集并行回答再聚合)、层级流水线(固定接力,逐级精修)、辩论投票(各自起草、互相批评、再投票)。
考卷是五类任务——通用、装配、零件属性、维护、故障处理——每类 32 题,共 160 题。指标分三组:任务成功率;BLEU/ROUGE 与知识库对齐度(KBA,衡量回答中的规范术语对知识库属性类别的覆盖);GPT-4o 裁判的事实性、相关性、一致性、有用性与安全性;以及端到端时延和“每次成功回答能耗”(用 NVML 采 GPU 功率并扣除空闲基线)。
结果:稀疏路由换来响应速度
MICA 平均任务成功率 63.13%,知识库对齐度 19.12%,时延 0.71 秒,每次成功回答 2.05 千焦,四项里没有明显短板。其余拓扑各有一处强项,也各付一笔代价:共享内存在维护类达到 37.50%,但评估器开销把时延推到 3.53 秒;中心广播在装配类达到 46.88%,并行激活带来更高能耗;辩论投票在零件属性类高达 96.88%,但时延 6.97 秒、能耗 11.47 千焦,且在装配与维护上会放大错误前提;层级流水线输出连贯却脆弱,上游一旦出错,下游没有纠错机制。
一个反直觉的发现是词面指标与事实对齐并不同向:中心广播的 BLEU/ROUGE 为 0.34/0.42,高于 MICA 的 0.30/0.37,但 KBA 只有 16.79%,低于 MICA 的 19.12%——更长、更模板化的回答与参考文本重合更多,却偏离知识库事实。对安全敏感任务,词面重合不是质量代理。
步骤识别侧的收益更直观:末端步骤 S4 在每步十次纠正后,准确率从 0 升到 95.34%,F1 提升 90.36;中段 S3 准确率提升 8.1 个百分点;S1 则出现精度—召回再平衡,准确率从 97.63% 略降到 92.71%,精度提升 15.2 个百分点。
论文没有宣布某个拓扑全面胜出。结论更像一张部署选择表:任务类型集中、预算宽松,可以选辩论投票换正确率;响应时间是硬指标、知识库又足够规范,稀疏路由更合适。代价是路由一旦判断错意图,回答仍然事实正确却不切题——好在失败可归因、可审计,安全审计仍会兜底。
资料来源:MICA: Multi-Agent Industrial Coordination Assistant — arXiv(2025)。本文为技术要点整理,非原文全文。