

风电叶片的缺陷,代价不只是发电量。论文引用2024年世界风能协会的数据:截至当年6月,全球风电装机容量达到1097吉瓦。同年,瑞典一座风电场发生一系列叶片失效,导致相关机型停运,西门子能源累计损失45亿欧元。叶片等部件一旦损伤,轻则降低效率,重则整机倒塌。
问题在于,现有检测方法大多止步于视觉识别。它们能框出裂纹、表面污渍、蒙皮脱粘、点蚀,却只输出结构化的坐标和类别,缺少语义解释,无法直接支撑检修决策。运维人员拿到一堆框,仍要自己判断严重程度、成因和处理方式。
三级流水线
这套框架分三段。第一段是YOLOMS:在数据预处理阶段做多尺度缩放与滑窗裁剪,用不同窗口尺寸、步长和重叠率生成大量子图,避免漏掉尺寸差异很大的缺陷特征,并配有校验与补档机制保证图像和标注完整。数据集来自Kaggle公开数据,由无人机搭载高清相机采集,共4048张风机图像,缺陷分为裂纹、表面污渍、蒙皮脱粘、点蚀四类,位置和类别由专家标注。
与YOLOv5、v8、v10、v11、v12在相同环境下对比,YOLOMS各项指标最优:mAP50达到0.896,精确率0.906,召回率0.876,F1为0.873;四类缺陷的平均精度均在0.8以上,点蚀类达到0.955。
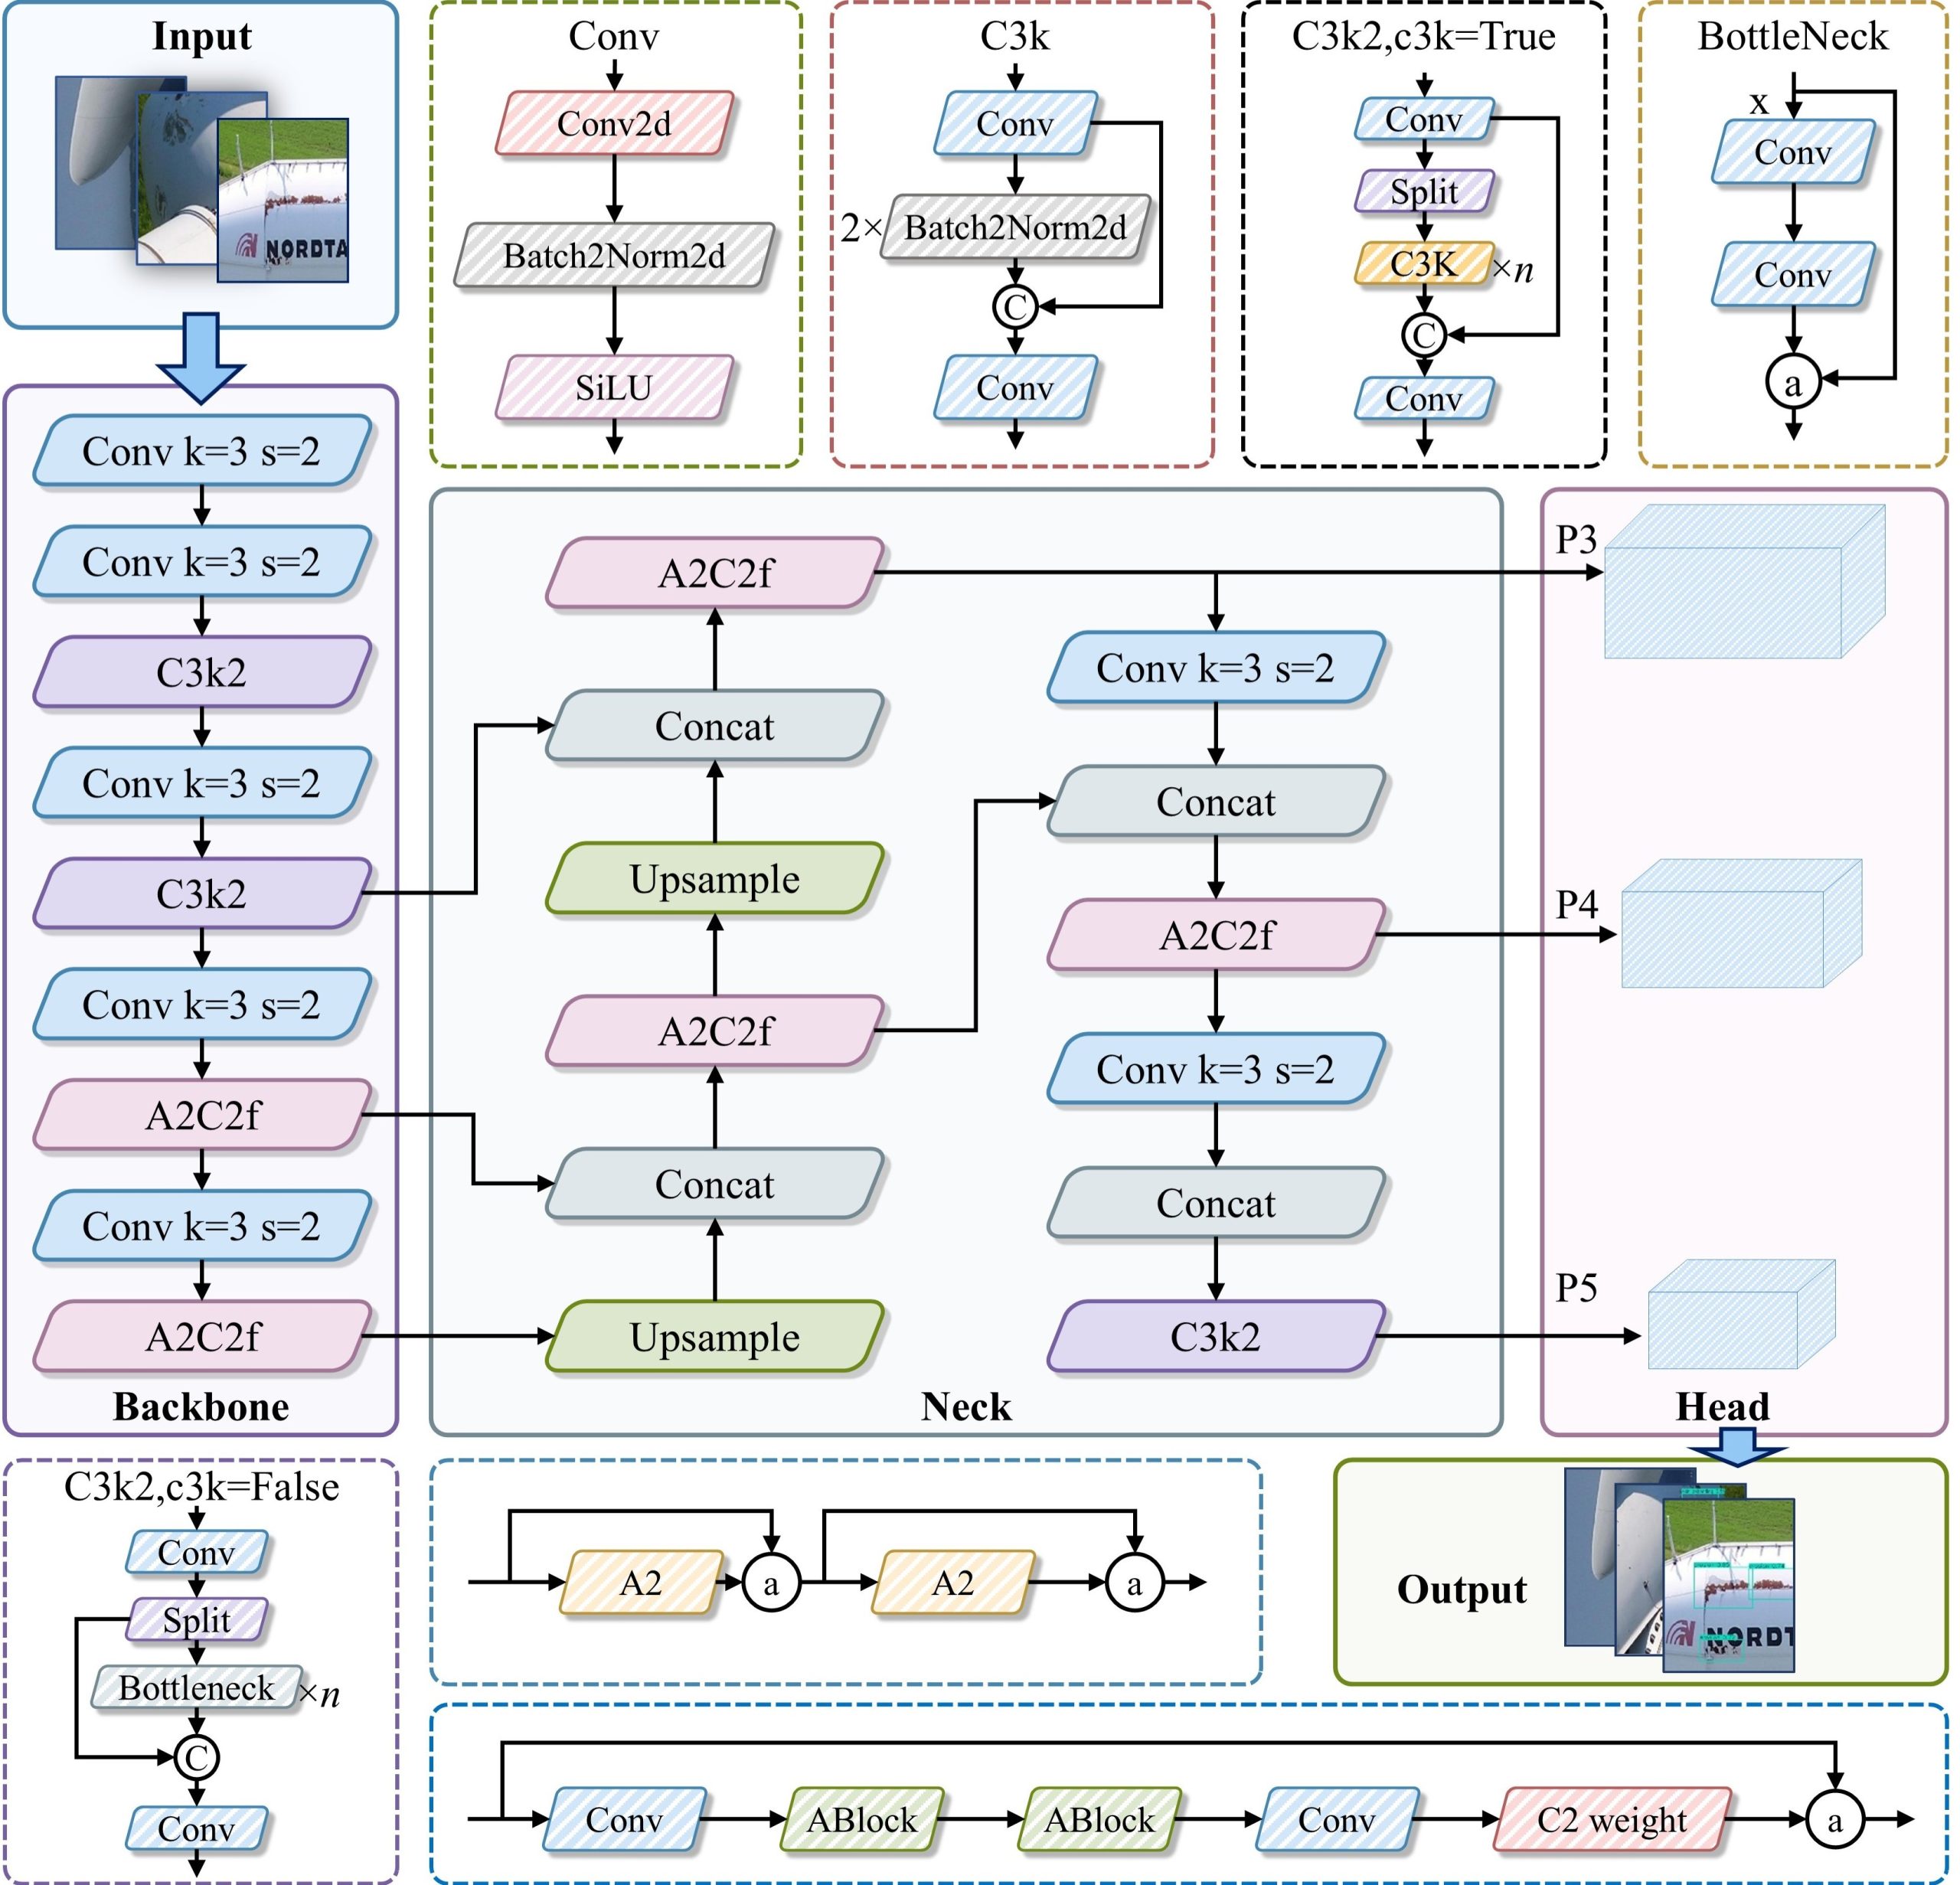
第二段是轻量键值(KV)映射模块。它把检测框的向量标签转换成简洁的文字描述,既保留类别、位置等定性属性,也带上可比较的定量属性。这一步的关键是把视觉输出“翻译”成大模型能稳定消费的输入,而不是让多模态模型自己去猜框的含义。
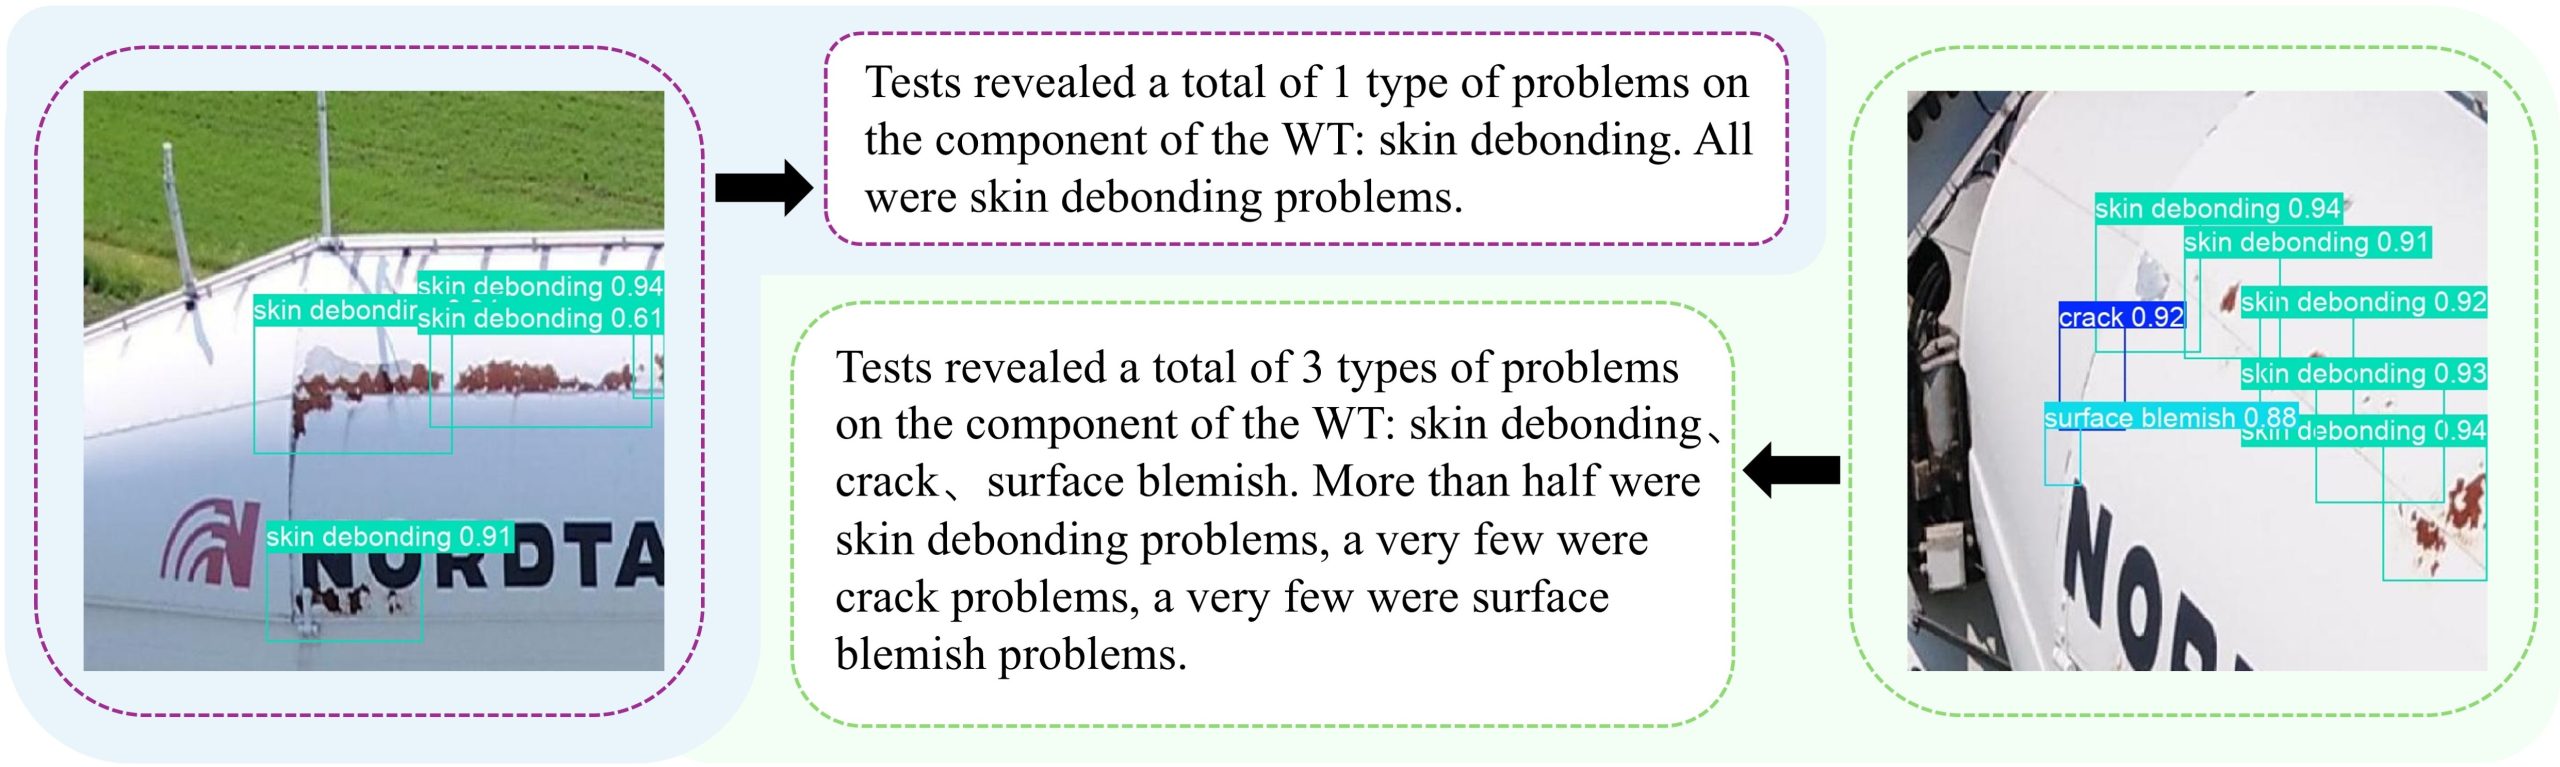
第三段是多模态大模型与领域微调模型接力。Qwen2-VL接收YOLOMS输出的图像和KV生成的文字,进一步分析并生成文本;微调的Llama负责汇总前序信息,识别要点、建立信息之间的关联,再结合领域知识与历史案例给出检修建议。
两个指标卡住“最后一公里”
视觉部分用常规检测指标评估,语义部分则要新的尺子。文本与检测类别的一致性用故障一致性分数(FCS)衡量:统计YOLO实际检出的类别数,与大模型文本中正确匹配的类别数之比,全采样后平均值为0.94,说明两者在类别识别与表述上高度一致。
报告质量用平均精度分数(APS)评估,关键词围绕诊断内容的核心与完整性设置。最终,框架的故障检测准确率为90.6%,生成的检修报告平均准确率为89%。
这套接力说明了一件事:工业视觉的“最后一公里”不在检测精度,而在把检测结果翻译成能被人执行的语言。翻译层做扎实,检测模型的价值才会真正进入工单。
资料来源:LLM-YOLOMS: Large Language Model-based Semantic Interpretation and Fault Diagnosis for Wind Turbine Components — arXiv(2025)。本文为技术要点整理/编译,非原文全文。