

仓库运营靠标准作业规程(SOP)运转:从机器人输送线在几分钟内把阈值越界追到根因,到库存工单逐条查询状态、校验约束、跨多个系统提交实物拣选,都是带规定步骤、依赖关系、量化阈值和硬约束的决策路径。这些流程目前大量靠人工执行,慢且易错,诊断延迟直接吃掉吞吐。但智能体框架 ReAct、Reflexion 这类做法只给了松散的结构化提示,没有强制遵守SOP的机制,能力再强的模型也可能偏离规定路径。
更麻烦的是上下文过载:把完整SOP塞进视野,复杂流程会压垮模型选择相关动作的能力。arXiv 上的 Eluna 给出的解法是,把SOP本身变成智能体能读懂的执行结构。
五种节点与两种披露粒度
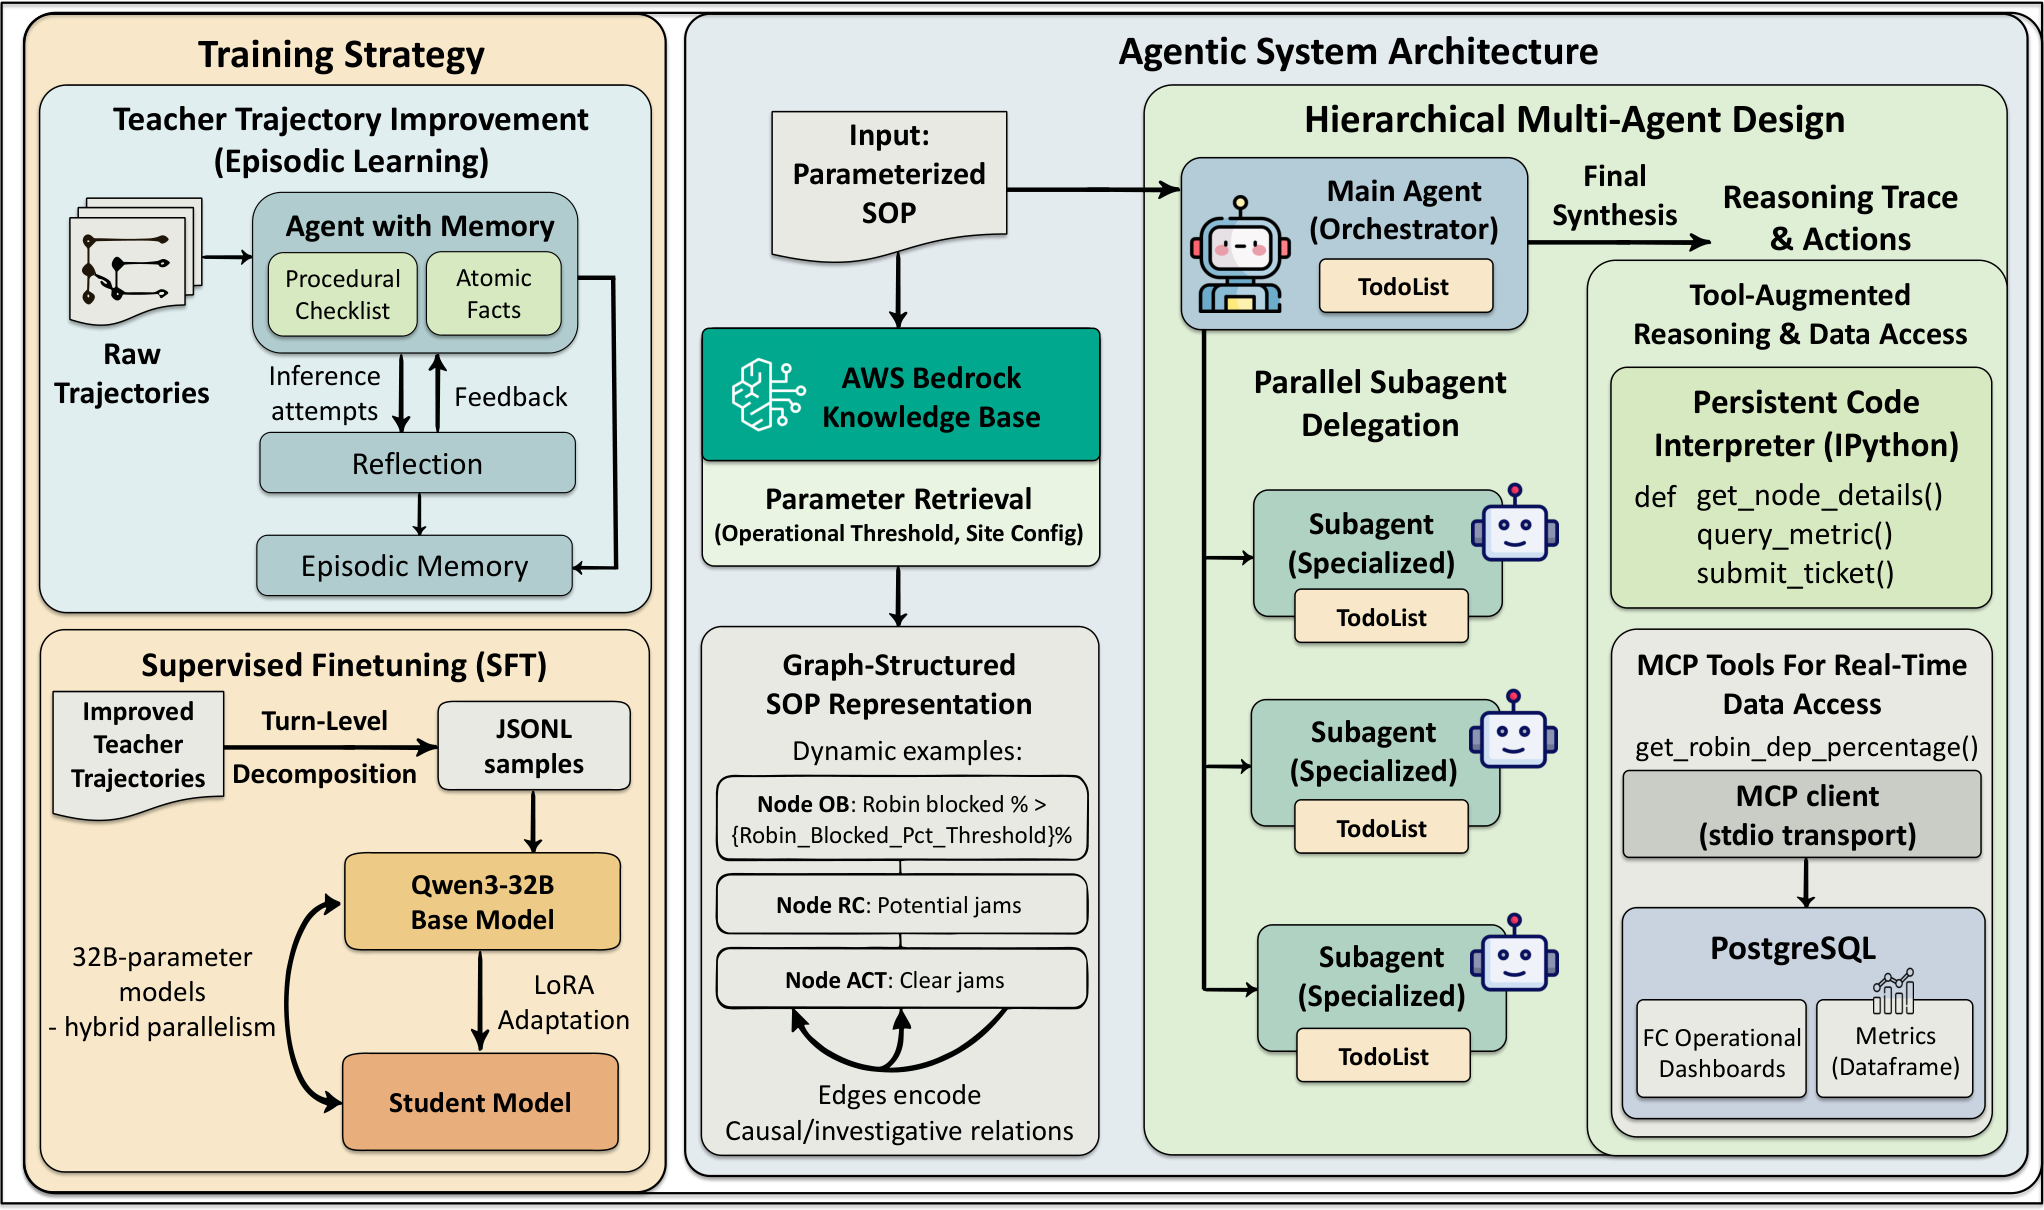
每条SOP被编码成有向无环图(DAG),节点分五类:观察(可检测条件)、根因(诊断出的原因)、计算(指标分析)、约束(前置条件)、动作(处置)。每个节点带参数化规格,定义评估过程,输出布尔值、分类结果或计算值。边表示依赖:单节点边按父节点的布尔结果激活子节点,多节点边要求多个父节点同时成立。
完整图不能一次给。检索工具从触发节点做广度优先搜索,只返回可达子图,包含节点类型、边关系和简要描述;每个节点的完整规格——评估逻辑、所需工具调用、阈值——要等智能体真正开始评估它时才取。工作上下文被限制在一个节点,避免在多分支路径里混淆、漏节点或钻进无关子树。
主智能体遍历,子智能体并行
框架是两层结构:主智能体持有检索到的子图,按边依赖挑出下一批待评估节点,发出委派调用;子智能体拿到全新上下文,只包含被分配节点的规格、角色指令和工具。动作节点留在主智能体,因为它们需要图级状态来做排序和约束检查。
同一轮发出的多个委派并行执行,墙钟时间约等于最慢的一次评估。只有结构化结论回流,主智能体的上下文每节点只增加一条摘要,而不是整段调查历史;子智能体会话保留,主智能体可追问细节而不必重跑;子智能体不能再派生下级。每个用例打包成一个Skill:决策图、专用工具、节点规格、执行指令按需加载,新流程不必另建系统。
非对称情节蒸馏
训练分三步。强教师模型在完整框架内生成轨迹,情节学习(episodic learning)把过去错误的文本记忆注入提示,在不改权重的情况下迭代修正;随后用拒绝采样加LLM裁判,只留下正确轨迹;最后让满足生产延迟SLA的学生模型在这些轨迹上微调,并把情节记忆剥离。
所谓“非对称”,指情节学习只作用在教师侧。学生训练和推理都看不到记忆,必须把修正内化进权重,运行时不需记忆库。实验用LoRA微调Qwen3-32B与GLM-4.5-Air,训练样本8525条;教师GLM-4.7有355B参数,因延迟不达标只作轨迹生成器。
结果
评测分三块:13类任务、1400条样本的运营推理基准;1500个真实场景的机器人输送诊断;以及一条46节点库存归并SOP、410张真实工单,由专家标注评估。在两个可确定真值的任务上,细调模型平均比基线高6.5%(Eluna-G)和6.0%(Eluna-Q),并匹配教师;未微调的Qwen3-32B平均低于基线38%。端到端执行中,观察二分类正确率提升逾49%,根因逾73%,动作精确匹配提升165%;中位端到端延迟下降约54%。工单应用上,专家一致率达到94%。
这套方法的启示不在“让模型更会推理”,而在把流程约束从提示词里拿出来,变成图结构、节点规格和训练信号。流程越复杂,结构化的收益越大。
资料来源:Eluna: An Agentic LLM System for Automating Warehouse Operations with Reasoning and Task Execution — arXiv(2026)。本文为技术要点整理/编译,非原文全文。