

预测性维护里最难的不是模型结构,而是数据形态:关键工况极其稀有,瞬态窗口极短,目标变量又被外部协变量牵着走。航空压力调节关断活门(PRSOV)就是典型——它的内部退化不可直接观测,只能靠歧管压力(MP)相对健康基线的偏差来判断;一次关键调节工况在每个飞行循环只出现一次,典型瞬态只有18个数据点,而MP又被动地受发动机高压转子转速(N2)与上游中压(IP)驱动。
为什么不直接上时序基座模型
时序基座模型(TSFM)在开放域很强,但工业场景的数据分布往往在预训练经验之外。更现实的问题是三条:关键工况样本太少,深度模型学不到有效表征;短瞬态若按固定长度填充(例如把18点补到64点),噪声会淹没真正的瞬态特征;只按目标曲线形状检索,容易找到“长得像但驱动逻辑不同”的历史片段,预测随之发散。
已有的时序RAG方案多依赖可学习适配器或静态向量化,前者在稀缺工况下难以收敛,后者又会把短序列压缩成失去幅值精度的嵌入。RAG4CTS的选择是:不向量化、不微调,直接在原始数据空间里检索。
按工况树存原始序列
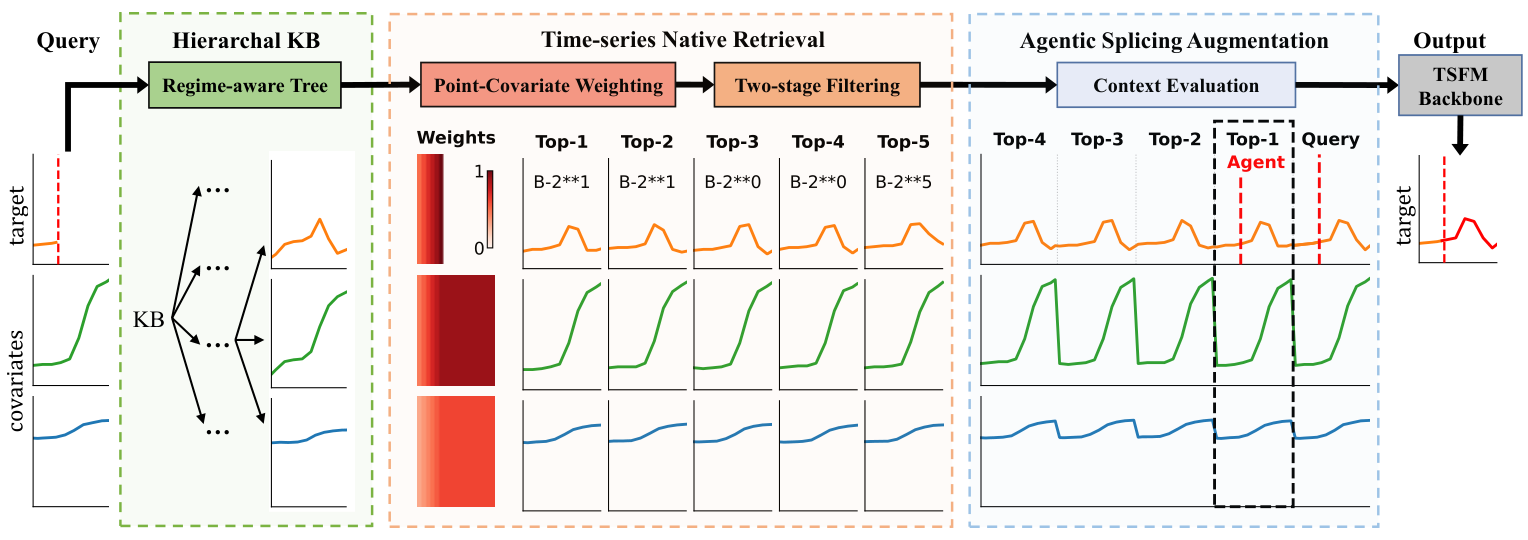
它构建了一个分层知识库:根节点是机型(如B777),下一层是机尾号,再到具体工况实例(如PRSOV L),叶子节点存完整的原始多变量序列。检索路径本身就是元数据索引(root.group.device.sensor),不做切片、不做填充,因而保留了每个运行循环的机械完整性与数值精度。
双权重检索:关键点与协变量
检索分两阶段,权重由两部分相乘。其一是关键点权重:越靠近当前的状态与已知的未来控制输入,权重越高,并按衰减因子λ优先近期动态;同时把未来目标值掩掉,确保距离只在“历史+已知协变量”上计算,不偷看知识库里的真值。其二是协变量权重:用互信息衡量每个协变量对目标的不确定性削减,捕捉非线性物理耦合。对PRSOV来说,IP因结构上更近而具有更强、更直接的气动影响,N2是次级上游变量,权重会据此倾斜。
检索出候选后,系统用Top-1结果作为“动态代理”校准上下文拼接,而不是固定取k条。论文把这称为agent驱动的上下文增强:不同查询的k值差异很大,固定数量并非最优。
实验与上线表现
数据来自南航的CSA-PRSOV数据集,按机型(B777/A320)与发动机位置(左/右)分成四个子集;知识库用2023–2024年样本,2025年样本作查询,较新的飞机只有91条历史样本。任务是用N2与IP两个协变量预测MP的短期瞬态,历史12点、预测6点,基座模型为Chronos-2。
结果上,RAG4CTS在三类对照方法中都取得最低误差:标准深度预测器(如PatchTST、TimeMixer、iTransformer、Pyraformer)、零样本TSFM与TS-RAG。消融实验给出几个清晰边界:知识库从单架飞机扩到同机型机队,MSE从0.103降到0.058,说明同机型内的运行逻辑可迁移;再加入A320跨机型数据收益递减,机体物理差异带来的分布漂移抵消了数据量优势;检索度量用“余弦+矩阵轮廓”组合最好(MSE 0.077),加入DTW反而变差,因为时间弯曲会破坏瞬态分析需要的严格时序。
系统已部署在南航的Apache IoTDB中。据论文报告,上线两个月内成功识别出一次经确认的PRSOV故障,零误报。对高风险工业场景而言,“少报一次”和“误报一次”的代价并不对称,这个结果比单纯的MSE更有说服力。
资料来源:Retrieval-Augmented Generation with Covariate Time Series — arXiv(2026-03)。本文为技术要点整理/编译,非原文全文。