

用大模型做排产、配料、路径优化,常见评测方式是给一段完整的题目描述,看它能不能写出目标函数和约束。这能测“会不会建模”,却测不出工程师真正的工作:在文档、参数表、旧代码和求解器日志之间来回对照,改一版模型,再把结果讲给不懂数学的人听。OR-Space 把工作区本身搬进了评测。
一个工作区,而不是一段提示
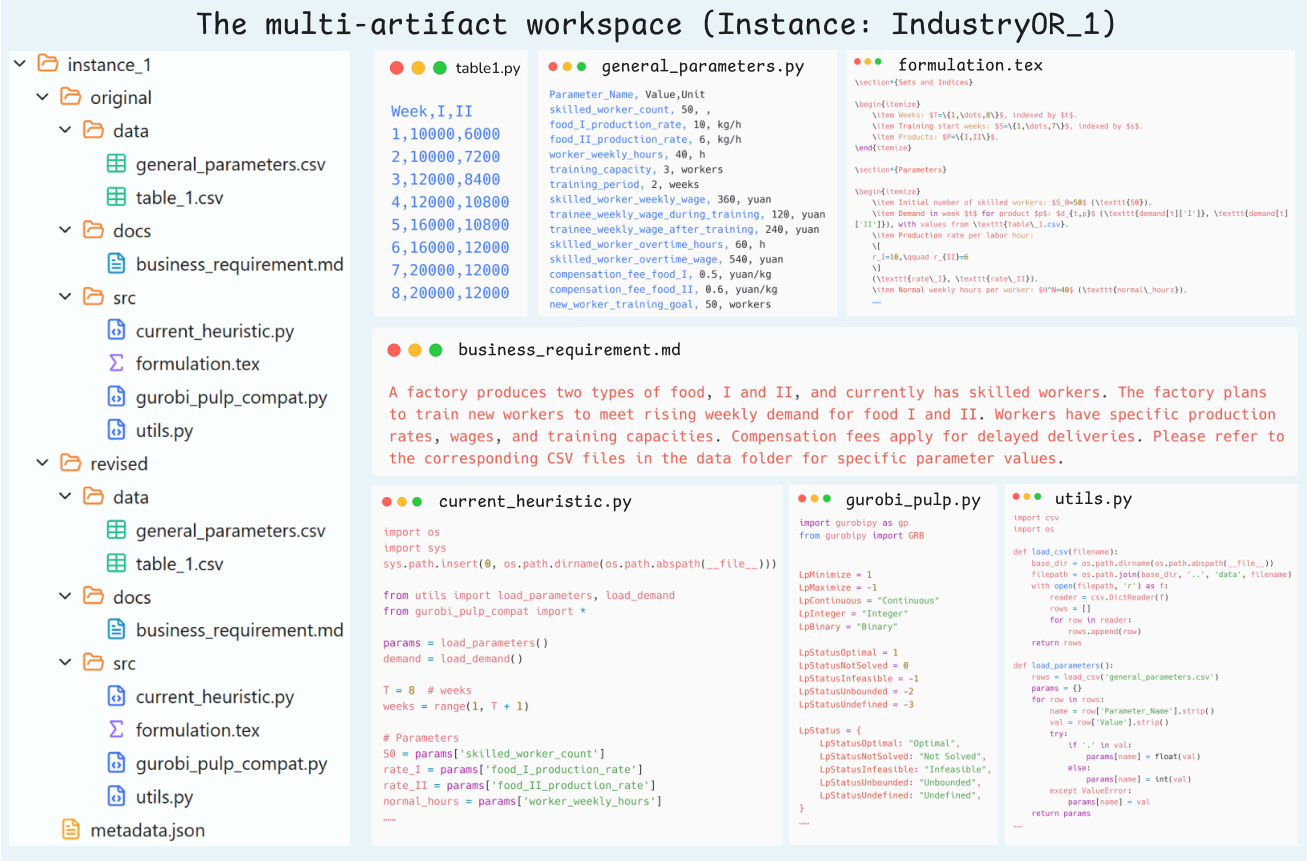
每个实例是一个可执行工作区:docs 里是业务需求与修订要求,data 里是 CSV 或 JSON 参数,src 里可能是空的脚手架,也可能是可运行的旧实现,另配 Docker 沙箱负责文件读写、求解器执行和输出捕获。参数文件允许缺失值、schema 不一致、混合编码和跨文件依赖——这些都得先清洗再建模。评测指标由 harness attached,智能体看不到。
任务分三段。Build:从需求文档和参数表构建可用模型,统一到 pulp.LpProblem 接口,后端默认 Gurobi,并在 COPT、HiGHS 上做跨求解器校验。Revise:在需求变化后修改既有工作流,分“只改代码”“只改造型”“两者都改”三个变体,要求保留未受影响的逻辑,支持变量插入、约束修改和多周期扩展。Explain:拿到求解输出后,回答关于解、约束、假设和业务含义的问题,评分项包括覆盖度、推理、证据落地、答案质量和幻觉惩罚。
300 个实例怎么来的
基准把 IndustryOR 的 100 道基础优化题扩展成三种任务,每种 100 个,共 300 个实例。生成分两步:先写出贴近真值模型的干净规格,再改写成面向业务的真实工作区,加入领域术语、对话式冗余、不一致的 schema 引用和组织化噪声。修订实例在合成阶段要做两次构建执行检查,确认新增约束不会悄悄让未受影响的部件失效或压缩可行域。
结果:建模仍然难,解释是另一种能力
最强的 Build 成绩是 72.0%(gemini-3.1-pro),多数前沿模型落在 53% 至 68%。Revise 暴露了“旧代码是信号还是噪声”:gemini-3.1-pro 从 72% 升到 81%,gpt-5.4 从 59% 升到 79%;但 gemini-3-flash 掉了 23 个百分点,qwen3-32b 掉 12 个百分点——只有能把可复用的数学结构与不该照抄的实现细节分开的智能体,才吃得到这份上下文红利。
Explain 与 Build、Revise 并不高度相关:Build 与 Revise 的相关系数为 0.82,Explain 对二者分别只有 0.16 和 0.28。gpt-5.4 的 Explain 得分最高(86.52);而 gemini-2.5-pro 能解 69% 的 Revise,Explain 只有 32.2;gemini-2.5-flash 的 Revise 为 66%,Explain 仅 13.79。会算不等于会讲,这一点在只看求解正确率的评测里完全不可见。
接口形态也有影响。把工作区压成一段扁平提示、不给文件系统工具,Build 平均掉 8.2 个百分点(gpt-4o 掉 19,qwen3-max 掉 11),Revise-code 平均掉 12.2 个百分点;Explain 却几乎不变(+0.3)。作者的解释是,找文件、看 schema、写对路径并不是装饰性的接口细节,而是建模难度的一部分。
求解器与失败类型
换后端会改变绝对分数与任务画像。Gurobi 的目标任务均值最高(57.2),Explain 也最高(64.9);PuLP 在目标类任务上接近,Revise-code 最好,原因可能是评测用的就是 PuLP 自带的启发式代码,上下文更对齐;COPT 对高能力模型与 Gurobi 相当,但轻量模型明显更低,作者归因于预训练语料里 Gurobi 的曝光更多,而不是求解器本身的数学能力差异;HiGHS 的跨任务波动最小(9.9)。Gurobi 与 COPT 的模型排名大体一致(ρ=0.73),但单个智能体的绝对差距可能很大——单一后端会把建模能力与求解器接口敏感度混在一起。
失败分析里最有价值的一条是“能跑但算错”。在 20 个模型各 100 个 Revise 实例的提交中,WrongValue 占 19.1%,RuntimeError 占 18.2%:大量失败已经通过解析、建模和求解器调用,只是把数学问题编码错了。旧代码还带来特有的工程错误:module_not_found 从 Build 的 0.4% 升到 Revise 的 2.8%,NameError 从 0.2% 升到 2.2%,这是“上下文中毒”的量化特征——智能体沿用了旧实现的导入、变量名和控制流假设,却没有把它们重新落地为求解器变量与约束。
资料来源:OR-Space: A Full-Lifecycle Workspace Benchmark for Industrial Optimization Agents — arXiv。本文为技术要点整理/编译,非原文全文。