

工业现场的多机器人协作,难点通常不在“会不会抓”,而在“先做什么、谁来做、做完再做什么”。工序之间有严格的先后约束,机器人和工位又是互斥资源,一旦排错,整条线都要停下来等人改程序。IMR-LLM 这篇论文给出的思路是:把高层任务规划交给大模型理解,把资源冲突交给确定性求解器,把低层程序生成交给一棵“工序过程树”。
先让模型只说清楚三件事
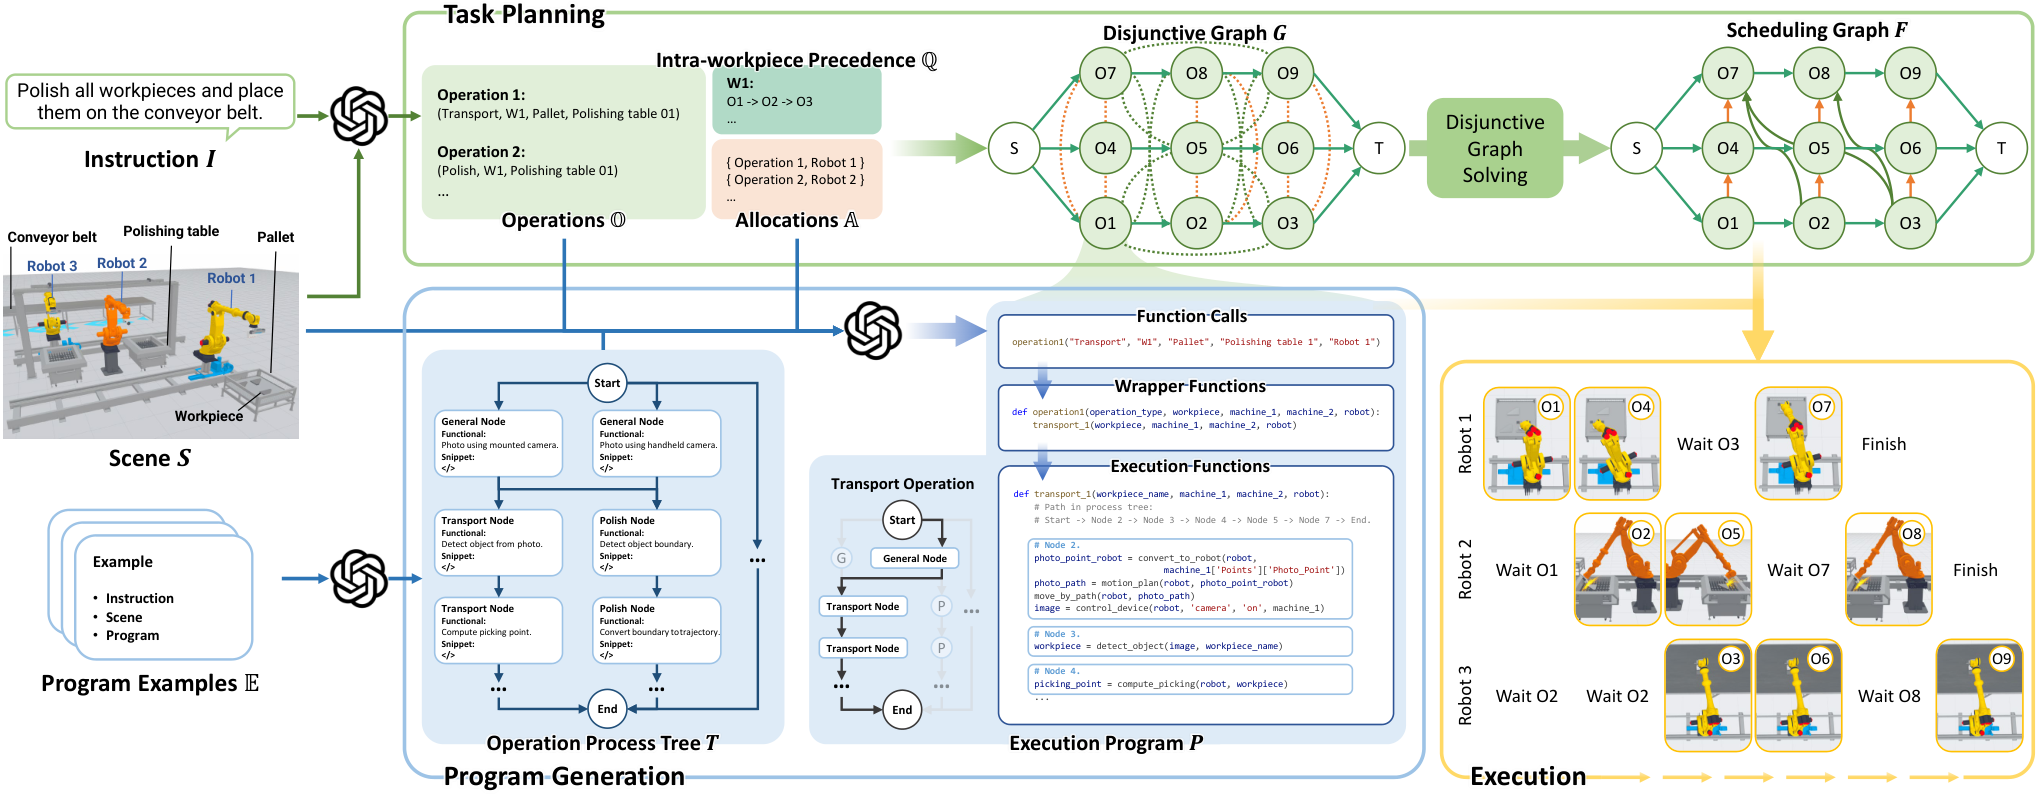
输入是场景描述(机器人、设备、工件的 JSON)和一段自然语言指令。模型通过思维链推理,输出三样东西:操作集合、机器人分配集合,以及每个工件内部的工序先后关系。它刻意不去直接排出全局执行顺序——那是传统方法最容易翻车的地方。
这三样输出随后被转成一张析取图(disjunctive graph):每个操作是一个顶点,同一工件内的先后关系是合取弧,两台操作争用同一台设备或同一台机器人时,则连一条无向的析取边。图的求解采用 FIFO 启发式,按操作集合里的先后次序决定互斥资源的占用顺序。论文强调,这样安排之后,模型不需要处理复杂的资源冲突,分析负担大幅下降;而图的求解过程可解释,工程师能在车间里逐条复核。
过程树替代“给几个例子”
低层程序生成没有沿用上下文示例的做法。作者观察到同类工序的执行流程高度一致,例如打磨通常是:拍照、检测边界、计算轨迹、移动到起点、沿轨迹打磨、回到初始位。差异只出现在产线配置上——相机装在支架上还是由机器人手持,拍照方式就不同。于是他们让模型先把所有程序示例切分成功能段,把功能相同且实现相同的段合并,保留分支以表达不同变体,最终得到一棵覆盖全部工序的过程树。生成程序时,这棵树替代了示例提示,公共动作步骤还能跨工序复用。
基准与实测
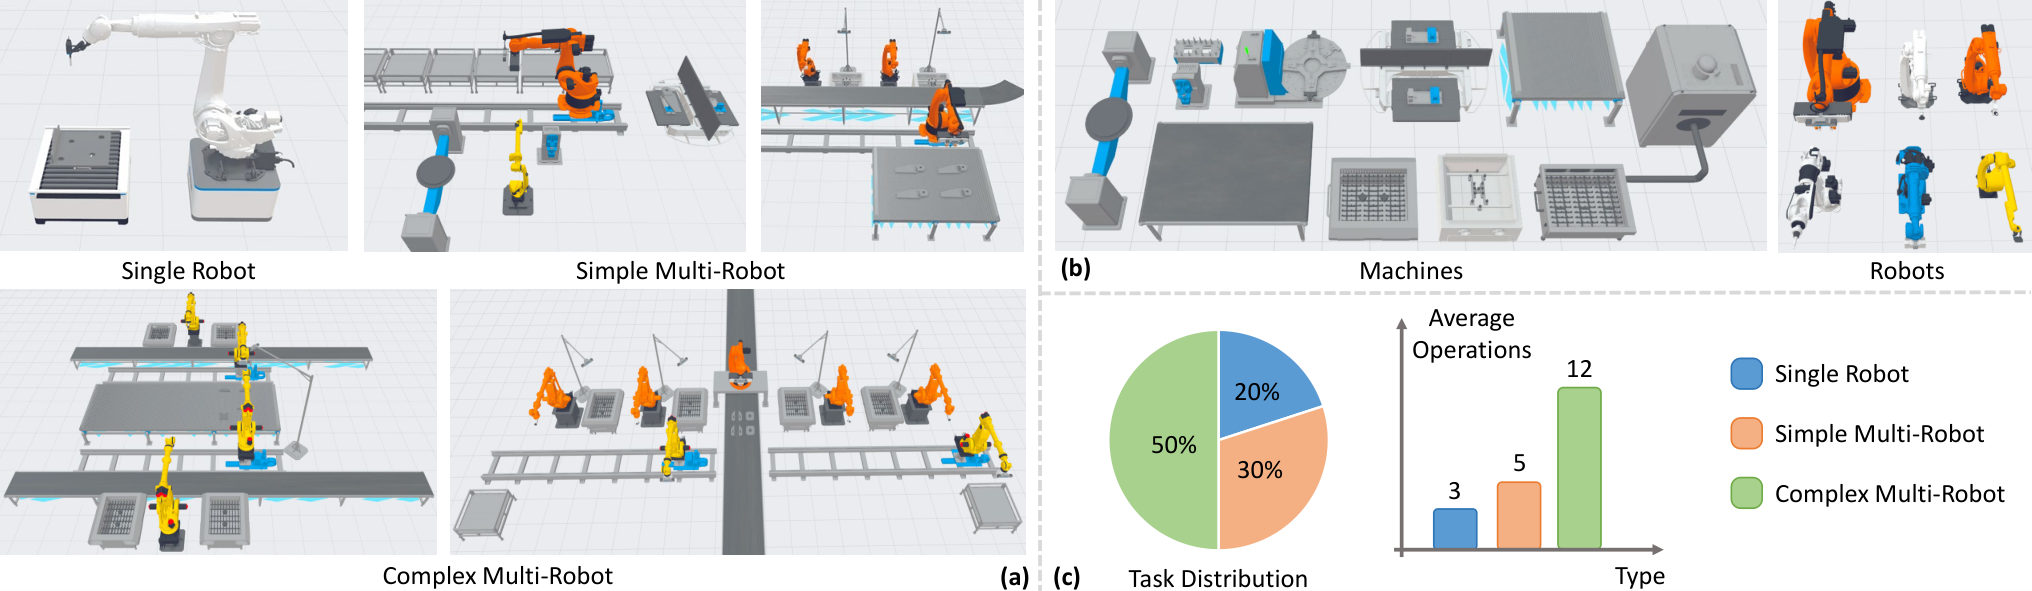
IMR-Bench 建在 KunWu 平台上,包含 23 个由产线设计专家从真实工业环境采集和改造的场景,每个场景 1 至 7 台机器人,共 50 个制造任务,分三档:单机器人任务不超过 5 道工序;简单多机器人任务不超过 3 台机器人、10 道工序;复杂任务最多 7 台机器人、24 道工序,并行与串行混合。评价指标包括操作一致性、调度效率、可执行性、目标条件召回率和成功率。
与 SMART-LLM、LaMMA-P 的两个变体、LiP-LLM 的变体相比,论文报告本方法在全部指标上领先:析取图带来最高的操作一致性与调度效率,过程树提升了程序的可执行性与目标召回。消融实验显示,去掉析取图后调度效率明显下滑,多机器人任务尤甚;去掉过程树后,程序可执行性和目标召回显著下降。换用开源 Qwen3-32B-thinking 后表现接近,说明方法不完全依赖某个闭源模型。
真实场景验证用了三台机械臂,各自带末端执行器,并能控制支架上的相机定位工件,三台协同把工件放上传送带。专家手工编写场景描述约花 15 分钟,规划与程序先在仿真中核对安全性和正确性,再直接下发到真机执行。局限也写得清楚:任务越复杂,模型越容易给出次优甚至错误的分解与分配,例如把工序派给够不着的机器人;上下文变长后幻觉和逻辑不一致增多,复杂多机器人任务的成功率因此下降。
资料来源:IMR-LLM: Industrial Multi-Robot Task Planning and Program Generation using Large Language Models — arXiv。本文为技术要点整理/编译,非原文全文。