

动态柔性作业车间调度(DFJSP)是典型的 NP-hard 问题:每道工序可以落在多台候选机器上,新订单到达、机器故障等事件又在实时发生,排产必须不断重算。把车间状态写成提示词、让大模型直接选下一步动作,看起来很自然,但论文发现这种做法稳定地不够好。
先找出三个“坑”
作者把直接让大模型排产的失败原因拆成三条,并逐条做了实验。第一是“长上下文悖论”:机器加工时间、工件结构等静态信息占了提示词七成以上,但把这些内容整块删掉,完工时间的中位数比值几乎还是 1.0,说明模型并没有真正用上这些基础数据。第二是专家启发式被架空:团队构造了 PDR-Bench,每个实例都预先设计成只有某一条优先派工规则最优;模型即使用户明确要求使用这条规则,表现仍比不上单独执行该规则,往往会退回预训练学到的泛化行为。第三是短视贪心:逐 token 生成让模型倾向局部最优,贪心决策比例在各模型上持续偏高,一个局部选择就可能把下游堵死。
把“慢思考”和“快决策”拆开
ReflecSched 的做法不是让模型算得更快,而是改变它在调度中的角色。框架分两个模块:分层反思模块负责长程策略,经验引导决策模块负责实时执行。
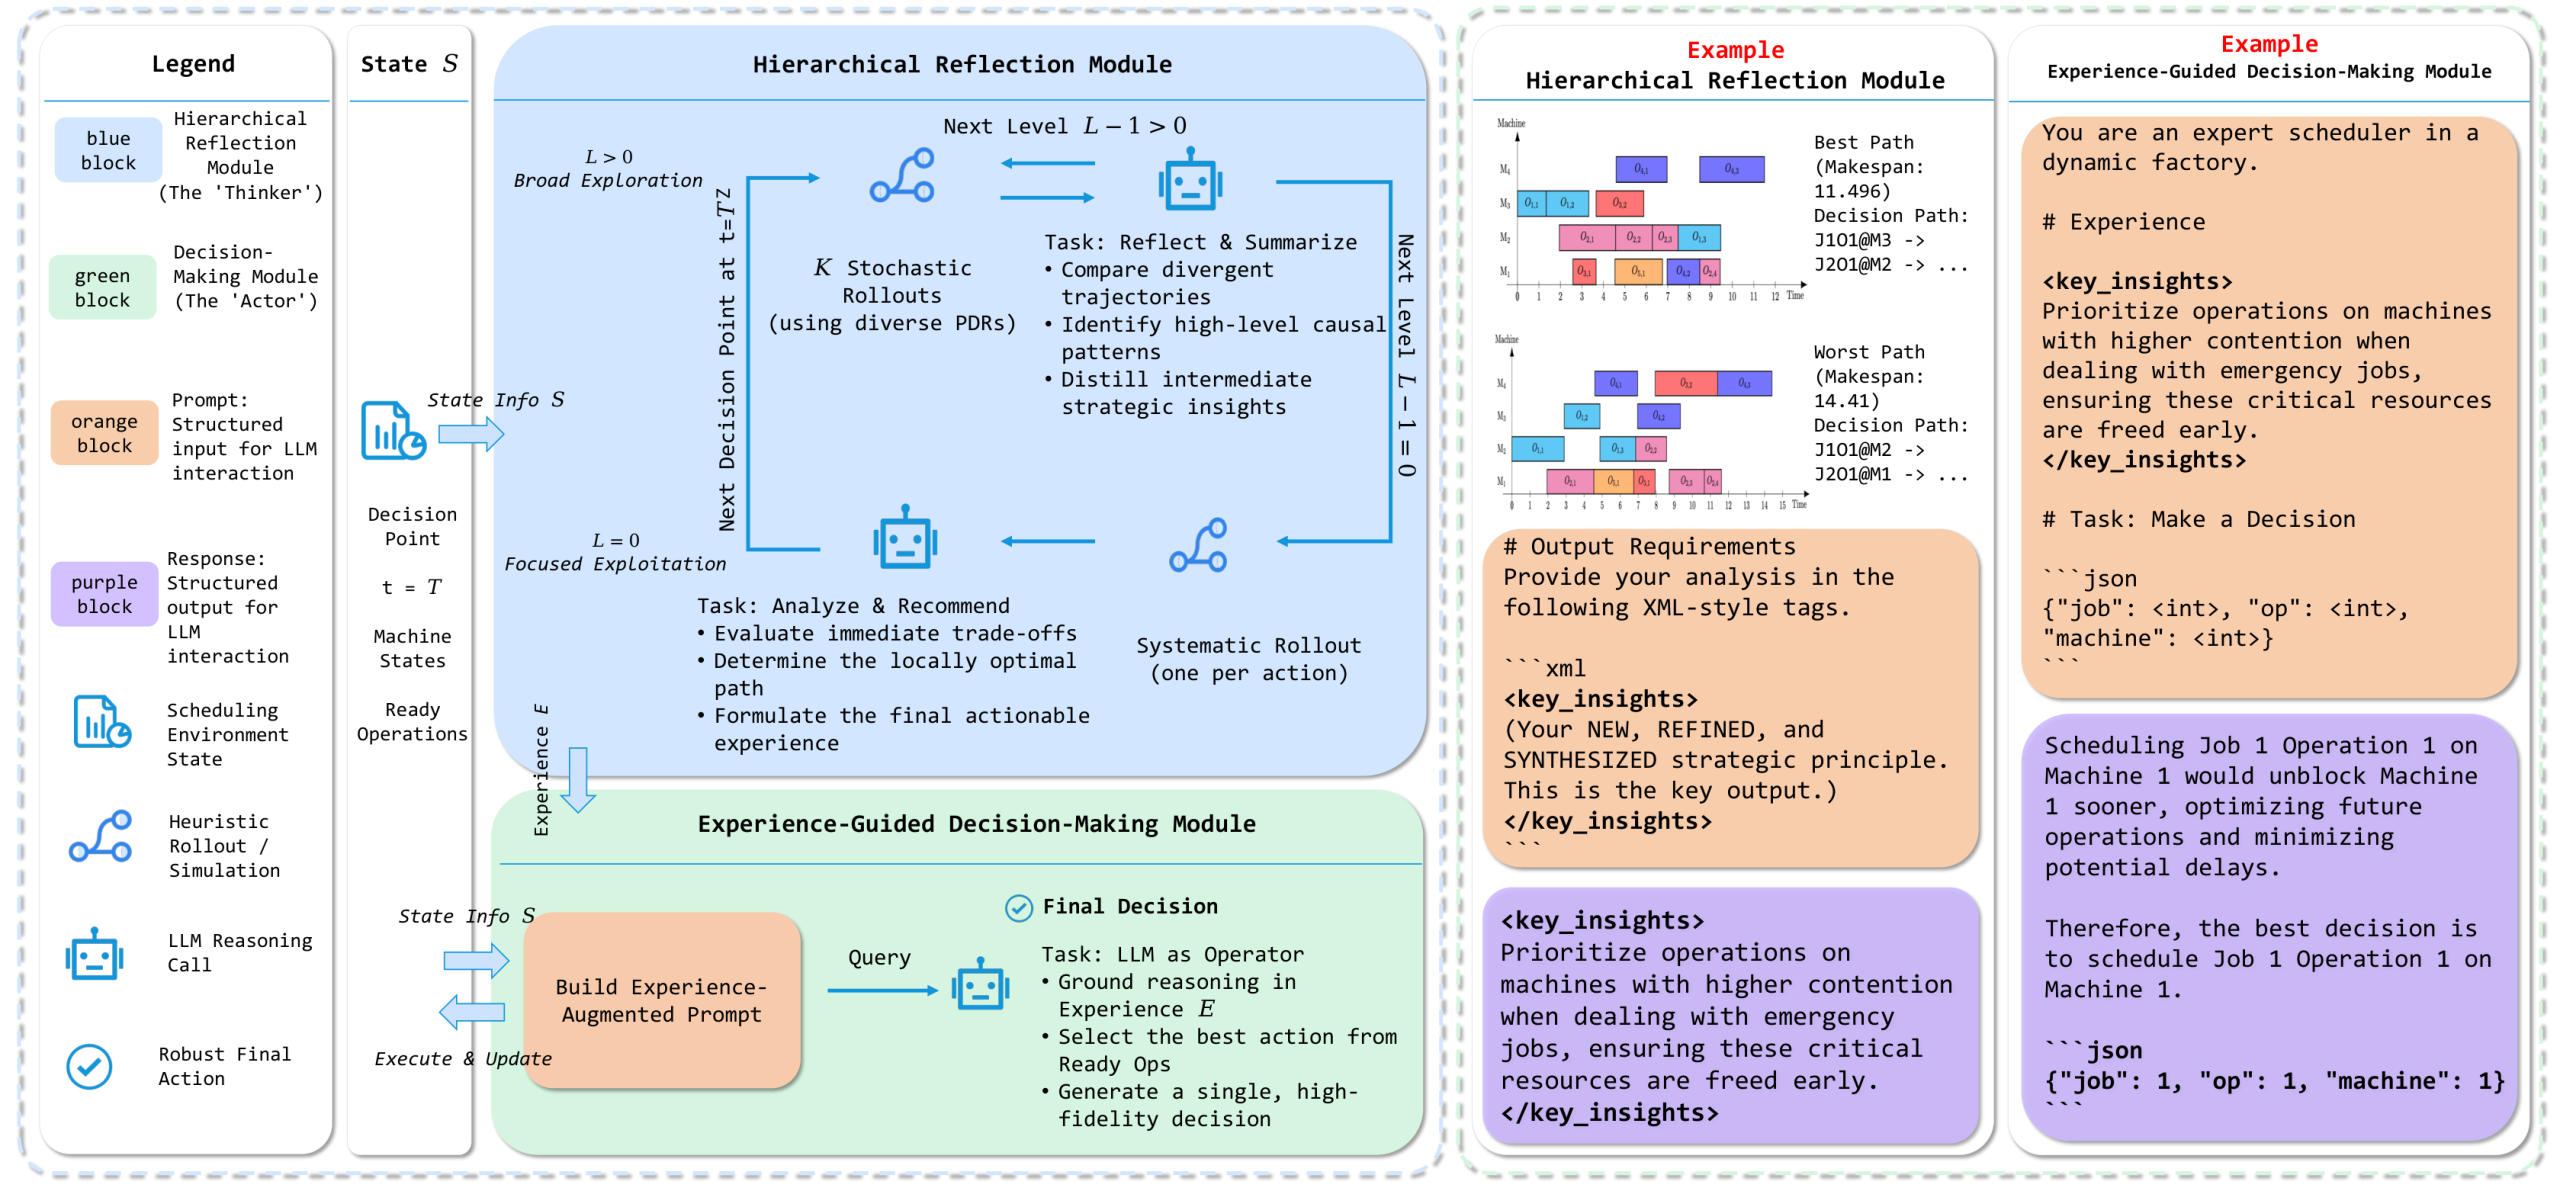
分层反思采用“模拟—反思—精炼”的循环。它以随机基础策略在多个层级上推演未来:高层做稀疏的长程探索,底层对每个可行动作做短程 rollout,基础策略每一步从预定义规则池里采样一条派工规则。推演结束后,模块挑出本层代价最小和最大的两条轨迹,交给大模型对比,提炼出一段简短的“策略经验”(Strategic Experience)。这段经验只在动态事件发生时重新生成,比如新工件到达或机器故障,因为这类事件会让旧经验失效。
最终决策时,提示词只放当前状态和这段策略经验,不再塞入完整车间快照。这样既压掉了长上下文噪声,也让专家规则通过 rollout 真正参与推理。
数据说明了什么
实验覆盖 GPT-4o、DeepSeek-V3 和 Qwen3 的 8B、14B、32B 版本,反思深度取 6 层、每层 24 次 rollout。相对直接让大模型决策的基线,ReflecSched 取得 71.35% 的平均胜率和 2.755% 的相对偏差下降,Wilcoxon 符号秩检验 p<0.05;它也优于所有单独评估的派工规则,并与“为每个实例挑最强规则”的上界没有显著差异(p>0.05)。消融显示,只做单层搜索、把 rollout 数量从 1 加到 24,性能会平台化甚至变差,说明分层带来的前瞻性才是主要来源。
这套方法还有一层理论解释:把反思产出的经验视为对基础策略的策略改进,在“rollout 代价近似真实代价”和“模型忠实综合”两个假设下,可以继承 rollout 算法的性能不劣保证。假设无法对黑箱模型形式化证明,但实验中的稳定增益说明它们在实践中大致成立。
对车间落地而言,关键不是让大模型替代 APS,而是把它放在“策略层”:事件触发时做一次较重的推演和复盘,平时用轻量提示快速决策。这样既保留了启发式的可解释性,也补上了单条规则看不到的长程后果。
资料来源:ReflecSched: Solving Dynamic Flexible Job-Shop Scheduling via LLM-Powered Hierarchical Reflection — arXiv(2025-08)。本文为技术要点整理/编译,非原文全文。