
流程工业的状态监测系统(CMS)早就能检测和分类故障,但“这个轴承磨损到什么程度”“还能撑多久”“该不该现在停机”仍要分析师判断。结果是报警越积越多,虚警挤占精力,真正严重的退化反而被淹没。MindRAG 的做法不是再训一个诊断模型,而是给分析师配一个能查库、能算信号、能解释来源的智能体:把设备层级、标注、工单和振动信号组织成一个多模态向量库,让大模型在这个库上做检索增强生成。
难点不在模型,在数据结构
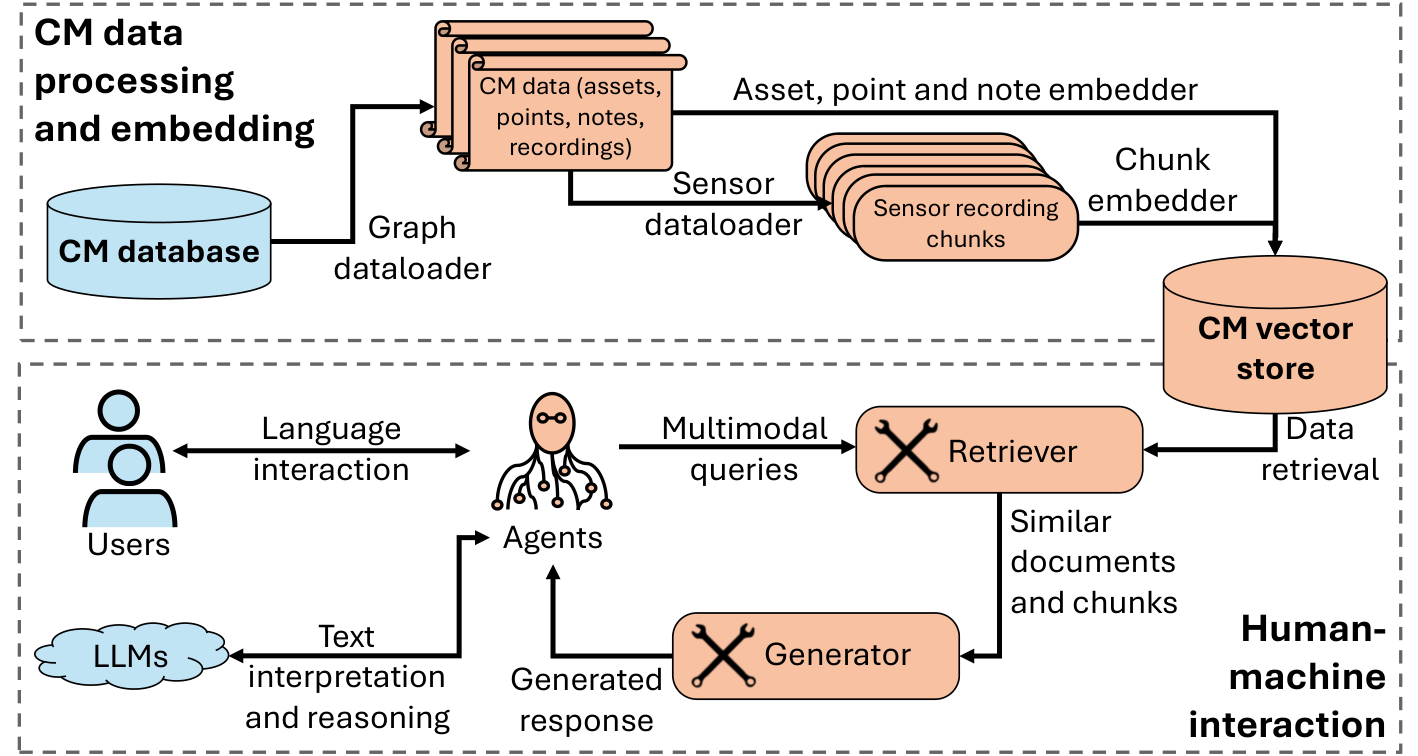
工业 CMS 数据库通常按“工厂—机组—设备—测点”组织成树,标注与维修工单则散落在文本里。MindRAG 先把机器层级图抽出来,作为检索的骨架;再把标注、工单描述与信号特征一起写成半结构化的、类图的向量库。每条记录既带语义嵌入,也带层级路径、时间戳与测点属性,检索时可用过滤器限定“哪台设备、哪个测点、哪段时间”。
更关键的是标签问题:公开的工业状态监测数据集几乎没有可靠的故障发展标签。MindRAG 用标注与维修工单作为“替代标签”,把历史上“某测点在某段时间被记为某类故障”当成弱监督信号,从而在没有干净标签的情况下训练与评估。
检索是加权拼出来的
普通 RAG 只比文本相似度,这里要同时比层级、标注、信号与时间。系统定义了多种距离与打分:层级路径的匹配、文本描述的相似度(含 BLEU 之类的词面度量)、信号特征的相似度,以及时间邻近性。最终分数按权重矩阵归一化后相加,其中标注与信号嵌入的权重是其他度量的五倍——这是作者给出的经验设定,也可在工具调用时调整。
四个智能体分工
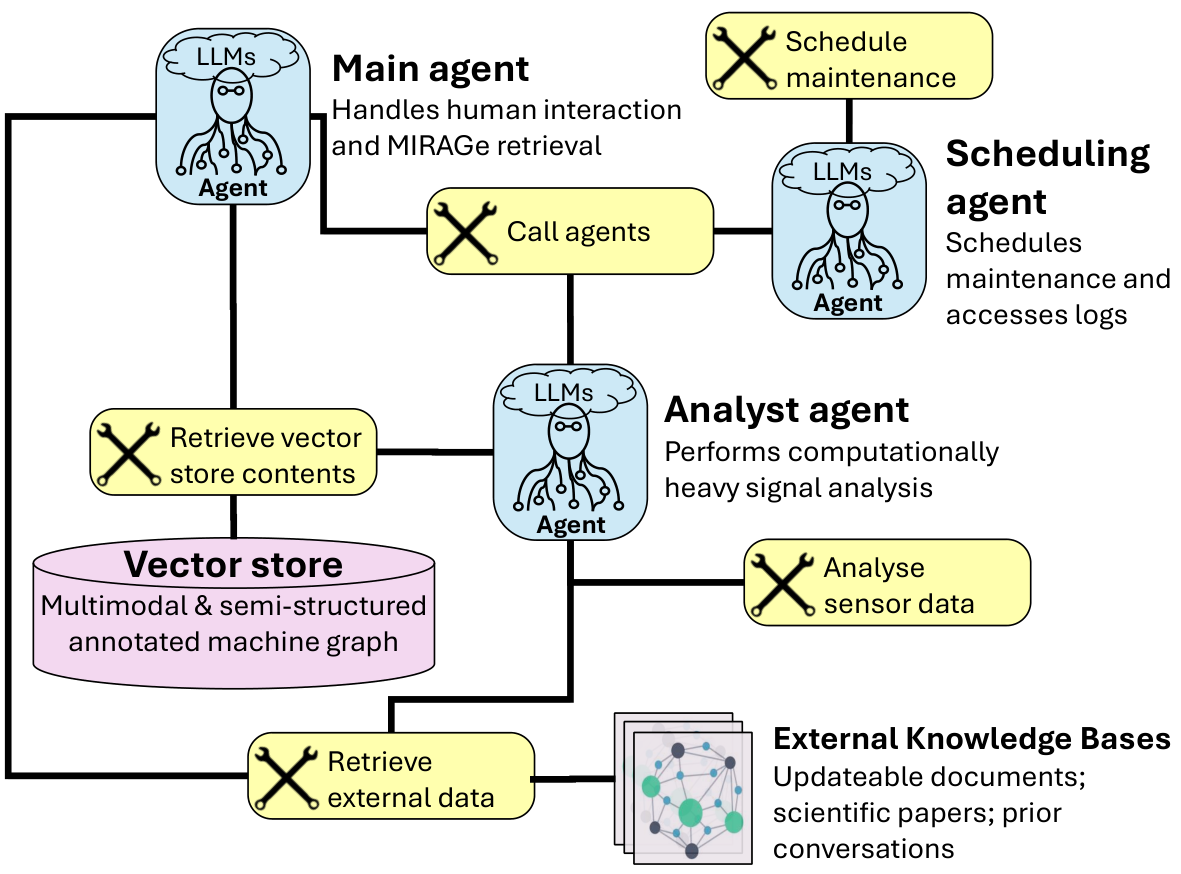
主思考智能体是入口,负责文档级检索、对话与调度,配有层级查询、知识库读写等工具;CM 分析师智能体承担信号检索与故障诊断,因为信号分析会产生大量中间数据,它的记忆会被定期重置,以免超出上下文窗口;维护调度智能体负责把诊断转成维护建议;评估智能体只在实验阶段使用,拿真实工单比对智能体输出,避免“自己判自己”。知识库分通用库与按资产编码的专库,用来沉淀老师傅的隐性知识,智能体可在对话中读写。
实测:71% 与 5%
在“排除目标资产自身记录”的预测任务上,智能体对 130 条记录给出判断:92 条正确(其中 20 条被评估智能体判为部分正确),38 条错误,按两种口径计算准确率为 71% 与 65%;其中 77 次(59%)为主动退出并给出报警,这部分准确率 75%。在 20 次以健康信号为主的测试中,只出现 1 次虚警和 1 次冗余报警,作者称 5% 的虚警率已优于现有系统。参与评估的分析师认为,带趋势说明的报警对现有系统是有价值的补充。
限制也很清楚:缺标签、标注样本少、大模型输出不确定,实验规模也有限。作者把路线分成四级,从“辅助检索”到“自动生成并核验报警”,再到“自动维护报告”,当前只走到前两级。
要点
MindRAG 的启示是,工业智能体的上限往往由数据组织方式决定,而不是由模型参数决定。把设备树、工单和信号对齐到同一个可过滤的检索空间,模型才有机会给出“有出处的判断”;反过来,只把 PDF 手册塞进向量库,得到的仍是漂亮但无用的回答。
资料来源:Agent-based Condition Monitoring Assistance with Multimodal Industrial Database Retrieval Augmented Generation — arXiv(2025-06-10)。本文为技术要点整理/编译,非原文全文。