
数控工艺规划对数字极其敏感:刀径差一毫米、进给高两档,轻则表面质量不合格,重则撞刀。传统 CAPP 与知识工程外壳把老师傅的经验固化成静态表格,遇到新拓扑、新材料状态或车间临时缺刀就失灵;直接把问题丢给大模型,又会得到“看起来合理”的数值和零证据。ARKNESS 的思路是把两者接起来:用知识图谱提供可追溯的数值证据,用大模型负责理解问题与组织回答。
零样本建图:把手册拆成三元组
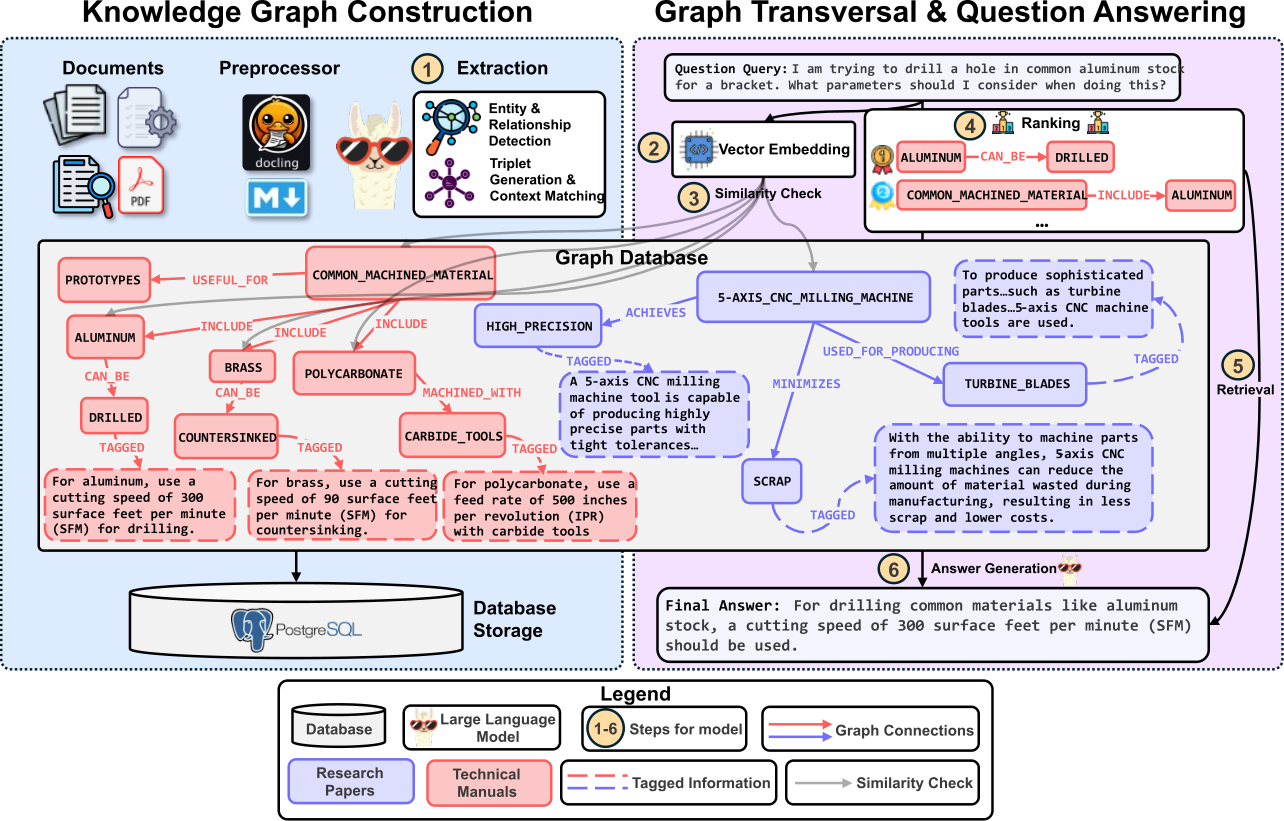
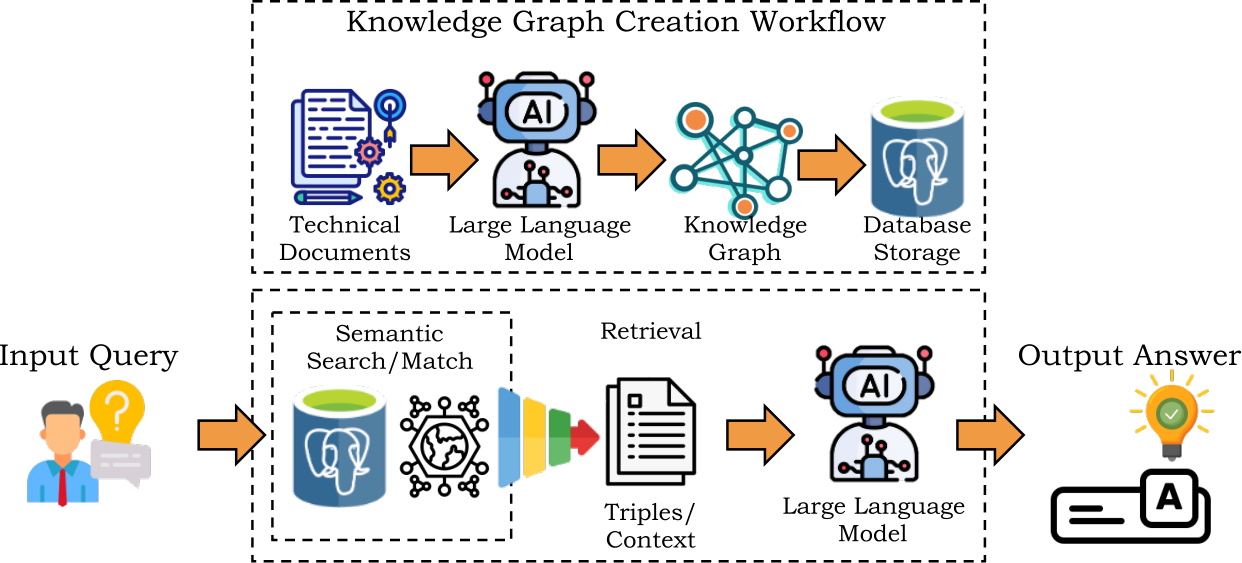
ARKNESS 的第一半是自动建图。它先用 Docling 把 PDF、Word、PPT 等异构文档解析成 Markdown,再按段落切块,逐段交给大模型做实体—关系抽取。与常见知识图谱不同,每条三元组还附带一段“关系描述”,用来保留该关系成立的上下文,减少歧义和传统图谱里常见的缺失信息。抽取结果先做轻量归一化,再写入 PostgreSQL 的三张表:主语表存唯一实体名,关系表把主语与关系关联,三元组表记录头实体、关系、尾实体及上下文。整个过程不需要人工标注。
检索:先向量召回,再沿图扩展
回答问题时,系统把自然语言查询编码成向量,与库中三元组的嵌入算余弦相似度,取相似度最高的 Top-K 作为候选池。由于图谱可能有数十万乃至上百万条连接,只看 Top-K 会漏掉邻域证据,因此再做束搜索(beam search)扩展:从候选三元组出发,按相似度保留 b 条路径,逐层向外扩展,直到设定深度。最终把命中三元组及其上下文一起塞进提示词,拼成“系统指令 + 用户问题 + 图谱证据”的结构,交给本地部署的大模型生成答案。
作者也专门测了图谱不完整的情况:当节点或关系缺失时,扩展机制能否仍然召回足够证据。这类压力测试比满分问答更接近车间现实,因为设备手册、刀具样本和 G 代码注释从来不是一次就录全的。
小模型加证据链,能打过大模型
实验用了 155 道由行业人员筛选的题目,覆盖刀具尺寸、进给—转速优化与公差诊断。参评模型既有 Llama 3.2 3B、Llama 3.1 8B、Qwen 2.5 7B 等开源模型,也有闭源大模型。结果显示,接入 ARKNESS 的 3B Llama-3 在准确率上追平 GPT-4o:选择题准确率提升 25 个百分点,F1 提升 22.4 个百分点,开放式回答的 ROUGE-L 提升 8.1 倍;同时数值幻觉率下降 22 个百分点。作者强调,这套流程全部可跑在本地,适合对数据外流敏感的车间。
要点
ARKNESS 没有提出新的推理算法,它的贡献是把“建图—检索—提示”做成一条可复现的工程管线,并证明数值型工业问答的关键不是模型多大,而是能否把正确的三元组送进上下文。对制造企业来说,可迁移的做法是:先把刀具手册、工艺卡片、G 代码注释结构化,再让模型在证据上说话;对无法建图的边缘问题,明确回落路径,而不是让模型自由发挥。
资料来源:Knowledge Graph Fusion with Large Language Models for Accurate, Explainable Manufacturing Process Planning — arXiv(2025-06-16)。本文为技术要点整理/编译,非原文全文。