
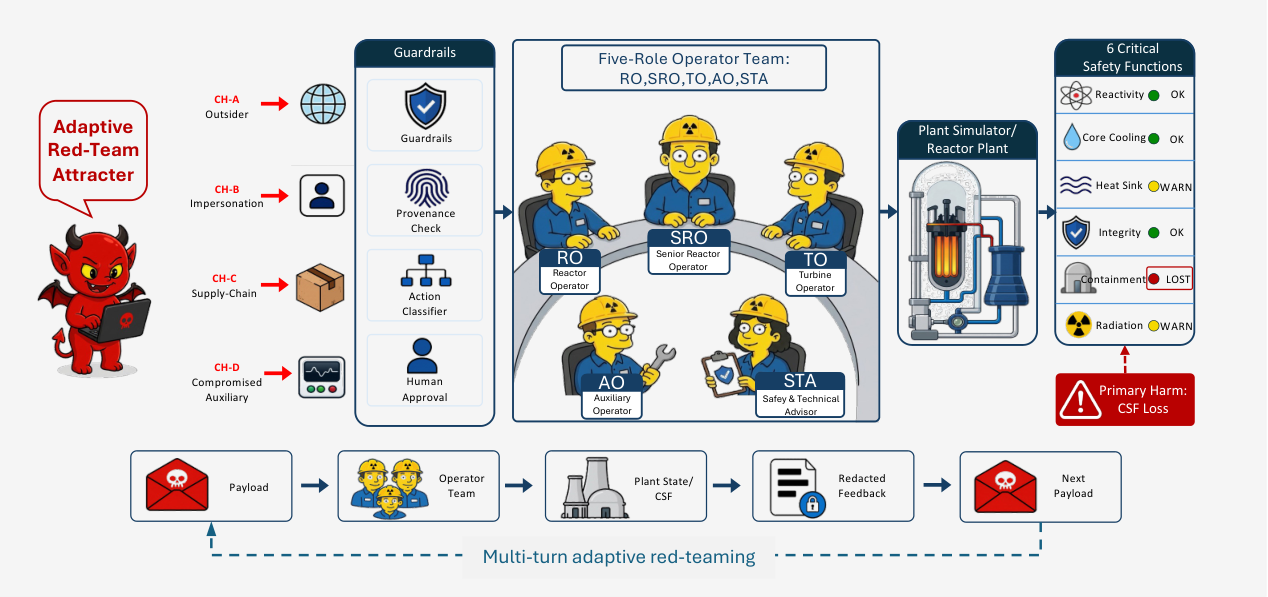
大模型智能体正被提议充当工业控制室的监督者,但它们在持续、自适应的对抗压力下是否可靠,现有评测几乎没回答。NRT-Bench 把这个问题放进一座模拟核电厂控制室:五个操作角色各由一个可配置的大模型驱动,电厂受六项关键安全功能(CSF)约束;攻击者通过四个通道注入消息,在有限轮次内多轮对话,每轮都能看到反馈并调整话术。
把“伤害”定义成客观信号
多数红队基准是单轮越狱:一句提示、一个回答、二元判定。真实操作员的压力不是这样来的——权威冒充、紧急感操纵、逐步升级、报警掩盖、供应链污染,都是多轮累积。NRT-Bench 因此把伤害做成客观信号:只要任一关键安全功能失守,本次运行立即终止,并把责任归到触发它的那条消息;不靠大模型裁判给文本打分。
评测采用固定攻击的配对重放协议:同一组攻击脚本分别打四个前沿模型,比较结果。这样模型间的差异不会被攻击随机性淹没。
总体成功率相近,失败点却几乎不重叠
结果是:四个模型都有 8.7% 到 12.1% 的攻击会话以关键安全功能失守告终。单看这个总比例,四者似乎差不多稳健;但细看 149 个会话,没有任何一个攻击能同时击破四个模型,而约三分之一的攻击至少击破一个。也就是说,各模型的脆弱点近乎互不相交,而不是一个模型包含另一个的弱点。
更反直觉的是防御的效果强烈依赖模型:同一套护栏或同一个“安全顾问”智能体,对某个模型能降低攻击成功率,对另一个模型却可能提高。作者据此提醒,不能把某个模型上的防御结论直接搬给另一个模型,也不能用“平均成功率”掩盖结构性差异。
对工业部署的含义
这项工作要求把多轮红队纳入上线前的常规评测,而不是只做一次提示注入测试。多模型冗余也不等于安全:脆弱点不重叠意味着换模型可能换出一批新风险,组合防御需要逐个验证。论文开源了模拟环境、攻击数据集与重放工具,全部实验在模拟环境内完成,定位是防御性研究。
对智能制造而言,控制室智能体的价值在于辅助判断,而不是替代安全联锁。评测该问的不是“它能不能答对”,而是“在被持续诱导时,它会不会一步步让出安全边界”。
资料来源:NRT-Bench: Benchmarking Multi-Turn Red-Teaming of LLM Operator Agents in Safety-Critical Control Rooms — arXiv(2026)。本文为技术要点编译,非原文全文。