
供应链是多级反馈系统:零售端一个小偏差,经过订货延迟和库存策略放大,到工厂端就成了剧烈震荡,这就是啤酒游戏(Beer Game)几十年来的经典教训。把这套游戏里的真人换成大模型智能体,会怎样?麻省理工团队用生成式智能体重跑啤酒游戏,并把结果与 12 批、共 100 多名佐治亚理工学生三年来的对局数据对比。
四个可调杠杆
论文把影响表现的因素归为四类:模型选择、策略与护栏、信息共享、提示词设计。模型能力是主导项:从 GPT-4o mini 换到 GPT-5 mini,总成本下降 70%;更轻的 Llama 4 Maverick 17B 反而比更大的 Llama 3.3 70B 低 82%,但结果并不稳定。作者的建议是优先看推理与指令遵循能力,其余手段只是性能优化。
护栏的价值不在让模型更聪明,而在阻止它在推理失灵时下大单。最简单的做法是给每个智能体一个固定预算,订货不能超过可用资金。这个硬约束像刹车:缺货时智能体想恐慌性补货,预算上限迫使它收敛,需求放大随之减弱。效果是总成本分别下降 25%(GPT-5 mini)、39%(GPT-4o mini)、41%(Llama 4 Maverick 17B);对稳定性较差的 Llama,跨运行波动从 46% 降到 37%。
信息不是越多越好
团队让一个“协调者”智能体掌握全局信息,只负责分发、不做决策。只给实时客户需求时,各模型成本下降约 18%(GPT-5 mini)、25%(Llama)、38%(GPT-4o mini)。再给五周需求历史和波动分析,结果分化:GPT-4o mini 成本大降 69%,但更强的模型反而变差,额外信息成了干扰。对人类有用的库存位置、在途库存,对智能体帮助有限,甚至加剧牛鞭效应。共享什么数据,得按模型实测,而不是照搬人的经验。
重复采样救不了“智能体牛鞭”
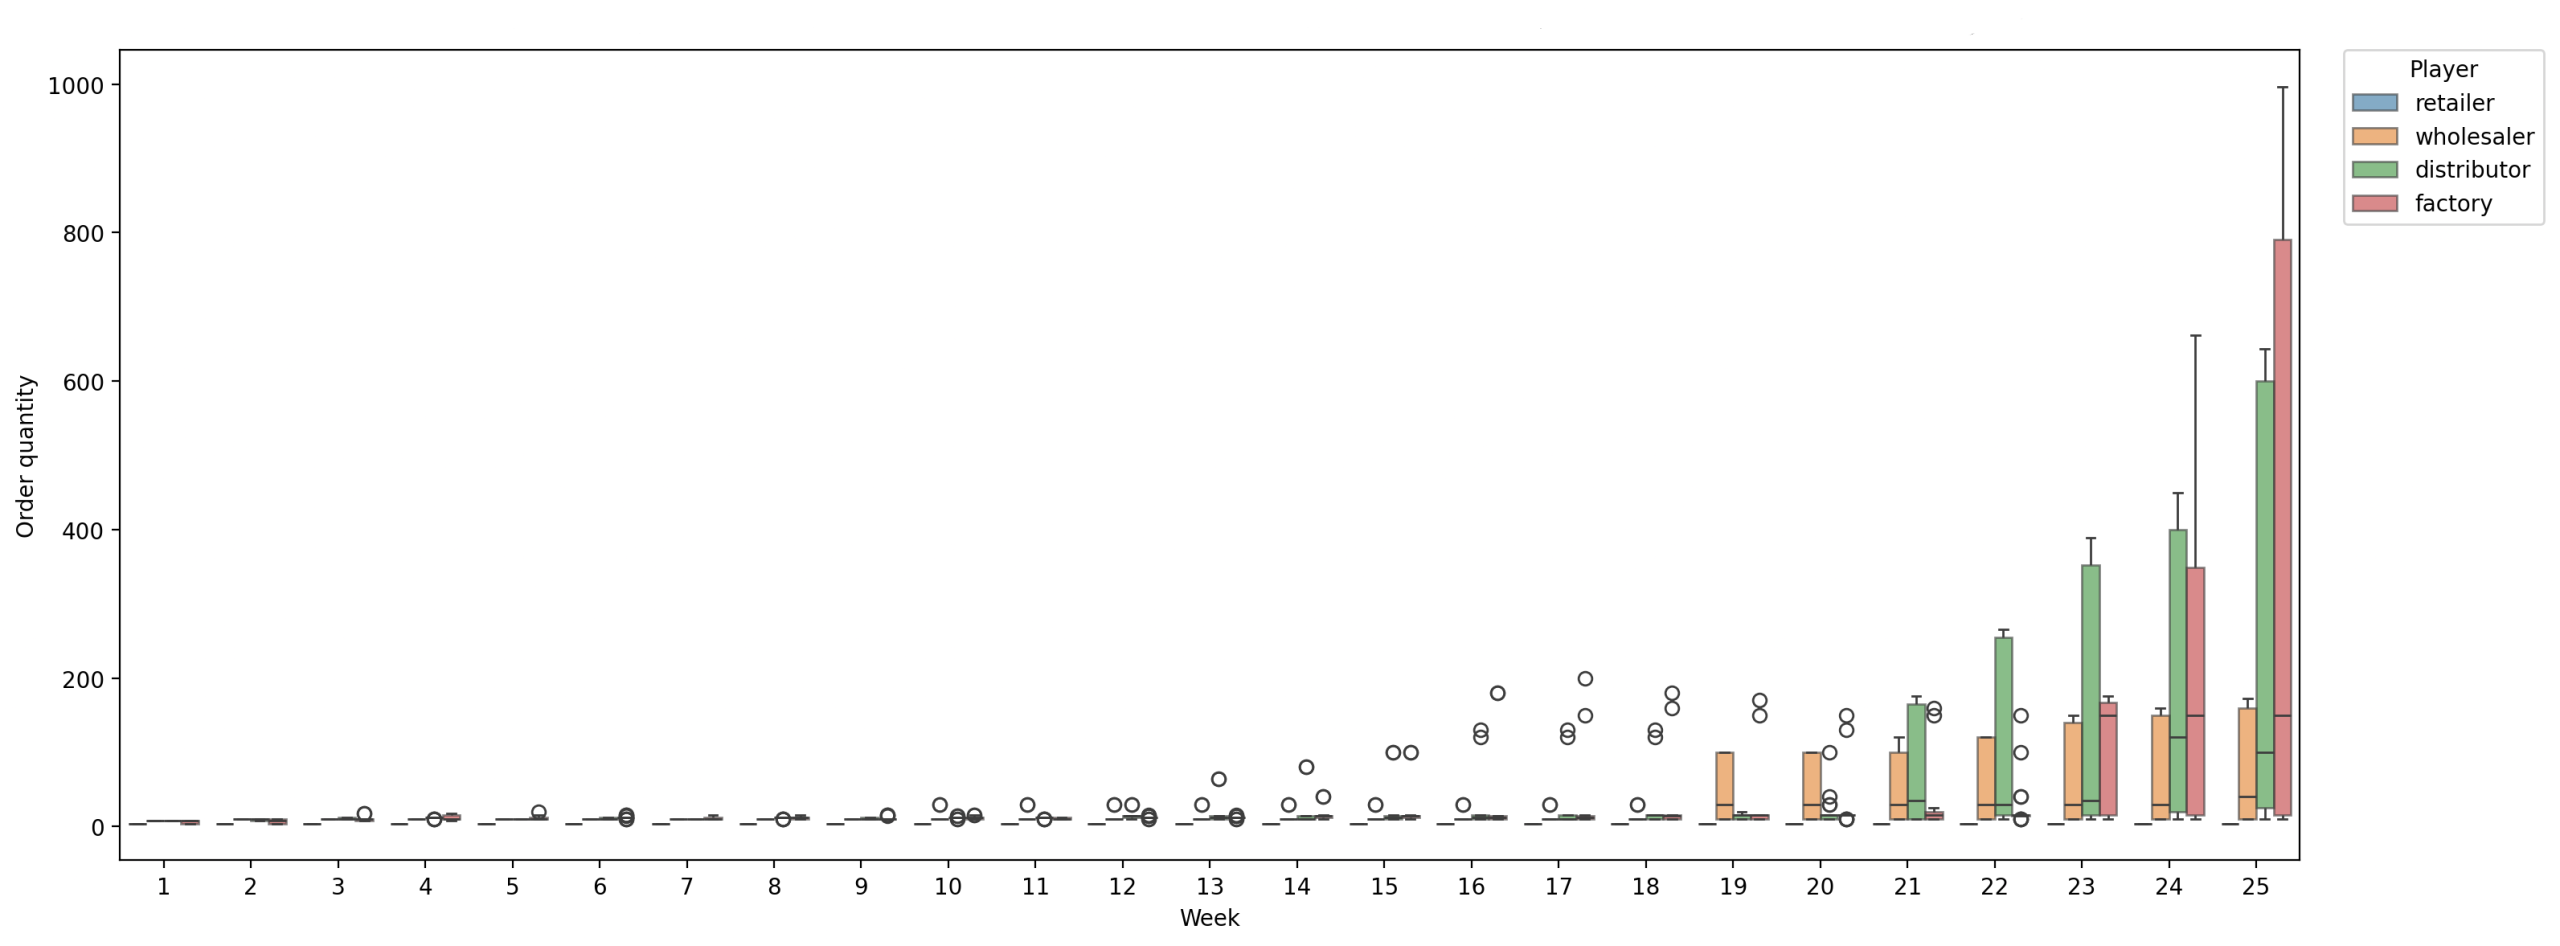
平均值好看,掩盖了可靠性问题。作者提出“智能体牛鞭效应”(agent bullwhip):在多级系统中,智能体决策的跨运行不稳定性会被放大。它有两个方向:同一时刻越往上游,订货离散度和尾部极端值越大;同一设施内,早期的订货差异会改变库存、欠交与在途管道,偏差随时间复利。把需求路径固定后仍然剩下的那部分,被称为“决策牛鞭”,它来自智能体自己的策略,而非外部需求。
直觉上的补救是重复采样取平均,但实验表明这几乎不能降低不稳定。要改的是决策策略本身。作者用 GRPO 做后训练:让一个共享基座模型在训练时接收系统级供应链奖励,学会协同补货;部署时各智能体仍只看到局部信息、独立决策。后训练显著压低了尾部事件和智能体牛鞭。最佳配置(Llama 4 Maverick 17B 加优化提示、数据共享规则与护栏)在 30 次重复中平均成本比学生团队低 67%。
启示
供应链智能体的验收标准不能只看平均成本,还要看跨运行的方差和尾部风险。护栏负责兜底,后训练负责改策略,二者都不能用“多跑几次取平均”替代。
资料来源:Reliability and Effectiveness of Autonomous AI Agents in Supply Chain Management — arXiv(2026)。本文为技术要点编译,非原文全文。