
工程智能体的演示很容易:给一句“帮我做个拓扑优化”,它调几个工具、画出一张结构图,看起来就成了。但端到端成功会掩盖断点——是模型不会选工具,是参数取错,是集群任务没跑完,还是训练代码写崩?EngiAI 把这些拆成四项能力,分别用执行轨迹和工程产物打分。
一个主管,七个专家
系统采用层级主管模式:中央主管识别用户意图,把任务路由给合适的专家;每个专家是一个 LangGraph 状态机,接收任务、调用领域工具、把结果交回主管。这样做的理由是工具越多,模型选工具的准确率越低,所以每个专家只暴露少量工具。主管可以顺序调用多个专家,比如先检索参数再转给工程专家;LangGraph 保存流程状态、支持人工中断并持久化检查点,反复重路由则终止。
七个专家覆盖设计到制造:核心设计专家通过 EngiBench/EngiOpt 做拓扑优化、仿真、机器学习反演和 STL 导出;RAG 专家与 ArXiv 专家共用 MMORE 多模态检索引擎,分别面向用户索引文档和 arXiv 论文;搜索专家接 Tavily;HPC 专家经 SSH 管理远程 SLURM 作业;CLI 专家执行本地命令,但只允许白名单内的图形应用,并在执行前要求人工确认;3D 打印专家通过 MCP 服务控制 Prusa 打印机。
四把尺子
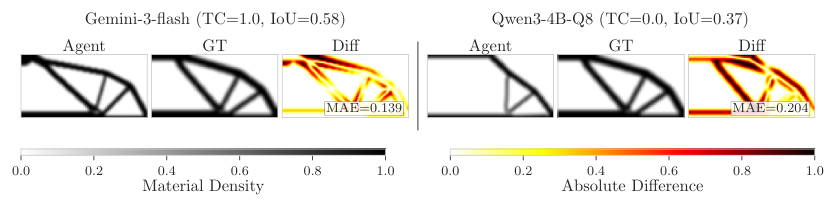
工作流执行用两个工程问题:Beams2D 是 50×100 的悬臂梁拓扑优化,在体积分数约束下最小化柔度,关键参数为 volfrac、forcedist 和 rmin;Photonics2D 是 120×120 的光子器件反演设计,用来检验能力能否跨物理域迁移。提示分七种风格:Full 给全部数值;Natural 只给定性描述,比如“轻量化”,要求智能体发现歧义并请求人工澄清;W-Rand 给随机导出参数;W-Derived 要求按规则推导参数;W-Distract 对同一参数给两个都能被工具接受的值;W-Cond 要求读取仿真输出的合规值再选分支;W-Multi 要求在两次导出中保持两套不同参数。评分权重为设计质量 65%、工具使用 20%、任务完成 15%。
检索选参设三种条件:RAG-on 有索引文档、RAG-off 完全去掉检索工具、Empty RAG 保留工具但索引为空。计分带门控,只有真的调用了检索工具才给参数分,防止模型凭记忆答对也拿分。HPC 编排要求生成 SLURM 脚本、提交、监控到结束并评估模型。训练代码编写分六档:T1 只改启动配置,T2 至 T5 逐步挖掉参考程序里的代码区,T6 只给命令行和评估接口,让智能体自选架构。
结果:条件分支和状态保持是主要断点
四个后端是 GPT-5-mini、Gemini-3-Flash,以及本地部署的 Qwen3-4B、Qwen3.5-4B;每格跑 15 次。Beams2D 上两个闭源模型任务完成率 96% 至 97%,两个开源 4B 模型为 55% 至 78%。到 Photonics2D,需要条件决策的 W-Cond 掉到 20% 至 53%,而 Beams2D 同风格最高还有 93%。在 29 个做了导出却失败的 Photonics2D 试验里,28 个把分支选反了:threshold 与 mirror_y 被互换,共享的 scale_xy、scale_z 倒是保留正确。参数记住了,条件判断错了,这是只看最终图纸发现不了的。
检索实验里,索引可用时得分最高,空索引明显下降——手里有检索工具但没有资料,系统不会自动变好。唯一例外是 P0:Gemini-3-Flash 在空索引下仍答出 0.35,因为这个值在拓扑优化里太常见,既是 Sigmund 99 行基准的取值,也是 EngiBench 的默认值。HPC 环节,Gemini-3-Flash 跑完了所有测试流水线,GPT-5-mini 有 50% 至 70% 走到最后的评估步。写训练代码时,小缺口补得可靠,开放区域越大越容易跑偏;在完全开放的 T6,两个闭源模型都选了条件变分自编码器而不是参考的 cGAN,Gemini-3-Flash 在 10 次 Beams2D 试验中有 7 次 MMD 低于参考。
一个局限:基于阈值的 STL 提取会产生非流形网格,所有模型水密性子分都低,这是流水线问题而非能力问题,设计质量应只在同一提示风格内比较。
这套评测把失败落到具体环节:语义接地、条件分支、长程完成、检查点兼容、采样与产物质量。工程智能体进设计院和工厂,验收表就该这样,而不是一张端到端截图。
资料来源:EngiAI: Capability-Based Evaluation of Tool-Connected LLM Agents for Engineering Design — arXiv(2026)。本文为技术要点整理/编译,非原文全文。