
工业机器人每秒产出上百个通道的关节角、力矩、速度、接触力和任务阶段信号。要回答“现在是什么状态”“动这个参数会怎样”“如果当时不撞会怎样”“该怎么修”,靠的不只是拟合曲线。FactoryBench 把这类“机器理解”拆成四级,用近七万道问答去考时间序列模型和大模型。
四级阶梯:状态、干预、反事实、决策
基准以 Pearl 因果阶梯为骨架,再补上一层决策。L1 状态要求识别运行模式、预测和辨认传感模式;L2 干预要求判断当前时刻控制动作或事件的即时影响,并在正常与异常片段里做实时故障诊断;L3 反事实要求模拟另一段历史,比如“若在 4329 毫秒出现 +0.5 公斤负载突变,500 毫秒后关节加速度会是多少”;L4 决策则要求依据记录片段和任务描述,给出排查步骤或优化建议,对应车间里“先诊断、再动作”的闭环。
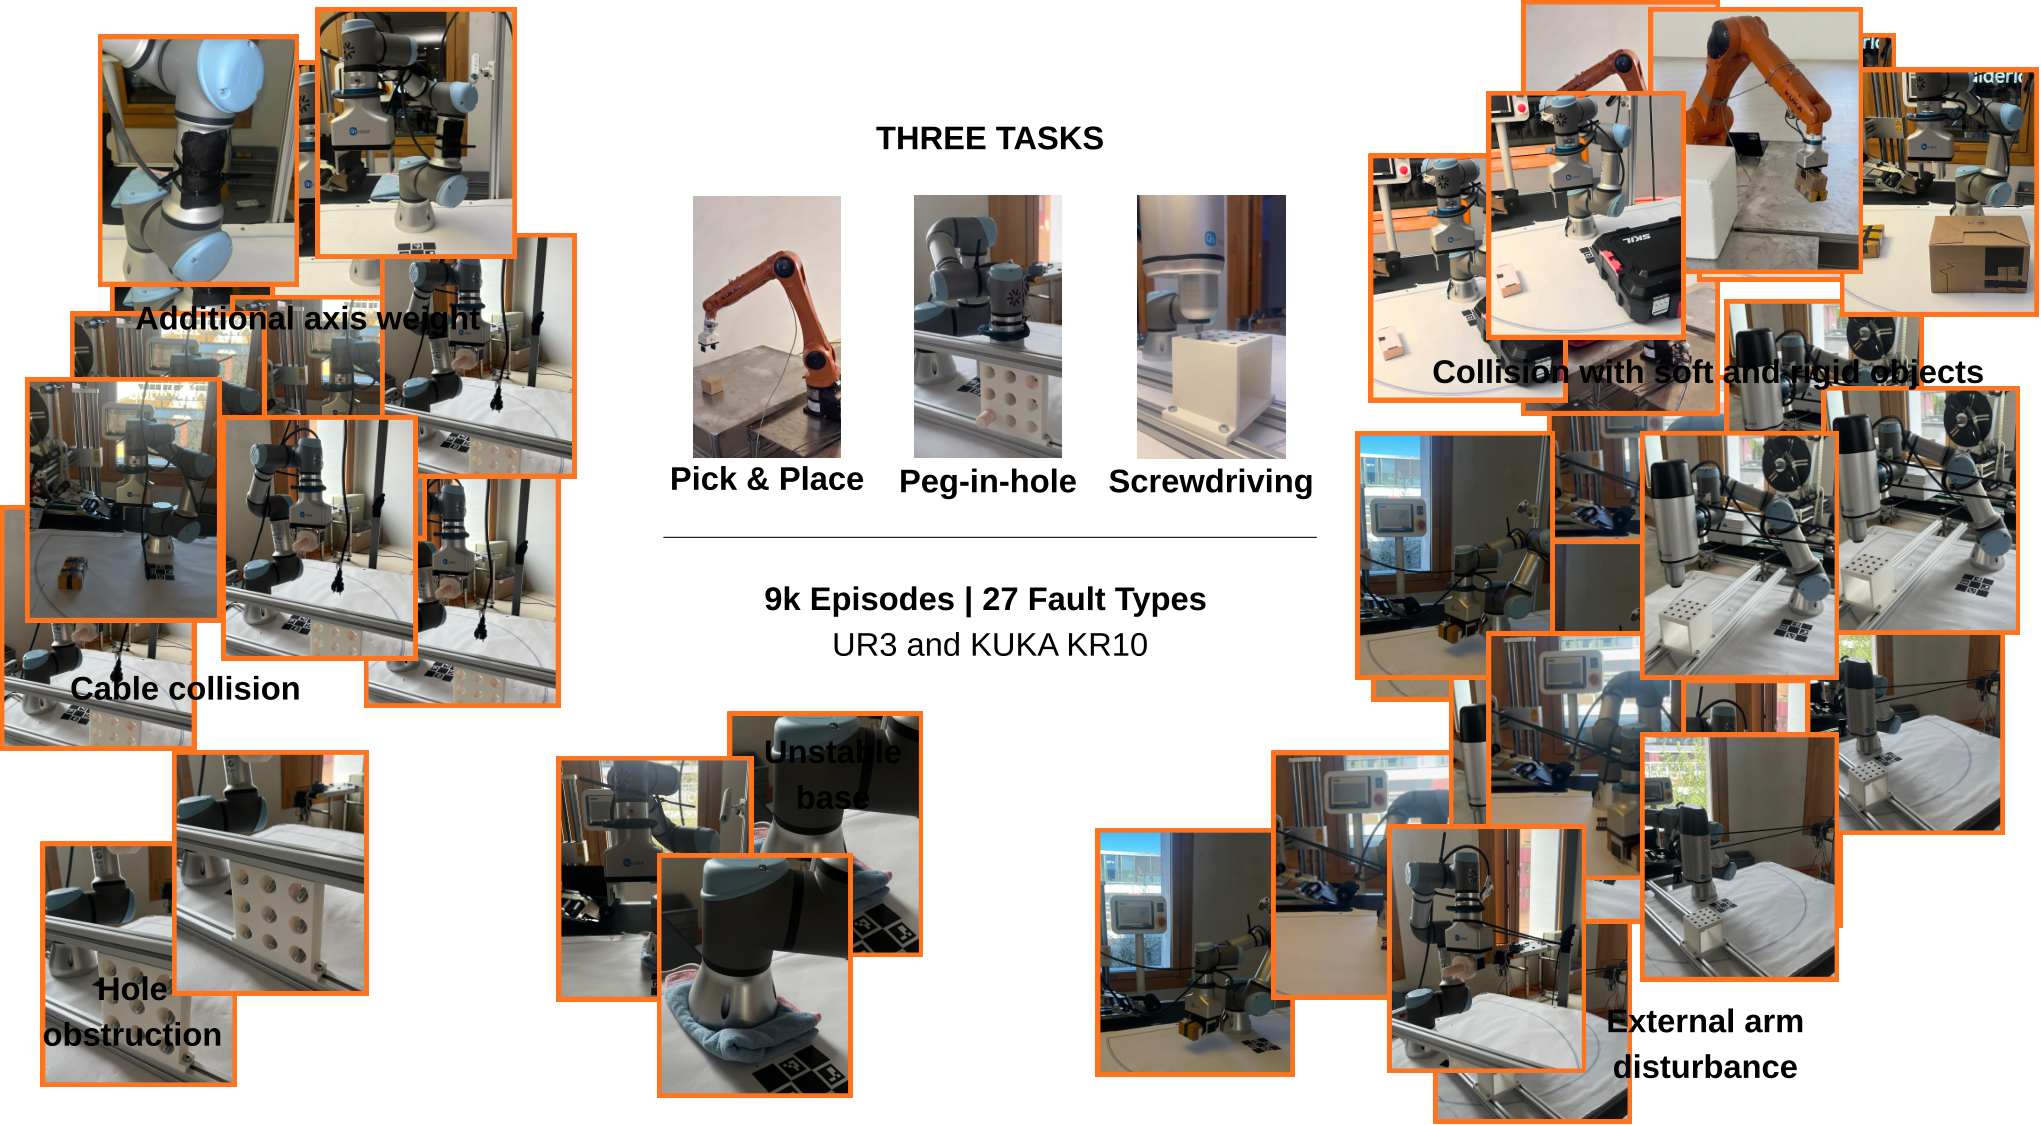
每道题有五种作答格式:单选、多选、排序、张量和自由文本。前四种按规则确定性判分,自由文本由多个大模型评委投票。全部语料 69,691 题,来自约 1.5 万段规范化轨迹:FactoryWave 在 UR3 协作臂(125 赫兹)和 KUKA KR10 工业臂(83 赫兹)上采集,覆盖 100 多个通道、8,983 段任务、27 类故障,任务包括抓放、拧螺钉和轴孔装配;另外接入 AURSAD 与 voraus-AD 两个公开数据集。21 个专家撰写的模板负责生成题目,另发布 3,000 题的 Lite 子集,按模板均衡抽样。
反事实真值不好造。团队在固定物体位姿、负载、控制器配置和脚本轨迹后,把同一任务重跑 3 至 5 次,在固定时刻注入故障,再选“注入前片段与基线 signature kernel MMD 最小”的那次作为近似真值。L4 还需要机器专属知识:把厂商运行错误文档解析成“错误码—名称—描述—恢复步骤”,再由机器人专家把 27 类异常映射到最可能触发的错误码;没有明确错误码的物理故障,由专家按同一结构补写处置流程,最后全部进知识图谱,生成题目时自动拼装协议上下文。
六个前沿模型:规模不等于理解
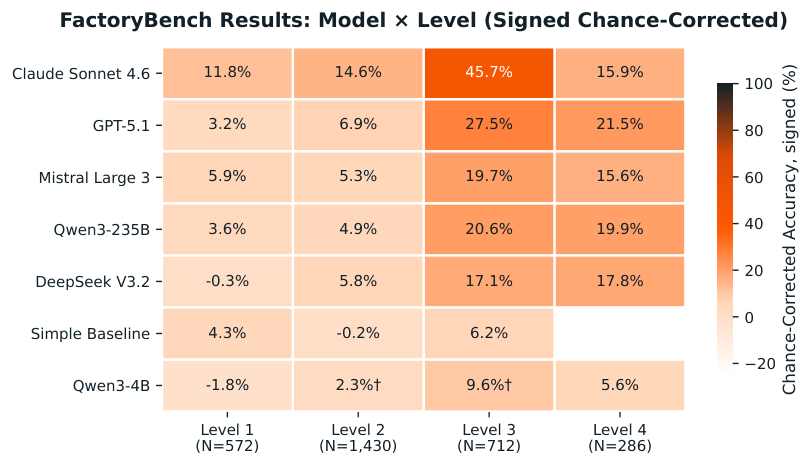
零样本测试了 Claude Sonnet 4.6、GPT-5.1、DeepSeek V3.2、Mistral Large 3、Qwen3-235B 和轻量的 Qwen3-4B。校正猜测后的 L1 上,非语言基线为 +4.3%,只有 Mistral Large 3(+5.9%)和 Claude(+11.8%)越过它;参数更大的 GPT-5.1(+3.2%)和 Qwen3-235B(+3.6%)反而低于基线,Qwen3-4B(-1.8%)和 DeepSeek(-0.3%)甚至低于随机。
L3 反事实拉开差距:Claude 达到 +45.7%,GPT-5.1 为 +27.5%,其余更低。更关键的对照是专家:一位机器人专家在 60 题样本上拿到 L1 0.962、L2 0.980,而最好的模型只有 0.712 和 0.662。信息确实在发布的信号里,读不出来的是模型。
L4 自由文本采用不校正的 0/0.5/1 评分,量级与前三层不可直接比较,但排名变化值得注意:GPT-5.1 以 21.5% 领先,Qwen3-235B 19.9%、DeepSeek 17.8%,而 L1 至 L3 一直领先的 Claude 掉到第四(15.9%)。同一批模型,信号理解强不等于处置流程强。GPT-5.1 的 L4 分数呈明显双峰:76.2% 得零分、14.0% 满分、9.8% 部分分;它在轴孔对位偏差、刚性物体碰撞等“有力矩或速度突变”的故障上得分较高,却在缺螺钉、多装零件、松动、平台不稳、运动中夹爪松开等“改变装配状态但没有机械瞬变”的故障上全为零。正常片段也只有 14% 被正确判为“无异常”。
缺的是表示,还是读出
作者用线性探针做了进一步检查:在冻结的模型激活上,判断“有没有故障”能到 0.83,明显高于随机,尽管该模型自己的答案低于随机;但判断“是哪类故障”几乎不可解码,和未训练网络差不多。这说明一部分失败是读出没校准,另一部分是模型内部就没有形成可分的故障表示。基准同时发布了 102 题专家解答集,覆盖四层(25/42/23/12),每题附推导和可运行代码,便于复核真值。
对工业智能体的启示是:别用一个端到端演示判断能力。读状态、取流程、做决策是三种可分离的能力,采购和验收时应分别设题;尤其要测“状态改变但无机械瞬变”的故障,这类题最容易把模型打回原形。
资料来源:FactoryBench: Evaluating Industrial Machine Understanding — arXiv(2026-10)。本文为技术要点整理/编译,非原文全文。