

智能制造的质量检测长期以视觉为主:在光照可控、训练数据充足的条件下,现代机器视觉和深度模型在工业基准上表现很强。但视觉只提供几何和光度信息,硬度、粗糙度、材料成分这些直接影响装配、密封、耐磨和涂层附着力的属性,并不能从外观直接读出。遮挡、反光、光照不均,以及金属和光泽表面的镜面反射,还会进一步削弱外观线索。要判断“这是什么材质、表面什么状态”,需要一种能直接接触表面的感知方式。
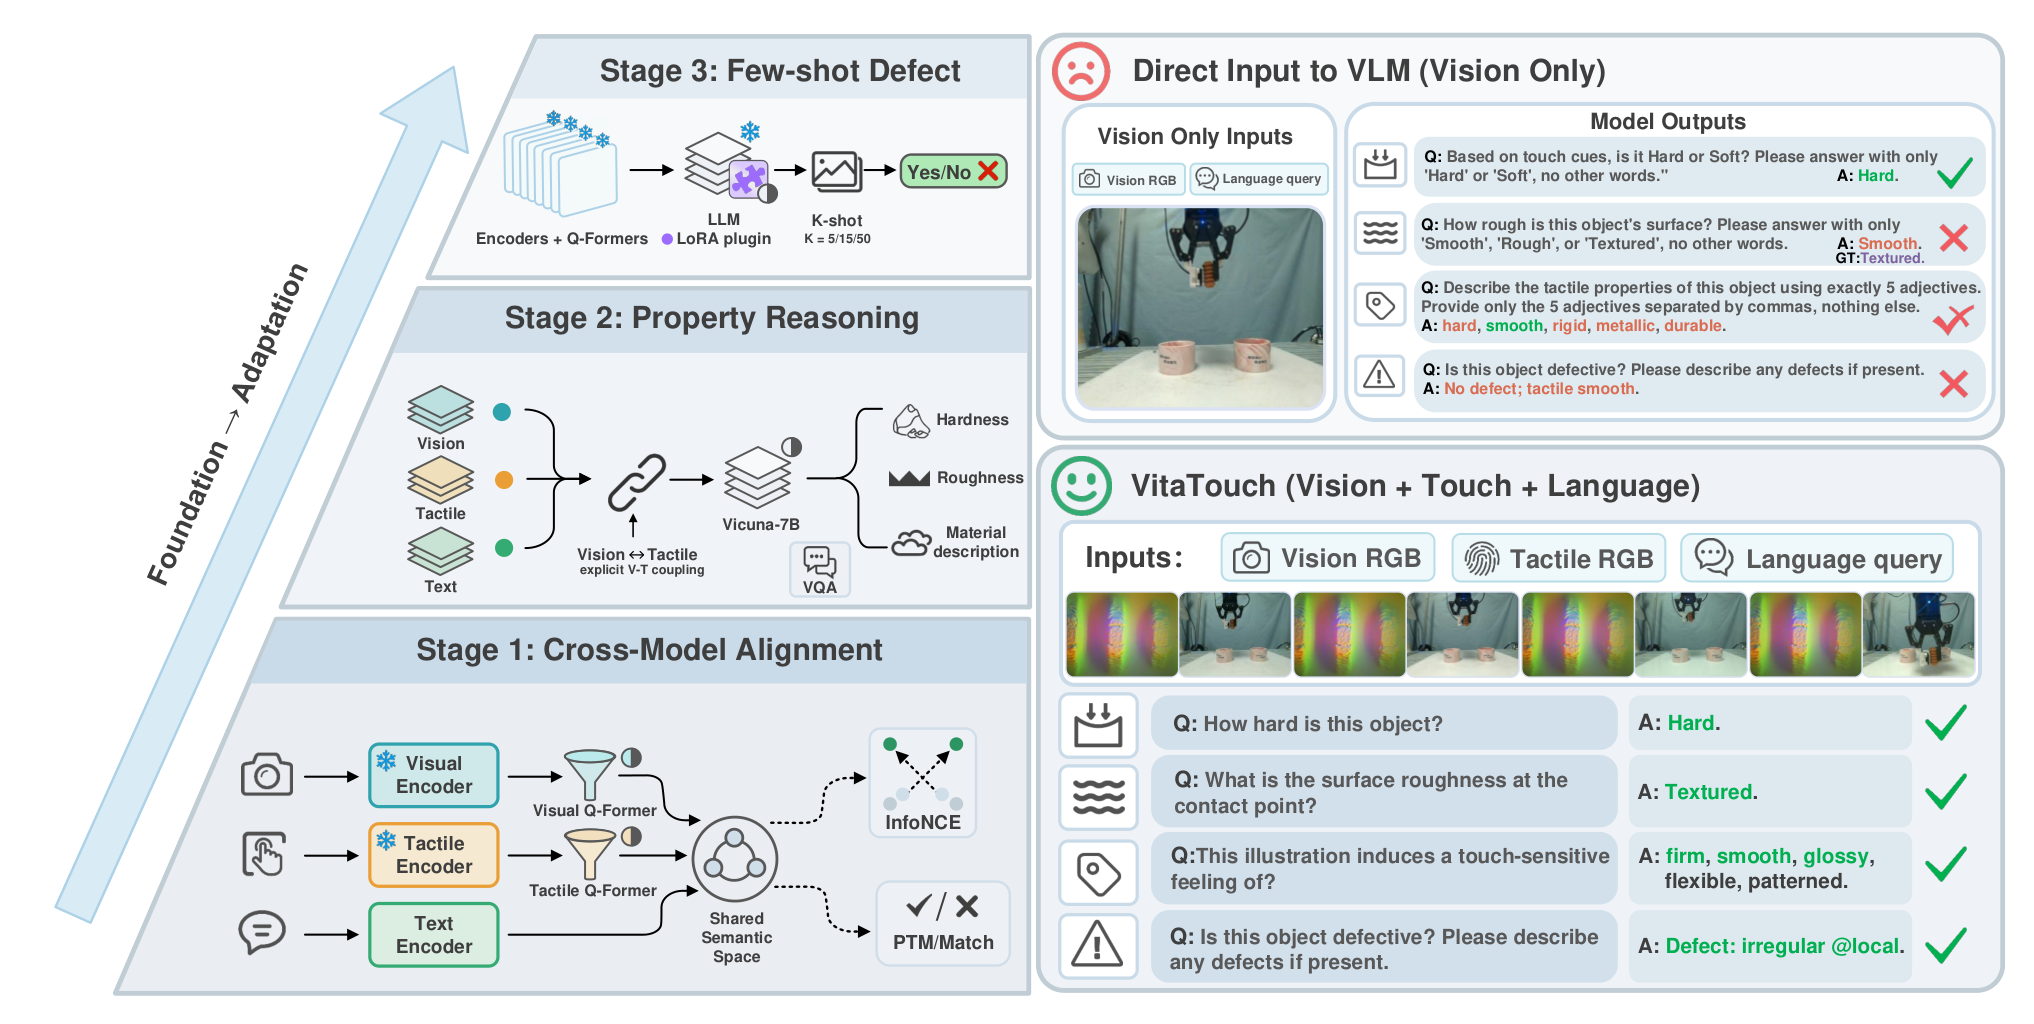
把视觉、触觉和语言放进同一个空间
VitaTouch是一套面向制造质量检测的视触觉语言模型(Vision–Tactile–Language,VTL)。它用模态专属编码器分别处理RGB图像和视触觉传感器图像,再用双Q-Former提取与语言相关的视觉与触觉特征,压缩成前缀token(prefix tokens)送入大语言模型。训练时,每种模态都与文本对齐,同时通过对比学习显式耦合视觉与触觉,让模型学会把“看到的表面”和“摸到的感受”对应到同一套语言描述上。
这套设计针对的是一个具体缺口:通用视觉语言模型偏重物体语义,对“正常/异常”的区分并不敏感;已有的触觉语言工作又多面向日常物体和通用机器人感知,缺少面向工业缺陷分类、工艺波动和部署约束的可复用基础。VitaTouch把缺陷识别当作“物理属性理解”的下游任务:先建立可迁移的材质与表面属性表征,再用少量样本适配具体产品的缺陷类别。
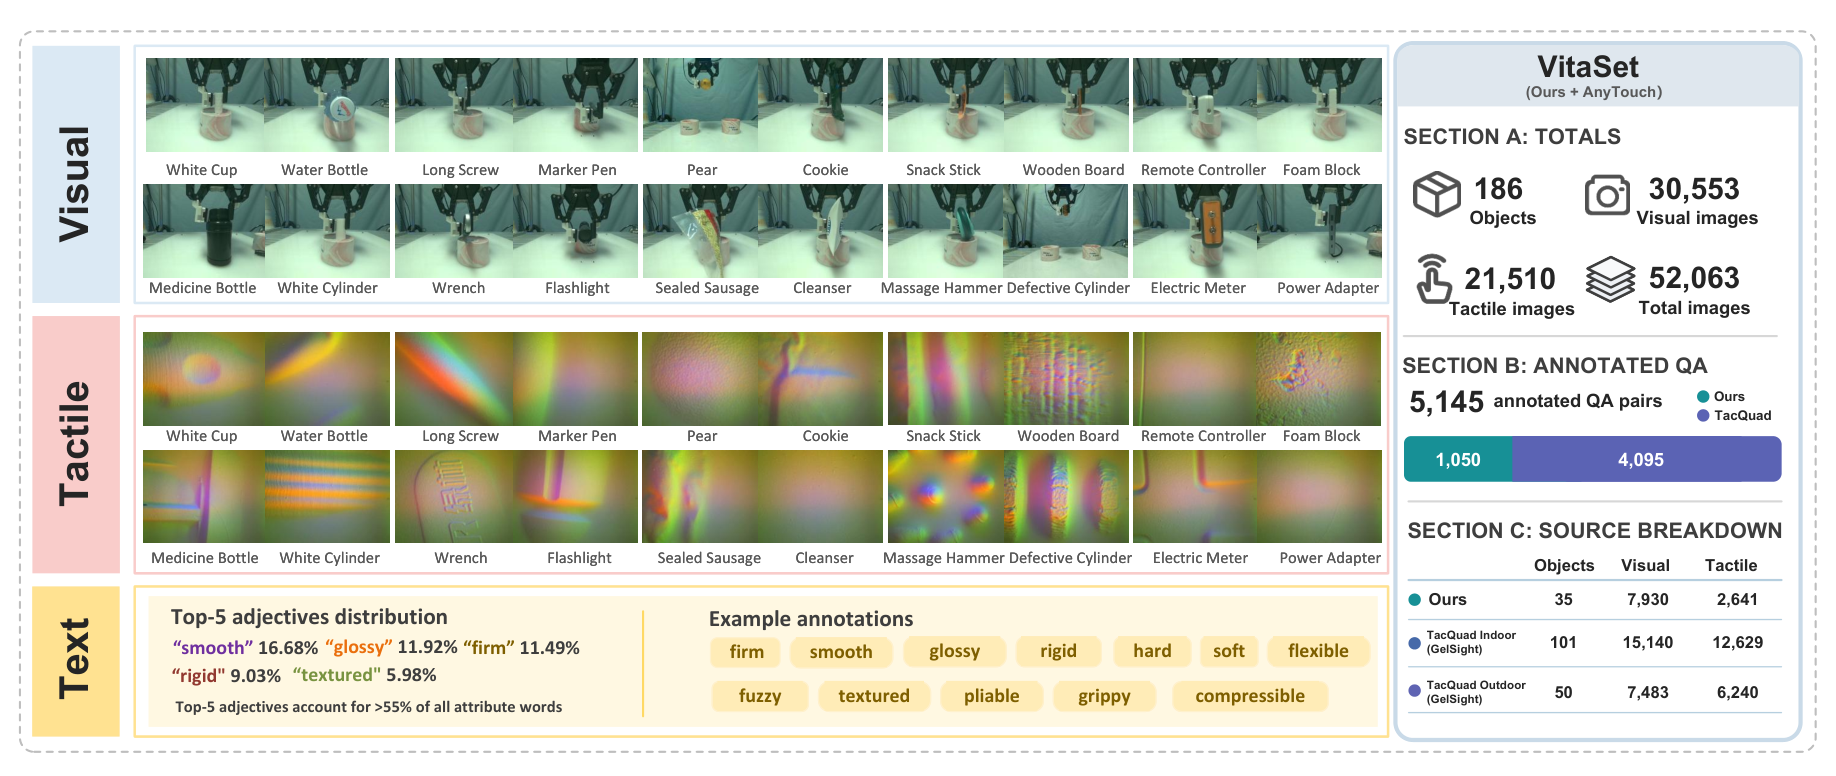
VitaSet:186个物体、5.2万张图、5.1k条指令
团队构建并公开了VitaSet数据集,把自建的工业机器人操作子集与AnyTouch的GelSight子集放在统一标注规范下,形成对齐的视觉、触觉、语言三元组:186个物体、5.2万张图像、5.1千条经人工核验的指令—答案对。属性选了三类与不合格品关系最紧密、又适合多模态感知的目标:硬度,反映材料抵抗压痕和变形的能力,偏差可能意味着材料错配或工艺漂移;粗糙度,描述表面微观几何,影响摩擦、耐磨、密封和涂层附着;材料与表面特性,则以自然语言描述任务的形式呈现,要求模型从多模态观察中说出材质与表面状态。
数据采集用RGB相机加GelSight视触觉传感器,在反复抓取—接触的交互中模拟检测动作。视触觉传感器通过接触形变输出类似图像的读数,编码局部表面与材质信息,且比普通视觉更不容易受光照伪影影响。
少样本、低算力下的缺陷识别
工业部署有三个现实约束:缺陷样本稀缺,失败模式长尾且标注需要领域专家;产品变体和工艺漂移频繁,要求快速适配而不能全量重训;工业PC和边缘设备显存、算力、延迟都有限。对此,VitaTouch采用参数高效适配:冻结主干,只用LoRA等低秩更新做少样本微调,既保留预训练得到的属性理解,又能以很低成本转向新缺陷类别。
在VitaSet上,模型硬度判断准确率88.89%,粗糙度75.13%,属性描述召回率54.81%,材料描述任务的语义相似度峰值达到0.9009。经LoRA微调后,2类、3类、5类缺陷识别准确率分别为100.0%、96.0%和92.0%;在100次实验室机器人试验中,闭环识别准确率94.0%,端到端分拣成功率94.0%。在HCT和整体TVL基准上取得最佳表现,在SSVTP上保持竞争力。
这项工作的意义在于换了一个提问方式:质检不只是问“这张图像不像缺陷”,还要问“这个表面的物理属性是什么”。后者能覆盖那些外观正常、但材质或表面状态已经偏离的样本,也更容易用自然语言向操作员解释。它的边界同样清楚——验证主要在实验室机器人和公开基准上完成,离产线级节拍、长期漂移和多种传感器互换还有距离;论文也把跨传感器、跨工艺的泛化列为后续问题。
资料来源:VitaTouch: Property-Aware Vision–Tactile–Language Model for Robotic Quality Inspection in Manufacturing — arXiv(2026-04)。本文为技术要点编译,非原文全文。