

边缘AI的第一阶段是单模型部署:一台相机跑视觉模型,一条PLC数据流跑预测分析,一组振动数据跑异常检测。每个部署自成一体,输入输出之后就交给下游系统或人。这些孤岛之间没有共享状态,也没有跨域推理:视觉模型发现缺陷时,不知道上游振动传感器三小时前已提示轴承磨损;趋势模型算出异常,却无法触发动作。
真正的瓶颈不是模型不够聪明,而是模型外面的编排层:记忆、目标跟踪、工具访问,以及每个业务域各自的行动权限。一个统一推理管线,很难同时维护视觉流、振动时序、ERP审计与安全决策这四种节奏、延迟和权限完全不同的上下文。
模型部署不等于智能体
模型部署是一个有边界的推理端点:接收输入、前向计算、返回结果,没有持久记忆,没有目标,也接不了工具。智能体则是围绕模型搭起来的系统:一个或多个推理模型,加上持久记忆、明确的工具集、规划层,以及持续运行的控制回路。智能体有目标、能跨交互跟踪状态、能从结果里学习,还能向其他智能体发布事件或订阅事件。多个智能体可共享同一个基础模型,但各自保留上下文、记忆、工具和权限。
按业务域拆,而不是按数据流拆
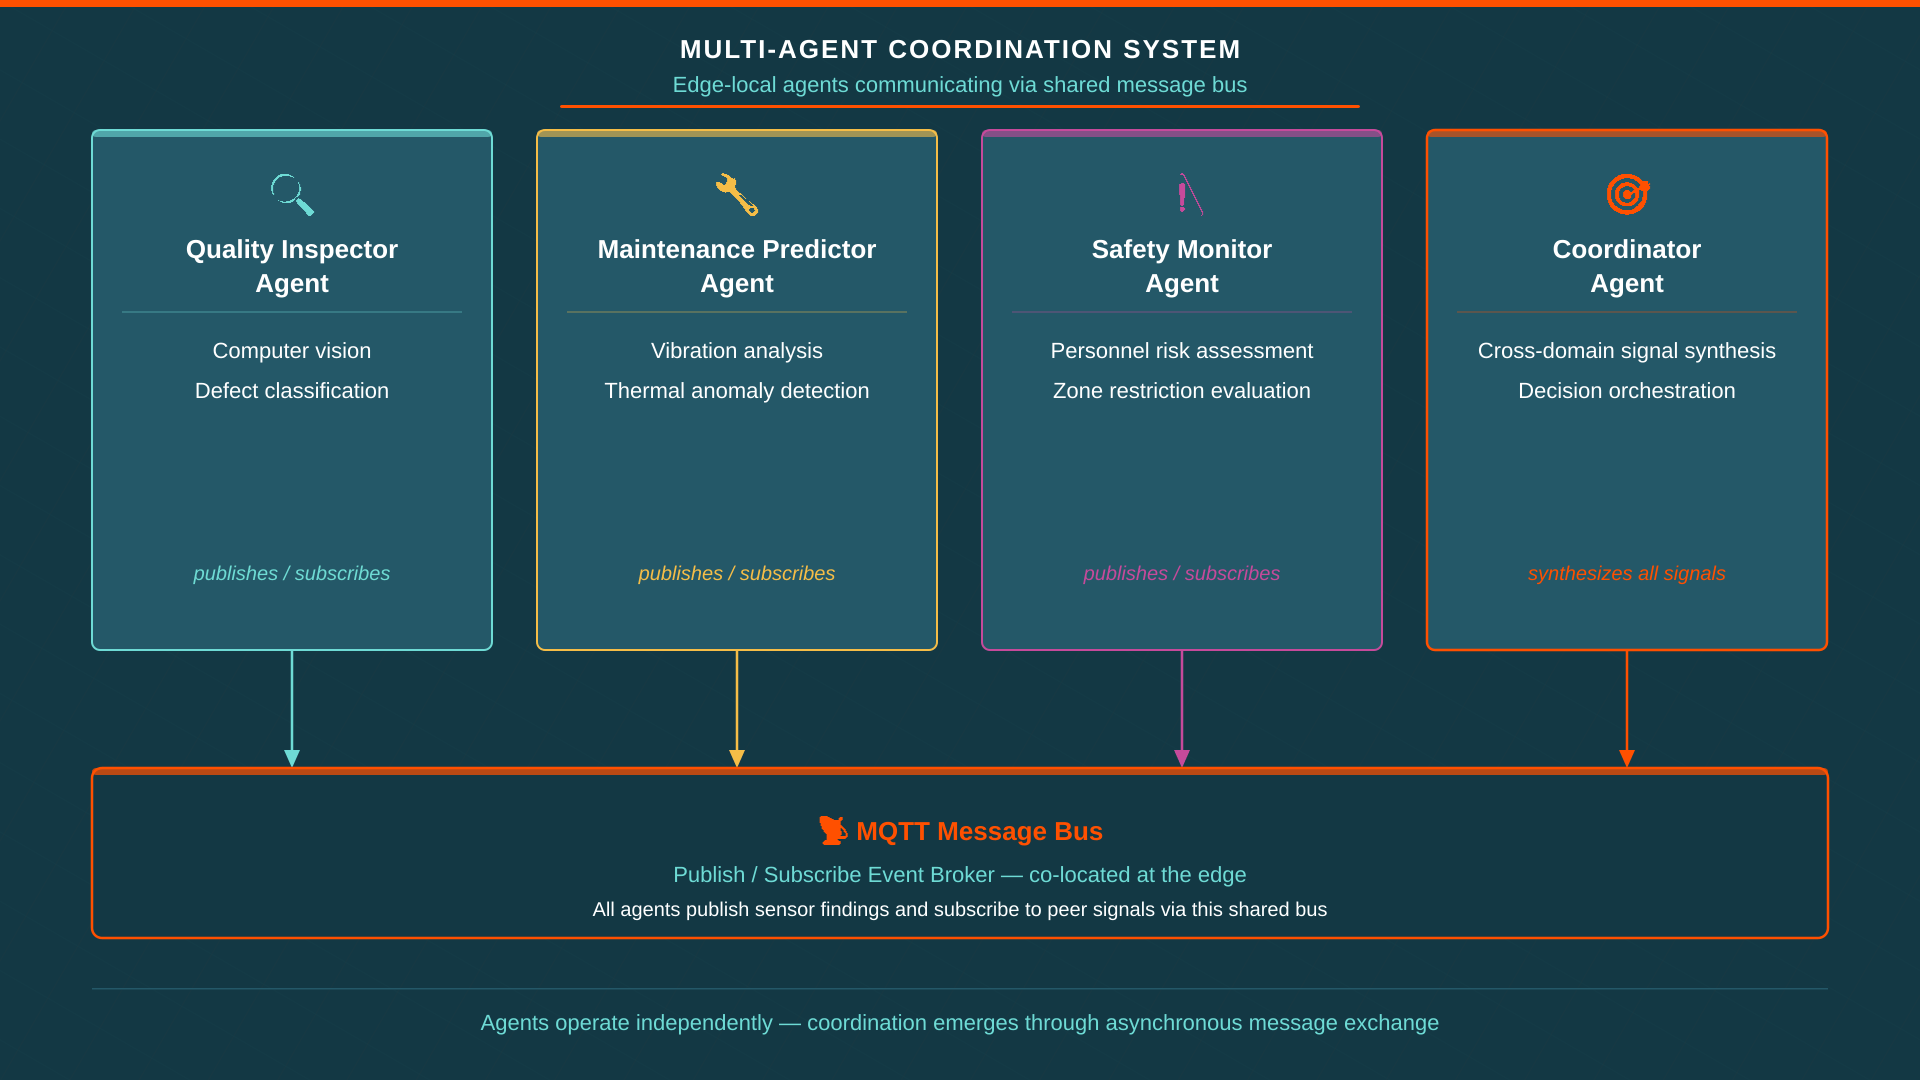
一条装配线良率突然上升,要同时回答几个问题:质检智能体用视觉检测和分类缺陷;维护预测智能体判断上游设备是否出现异常振动或热像;安全智能体评估异常是否带来人员风险、要不要限制区域;库存智能体测算停线对上下游物料的影响;协调智能体综合这些信号,决定减速、暂停、升级还是继续。
每个智能体只精一段,这不是缺陷而是优势。工程上这也是微服务思路:安全智能体出问题,不必重新部署质检智能体;自治边界清晰、可审计、可独立治理。
消息总线、共享记忆与统一动作出口
典型的工厂多智能体部署是一张协作网:每个智能体在共享MQTT总线上发布和订阅事件;协调智能体不复制专家能力,只负责跨域综合;Action Dispatcher是唯一被授权与ERP、产线控制器、告警平台等外部系统交互的组件,形成单一、可审计的动作边界。新增智能体只需订阅主题,不必改动已有代码。
第二层是共享记忆。没有它,每个智能体都像第一次遇到事件,无法积累机构知识。系统按时间尺度维护多层记忆;质检智能体存入一次缺陷事件后,维护智能体可查询同一记录并与之前的设备异常关联。
通信方式同样重要。同一边缘集群内用MQTT直连,避免云端往返延迟;跨团队、跨框架的任务交接则可用A2A协议(2025年由Google提出),通过Agent Card声明能力、协商任务并交换结果。成熟部署往往两种都用:MQTT承载高频运行事件,A2A约束明确的任务合同。数据同步遵循“在源头计算、按异常上云”,常规事件本地处理,聚合指标和严重事件才上云。
自治要分级,护栏要先建
多智能体系统不是固定自治级别。L0是规则阈值告警,L1能根据反馈调整参数,L2能提前数小时预测故障,L3由多个智能体跨域诊断并提出响应,L4才能在明确运行包络内独立执行高后果决策。今天多数生产部署处在L1到L3之间;L4只适合决策边界清楚、失败模式明确、错误可恢复的域。系统应从设计之初就按这条光谱演进,让护栏可以随运行信心逐步放宽。
有些决策无论置信度多高都不该自动执行。设计良好的系统会设置升级门:流程走到某一点暂停,把分析和建议交给操作员,等待明确批准。这保留了人对高后果决策的权威,也留下审计轨迹。护栏则同时在动作级(执行前按规则校验)、置信度级(低于阈值自动转人工)、速率级(冷却期防反馈失控)、审计级(允许、拦截、升级都写入不可篡改日志)运行。
联邦学习让整队共享经验而不泄露原始数据:各站点本地训练,只上传权重更新,云端用FedAvg加权聚合后广播全局模型。某个缺陷在单站也许只出现12次,在全队可能出现200次,聚合模型能更稳识别,而站点不必交出原始读数。
一条车身漆面缺陷的响应链
车身喷漆出现缺陷时,质检智能体先定位分类,维护预测智能体核对喷房设备,安全智能体评估人员风险,协调智能体给出减速、隔离或放行方案,动作经护栏校验后由Action Dispatcher执行或转人工。整段AI处理在400毫秒内完成;审批请求到达时,根因、历史先例和处置方案已备好,人只需授权一个有证据的方案。
作者给出五条建议:按业务域而非数据流拆分;用消息总线而非点对点API做集成;把共享记忆当基础设施;先建护栏再放权;从第一天做结构化遥测。所谓“AI工厂”不是一颗看住一切的超级模型,而是一支各司其职、共享规则的团队。
资料来源:Multi-Agent AI Architecture for Industrial Edge: How Specialized Agents Replace Single-Model Deployments — ZEDEDA(2026-07)。本文为技术要点编译,非原文全文。