

旋转与往复设备的预测性维护通常包含三件事:故障检测、故障诊断、剩余寿命(RUL)预测。深度模型在单一数据集上动辄超过99%,但换一台机器、换一套传感器或换一个工况就会明显退化。域适应要求训练时能拿到目标域数据,而新设备往往还没装传感器;自监督预训练加轻量微调提供了另一条路,可现有的时间序列基础模型大多只在10–50 kHz的轴承数据上预训练,绕开了一个根本矛盾:工业信号的采样率横跨五个数量级。
LayerNorm 的盲点
涡扇发动机的循环级数据是1 Hz,高频轴承振动约100 kHz。Transformer 里的 LayerNorm 对所有输入做同样的激活归一化,隐含假设“一个时间步”在不同物理采样率下含义相同。频率差五个数量级时,这个假设不再成立,同一套骨干很难同时吸收循环级退化轨迹和高频故障波形。作者因此提出 FreqCondNorm:用一个小型 MLP 以 log10(fs) 为条件,生成 FiLM 风格的缩放与平移参数,替换编码器里的每一个 LayerNorm。
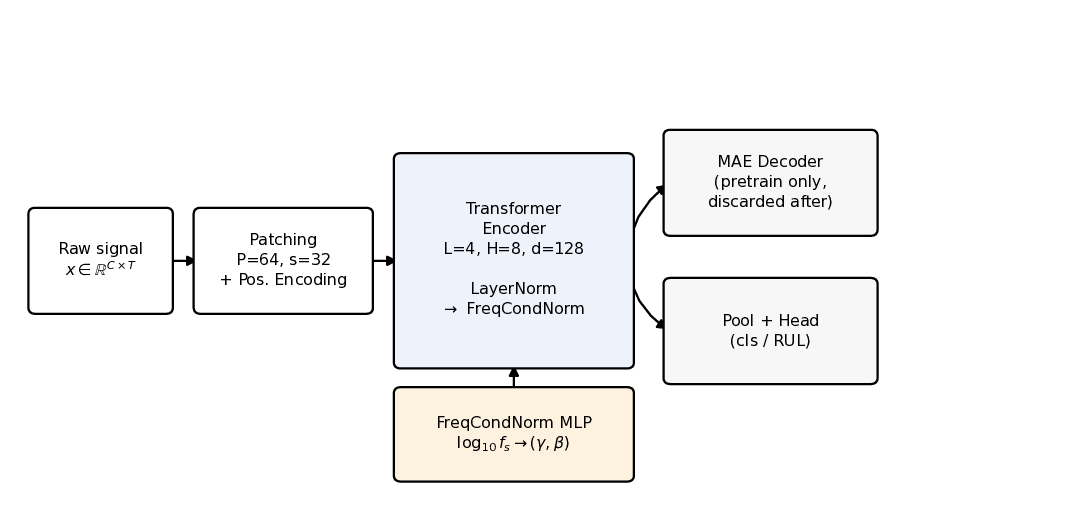
这个 MLP 的结构是 1→32→2d_model,输出层初始化到 γ≈1、β≈0,训练从标准 LayerNorm 起步,再逐步学出各频率段的修正;因此它也能作为软消融——当频率信息无用时就退化为普通归一化。
五数据集预训练与三段微调
骨干是通道独立的 PatchTST:patch 长度64、步长32,d_model=128,4层、8头、前馈256、dropout 0.1。预训练语料为 CWRU、MFPT、UOC18、PRONOSTIA、CMAPSS 五个公开数据集,除循环级的 CMAPSS 外统一重采样到25.6 kHz;用均衡域采样避免大数据集主导梯度。目标函数是掩码自编码(掩码率0.4,轻量解码器)加时序 InfoNCE(λ=0.1),AdamW 训练200轮。下游分类采用三段渐进微调:先冻结骨干只训任务头15轮,再解冻最后两层20轮,最后端到端30轮,以避免灾难性遗忘。
99.2% 与 82.1%,以及一个诚实的负结果
在按运行ID划分、避免数据泄漏的70/15/15 切分下,CWRU 全量分类达到99.2%,比强 CNN 基线高6.4个百分点;在预训练从未见过的 MFPT 上零样本诊断准确率82.1%。预训练本身也收敛得动:训练 MAE 损失从28.5降到9.1(−68%),验证损失从63.4降到15.8(−75%)。
但 RUL 回归没有变好——与不做预训练的基线相比没有提升。作者没有掩饰这一点,而是把原因指向预训练任务与 RUL 目标的错配:掩码重建学到的是局部波形结构,未必能刻画长时程退化趋势;RUL 微调也因此跳过第一阶段,直接端到端训练。另一个边界是语料规模:五个数据集远达不到通用基础模型的量级,所以作者只称其为“基础模型风格”的架构,而不是真正的基础模型。
这项工作对工业落地的启示是:跨设备复用的第一道障碍可能不是模型容量,而是物理量纲的统一表达。把采样率作为条件注入归一化层,是一个很轻的改动(可插拔、可退化),却让一个骨干同时处理循环级和高频振动数据;至于它能否延伸到RUL,仍取决于预训练目标是否对齐退化过程。
资料来源:FreqCondNorm: Towards Cross-domain Predictive Maintenance through a Frequency-Conditioned Transformer Foundation Model — arXiv(2026-09-17)。本文为技术要点整理/编译,非原文全文。