
重型农机维修有一个很现实的痛点:技师赶到现场,却发现诊断不准、缺件,只能再跑一趟;收获季停机一天,损失按天计。AWS 的这篇技术博客给出一个可复刻的方案:用 Amazon Bedrock AgentCore 搭一个设备维修助手,让技师用自然语言描述故障,系统给出诊断、所需零件和厂商认可的维修步骤,并附上来源。
四个部件:运行时、知识库、记忆、前端
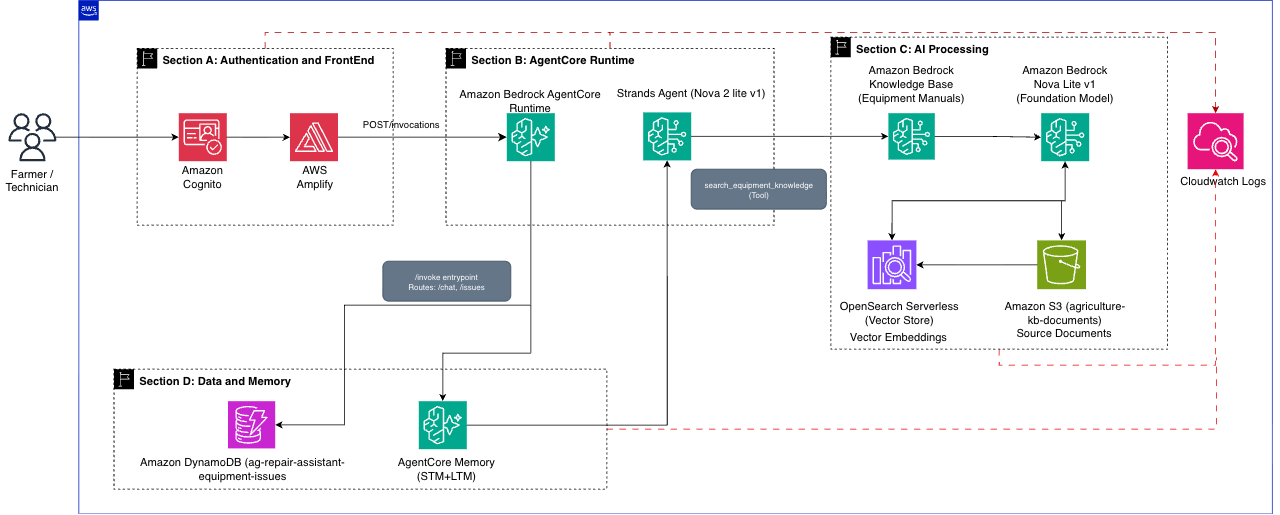
方案由四块组成。前端是 React 应用,托管在 AWS Amplify;身份认证交给 Amazon Cognito。智能体运行在 AgentCore Runtime 上,用 Strands Agents SDK 编写,模型选用 Amazon Nova 2 Lite。知识来自 Amazon Bedrock Knowledge Base:设备手册、零件目录和维修文档存入 S3,用 Amazon Titan Embeddings 做语义匹配,用 Amazon OpenSearch Serverless 做向量检索。AgentCore Memory 负责对话记忆,短期保存会话内上下文,长期保存跨会话的事实。
业务数据也没有缺席:DynamoDB 存设备维修工单,支持增删改查;CloudWatch 和 X-Ray 提供可观测性。整个智能体只暴露一个 /invocations 入口,按请求里的 path 字段分流:/chat 走问答,/issues 走工单操作。
一次问答的链路
技师登录后提问,前端带着 Cognito 的 Bearer token 调用 AgentCore Runtime。运行时校验 token,取出相关历史上下文,把问题交给 Nova 2 Lite。模型判断需要查资料,就调用自定义工具 search_equipment_knowledge;这个工具通过 retrieve_and_generate 接口查询知识库。知识库返回相关文档片段和来源引用,模型再综合成诊断结论、维修步骤和零件建议,最后把答案连同来源一起返回,方便技师核对。
知识库准备:文档质量比模型选择更重要
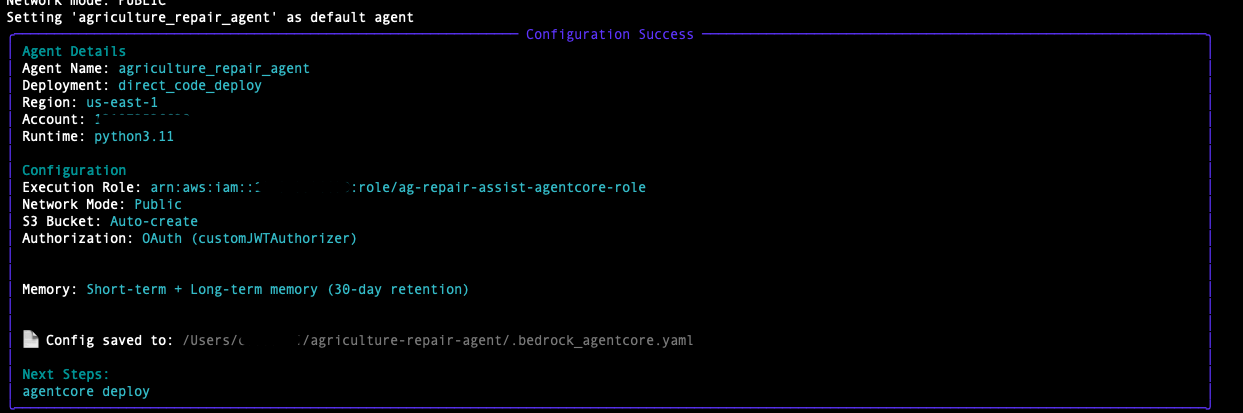
文章把大量篇幅放在建库前的准备上,这一点值得借鉴。文档要能文本检索,不能是扫描图片;命名要统一,例如“厂商_型号_文档类型.pdf”;要提前移除不应让所有用户看到的专有信息。知识库的解析用 Bedrock 默认解析器,切块用默认策略,嵌入模型为 Titan Embeddings G1 – Text,向量库快速新建为 OpenSearch Serverless。数据源同步通常需要 10–20 分钟,之后应在控制台用测试功能验证知识库能回答样例问题。
这套配置是“先跑通”的起点,而不是终局。文档命名、切块和权限如果不在建库阶段处理好,后面换更大的模型也补不回来。
记忆与工单:把对话接到业务里
维修诊断往往不是一问一答。技师可能先描述异响,再补充工况,再追问某个零件的更换步骤。AgentCore Memory 让后续问题不必重复上下文;长期记忆则保存跨会话的事实,例如某台设备的历史处置。工单数据放在 DynamoDB,使“诊断”与“报修”在同一个应用里衔接,而不是让技师在聊天窗口和工单系统之间来回抄写。
成本与边界
文章给出的测试成本很具体:Nova 2 Lite 按每百万输入 token 0.30 美元、每百万输出 token 2.50 美元计费;OpenSearch Serverless 在活跃时约每小时 0.24 美元;AgentCore Runtime、DynamoDB、S3、Cognito、Amplify 在测试用量下处于免费额度内。部署需要 AWS CLI 2.0 以上和 Python 3.10 以上,所有资源必须放在同一区域。
需要清醒看待的是,这是一个面向“农机维修”的参考实现:知识库来自公开的操作手册,工单表是演示级 CRUD,文章没有给出诊断准确率或停機时间下降的实测数据。它证明的是链路可搭、权限与来源可管、成本可估算;能不能在真实维修网络里稳定用,仍要靠在目标机型、目标网络和真实工单上验证。
资料来源:Build an AI-Powered Equipment Repair Assistant Using Amazon Bedrock AgentCore — AWS Machine Learning Blog(2026-06-10)。本文为技术要点整理/编译,非原文全文。