
工业设备运维问答很少一问即止。用户会接着说“还是那台冷水机组”“刚才那个异常”“上次的维修记录”。传统的“计划—执行”单智能体架构在这里露出短板:跨轮上下文难保持,中间结果无法复用,昂贵的时序查询被反复发起。
三层结构,四类专家
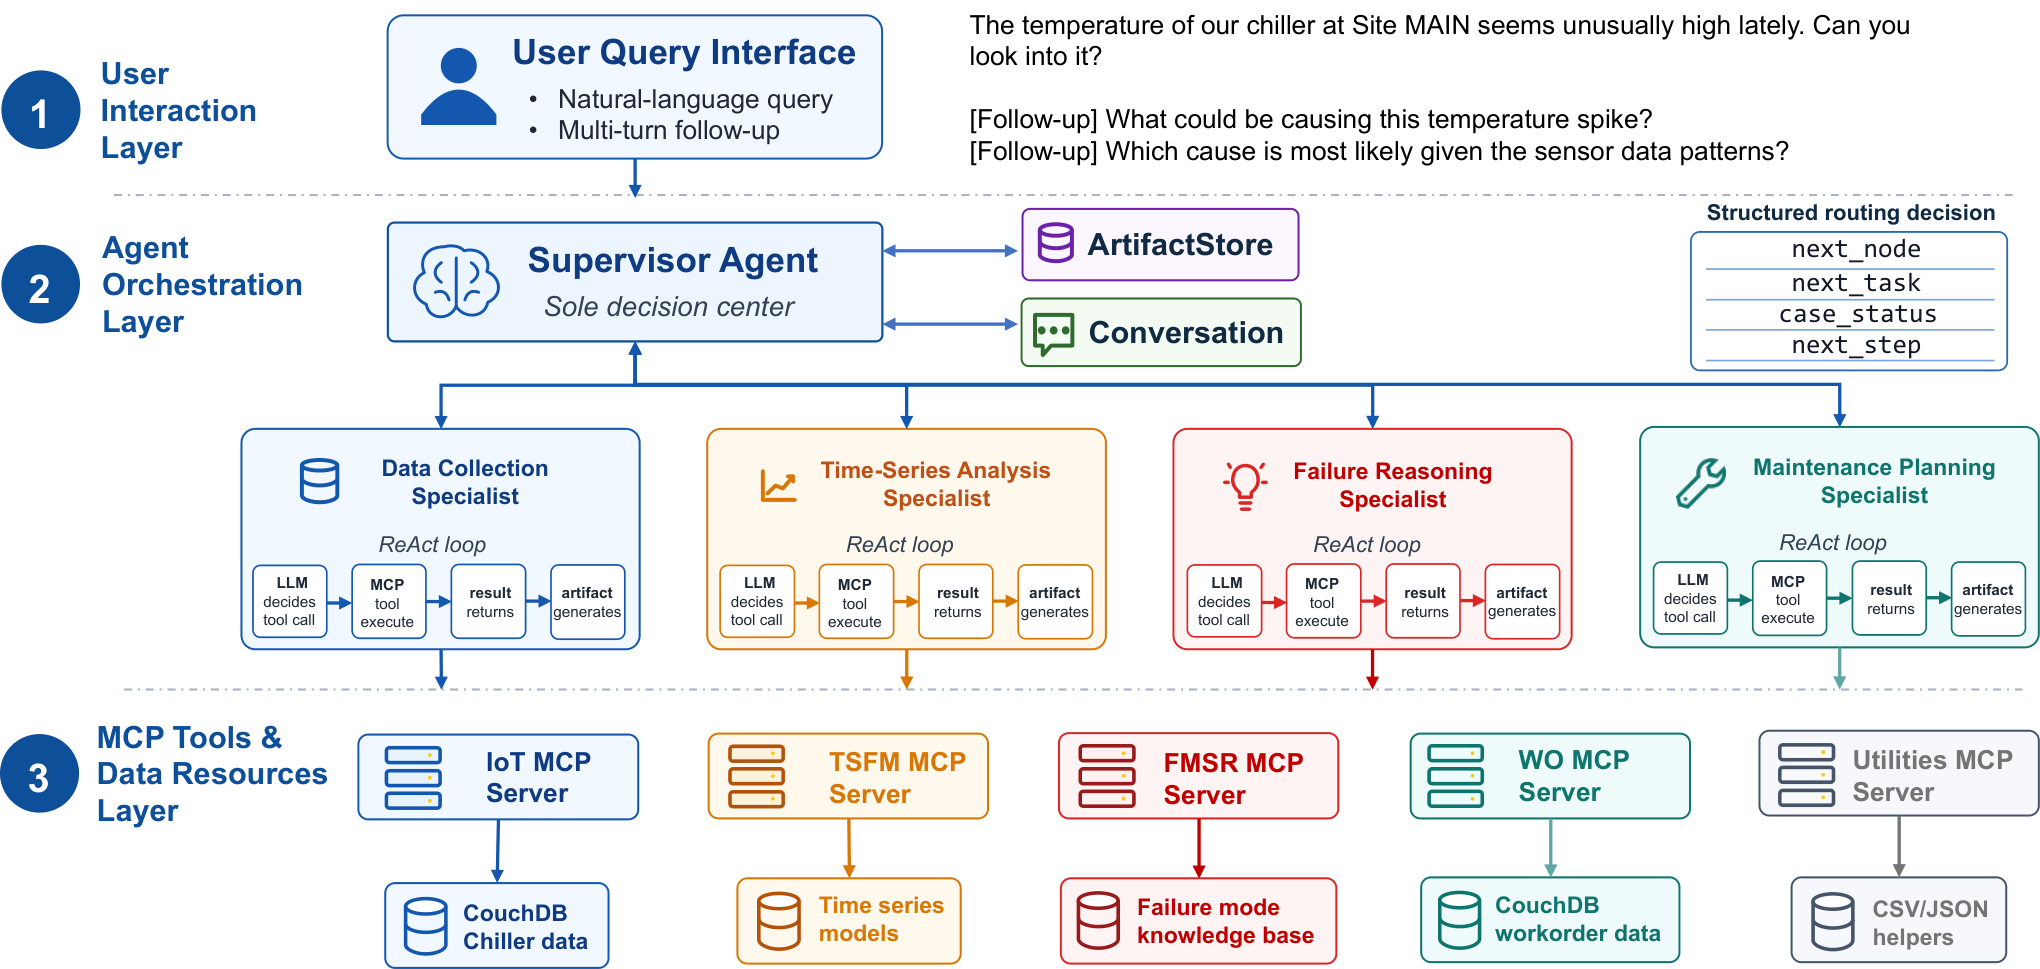
这项研究提出主管—专家(supervisor-specialist)多智能体架构,分三层:用户交互层维护对话状态和上一轮的可复用工件;编排层由主管智能体把意图拆成子任务,分派给专家;工具与数据层通过 MCP 服务器接入 IoT 传感器检索、时序预测、异常检测、工单查询、事件告警检索和故障码映射。
四类专家各有分工:数据采集专家取资产级运行证据,时序专家做预测和异常打分,故障推理专家把异常观察连到可能的失效模式,维修规划专家把诊断证据转成建议动作。
关键设计是每个专家返回“结构化工件”,而不是一段自由文本。工件记录资产标识、时间范围、调用过的工具、关键观察、中间结果,以及假设和置信信号。主管据此合成当前回答,并把工件留给后续轮次。这样,“同一台设备”这类隐含指代可以落到具体证据上,而不必重新拉一遍时序数据。
三项系统级优化
第一是跨轮工件复用:调用新工具前,主管先检查已有工件是否已满足当前请求,只补缺失信息。第二是动态路由与重规划:每轮、每个专家返回后都重新评估意图、已有证据、缺失证据和工具状态,而不是沿着初始计划线性执行。第三是并行工具调用:同一资产的历史传感器、近期告警、历史工单和故障码映射彼此独立时并发拉取,再归一成一个工件。
16 轮对话里的收益与代价
评估使用 16 个基准对话,资产限定为冷水机组,指标覆盖规划有效性、工具使用质量、任务完成、工具名与参数合规、执行成功和失败恢复。相比基线,主管—专家架构的规划有效性提升 54.5%,任务完成提升 37.8%,工具名合法性和参数模式合规接近满分。
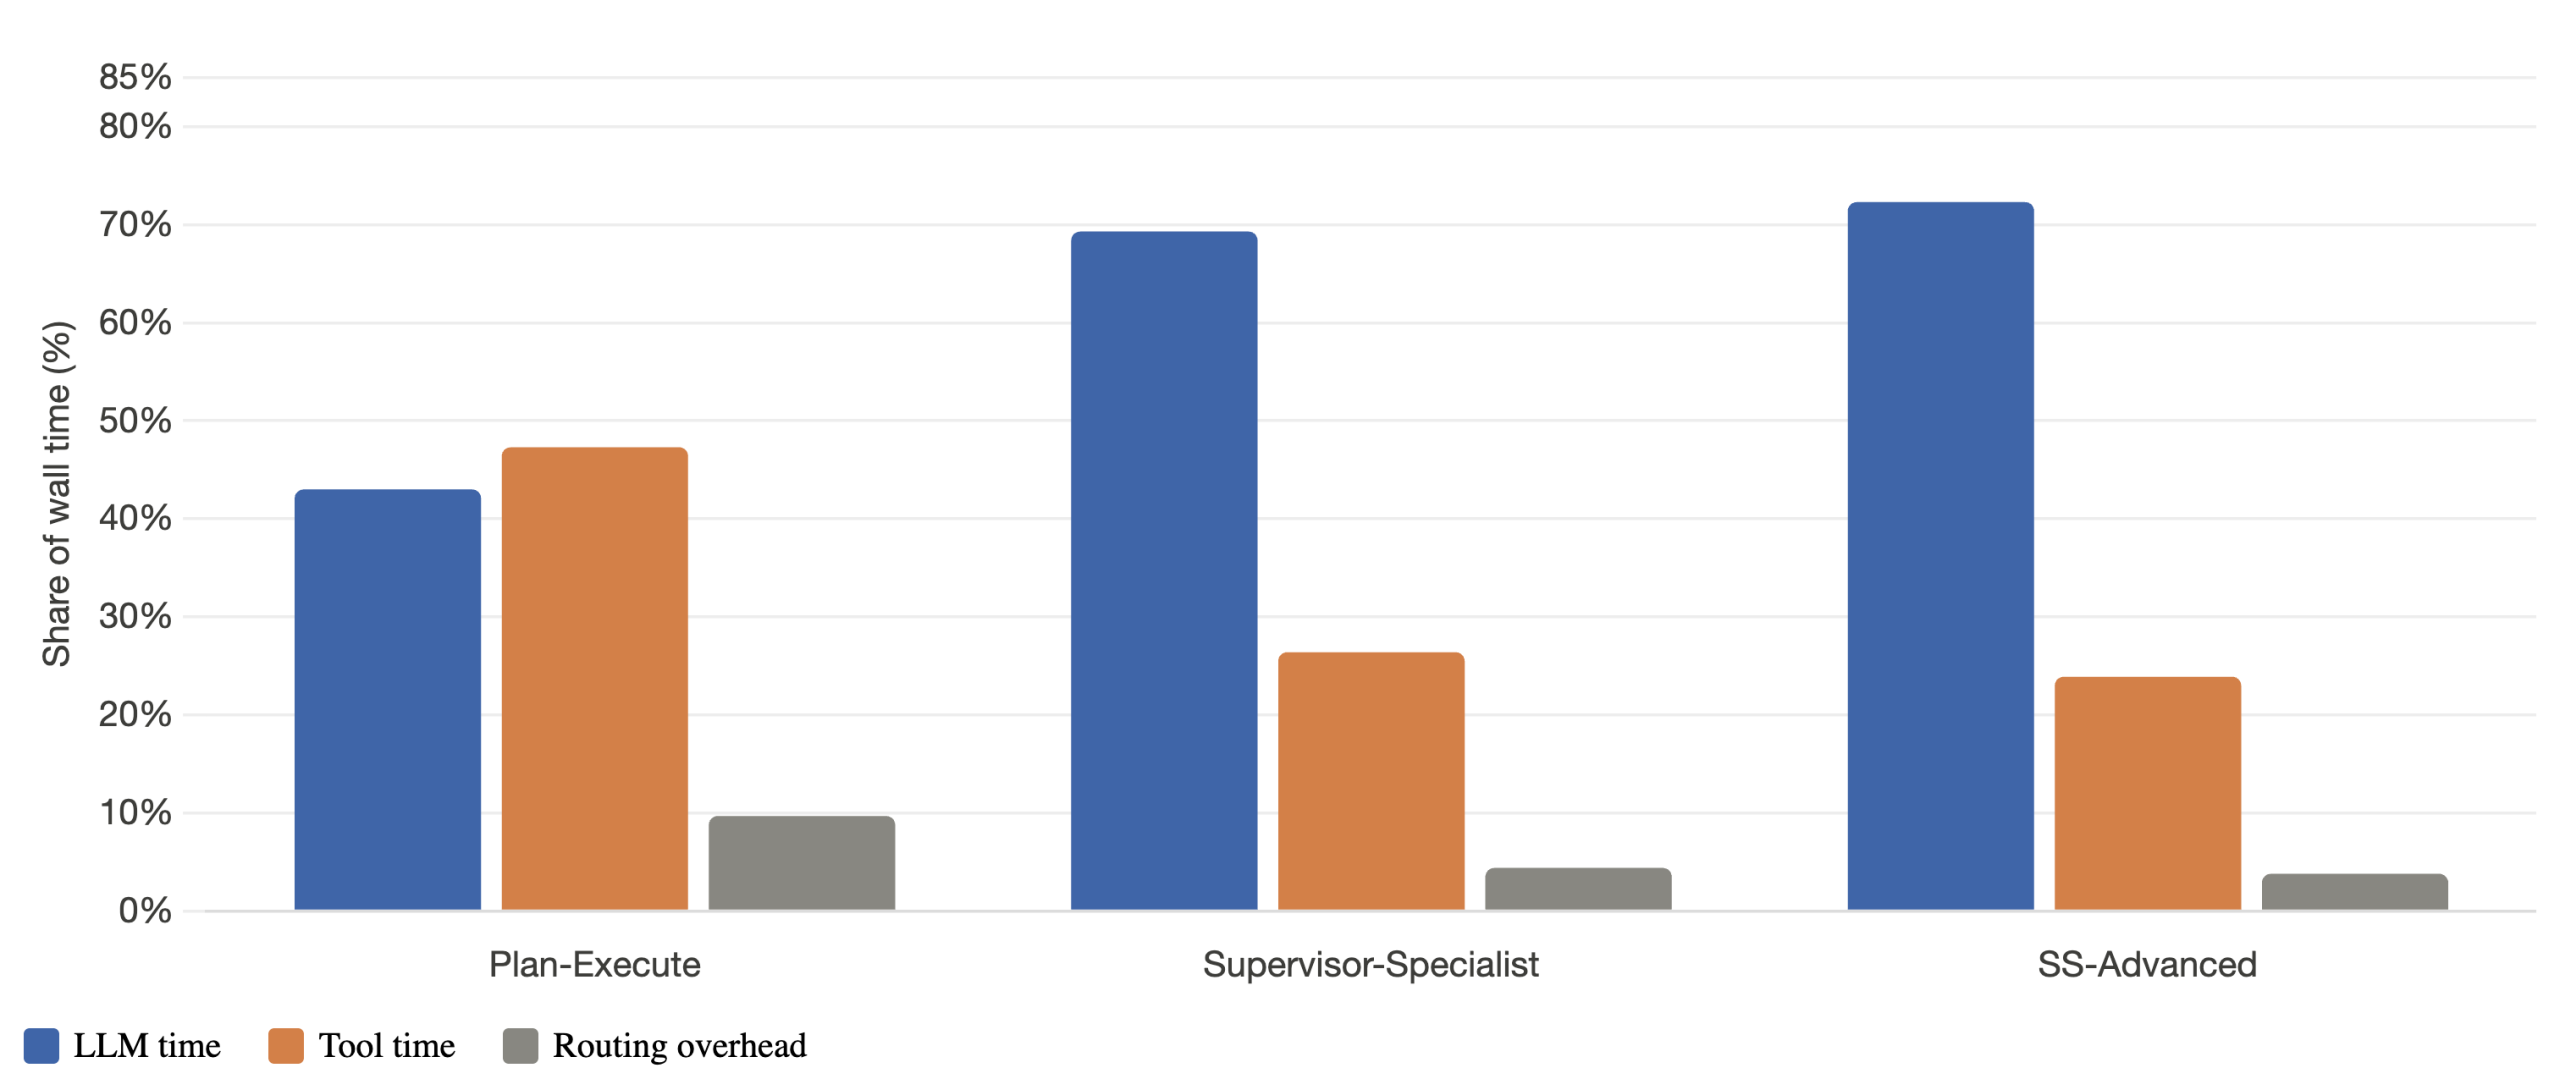
性能剖析更能说明瓶颈转移:基线中工具调用占总墙钟时间 47.3%,主管架构降到 26.3%;第 2 至第 5 轮因复用工件,比首轮快约 4.2 倍。收益主要来自主管路由,而不是工具级并行——并行版本的工具时间占比 23.9%,差别不大。基线在时序基础模型服务器上平均每个对话耗 159.5 秒,是主管架构 37.4 秒的四倍多,该服务器占基线工具时间的 85.5%。
并行并非免费:并行返回的结果拼接后上下文膨胀,平均每次调用 4825 token,比基线 3036 高 59%,token 总量最高,完成时间也不是最短。标准主管架构反而以 65.2 分钟完成全部对话,是最省时间的版本;基线 token 最少,却耗时最长。
边界
论文只覆盖 16 个对话和有限冷水机组资产,MCP 接口也比真实运维环境更干净。它给出的可迁移结论是:把“记忆”做成带来源和置信度的结构化工件,比堆聊天历史更适合工业诊断;先修路由和证据复用,再谈并行,否则只是把工具等待换成模型生成等待。
资料来源:Towards Multi-Turn Dialog Systems for Industrial Asset Operations and Maintenance — arXiv(2026)。本文为技术要点整理/编译,非原文全文。