
排产优化模型的开发长期依赖运筹专家:理解问题、写出数学形式、再把它翻译成求解器代码。一项 2026 年的研究测试了一个更激进的问题:不经过专门训练,通用大模型能否只凭自然语言描述和数据库结构,独立完成约束规划(Constraint Programming,CP)建模并跑出结果?
三条路线,只差任务怎么分
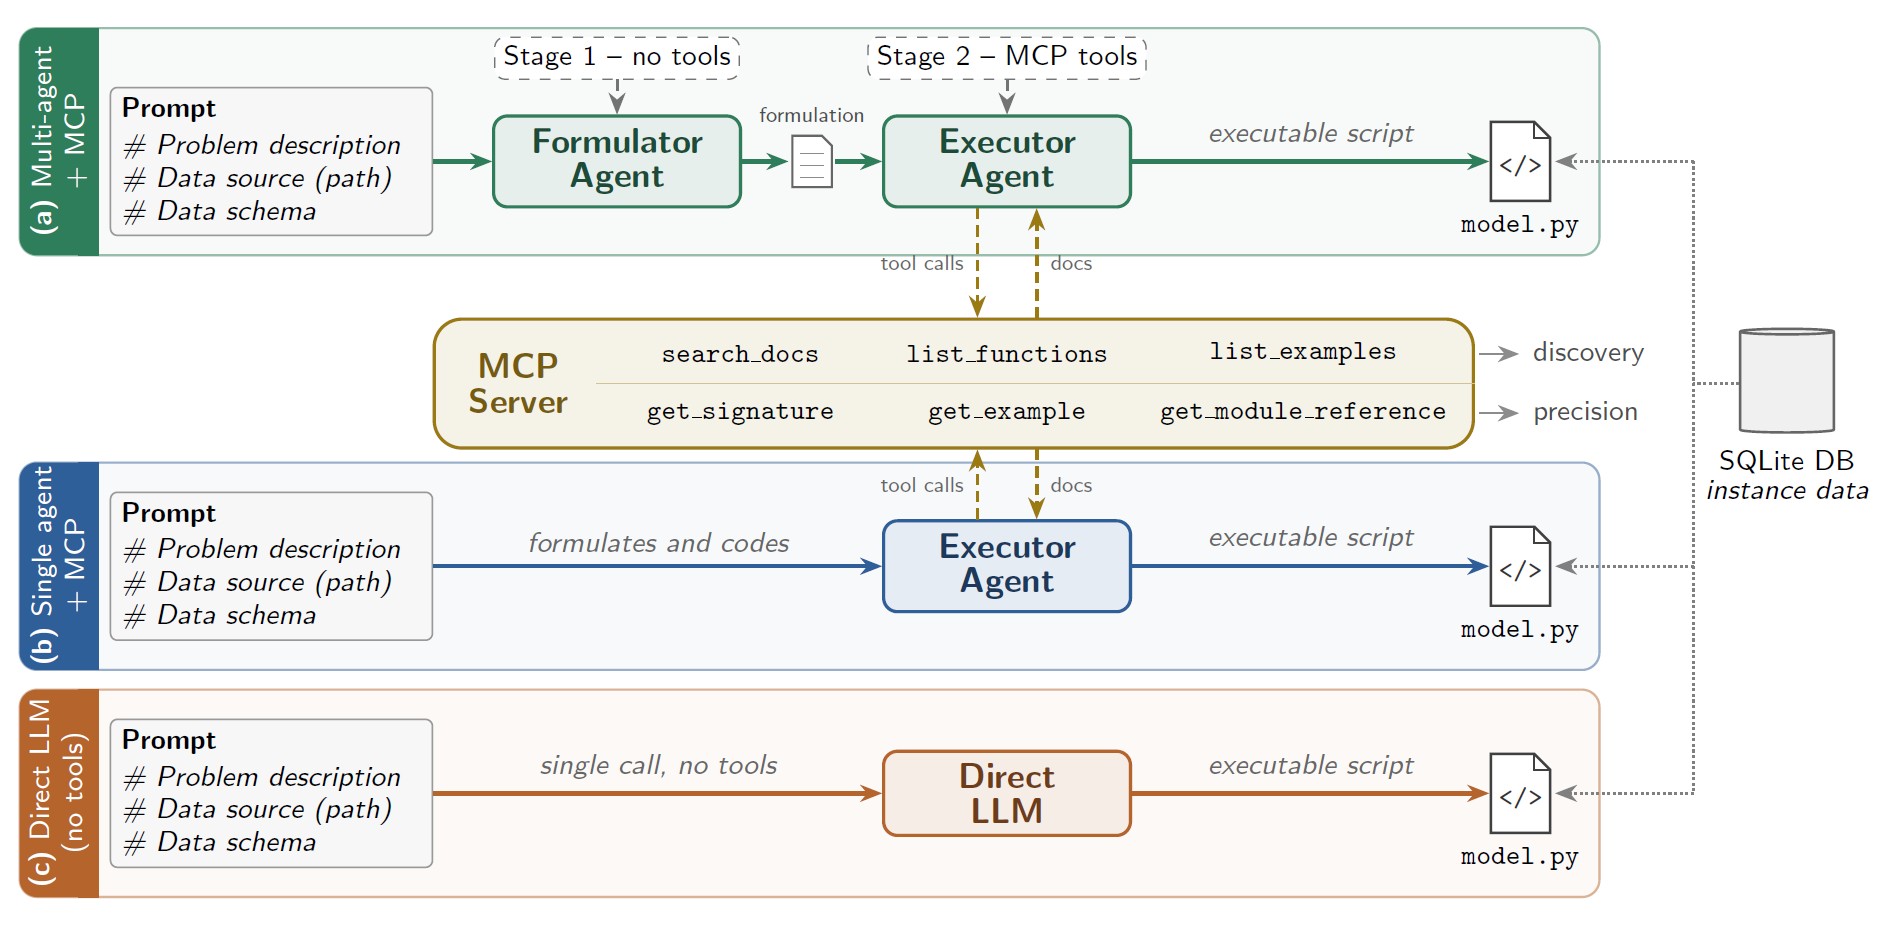
研究比较了三种工作流:多智能体流水线把“建模”和“写代码”拆给两个角色,Formulator 智能体先输出集合、参数、决策变量、带标号的约束和目标函数,并给出数据契约与执行计划;Executor 智能体再按这份规格生成 Python 脚本。单智能体路线让同一个模型兼任两职;直接调用路线则不给任何工具,一次生成完整脚本。
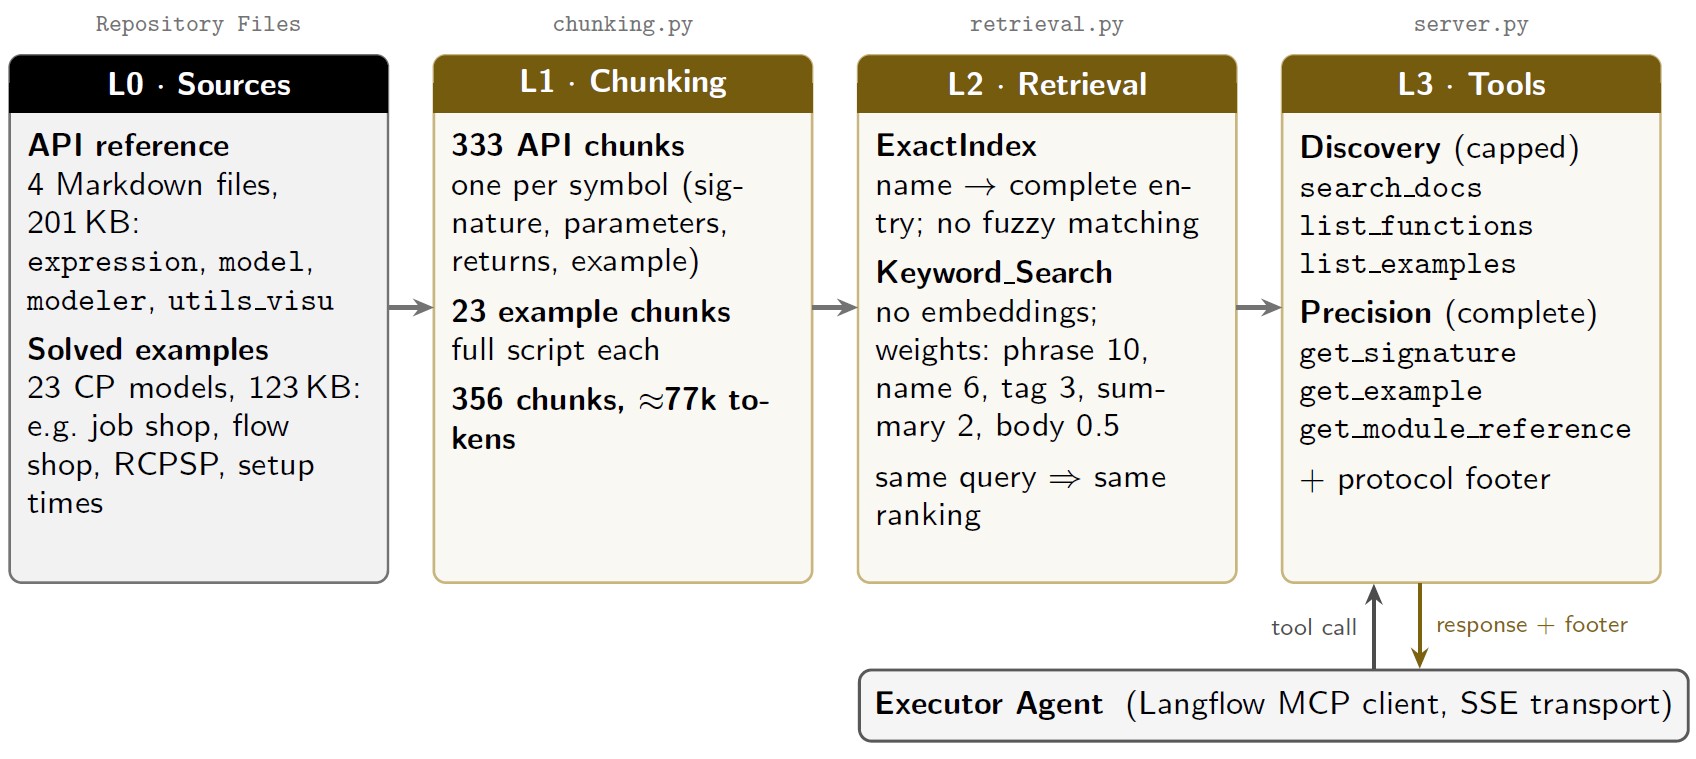
两条智能体路线都接入一个 MCP 服务器,服务器暴露 docplex.cp 的官方文档和 23 个完整示例。工具分两层:先用关键词搜索、符号索引和示例目录定位候选项,再取函数签名、参数、完整示例或模块参考。设计原则是“只取当前需要的文档”,避免把 7.7 万 token 的全文塞进上下文。
六个工业排产问题
测试集覆盖三类车间和三类仓储调度:饮料灌装线的五阶段流水车间,包含 release date、灌装机上依赖顺序的清洗换型、灌装与封盖的无等待耦合;精密机加车间的作业车间,每件有独立工艺路线和交期,目标是最小化加权拖期;注塑厂的柔性作业车间,每道工序只能上持有该模具的压机,加工时间随机器变化,三名操作工作为跨机台的累积资源。另外三个是自动拣选单元的递进模型,从单 AGV、单拣选台,到带托盘库存整数决策,再到双 AGV、容量缓冲区和两台拣选机器人。
实验用 Gemini 2.5 Pro、GPT-5 和 DeepSeek V4 Pro 三个通用模型,每种组合重复三次,共 162 个生成模型。生成脚本只执行一次,限时 60 秒,不重试、不修复,以区分“模型能力”和“迭代调试能力”。
瓶颈不在建模,在落地代码
结果出现明显分层:只看数学形式,智能体路线正确率 77.8%,直接调用为 68.5%,说明当前模型已能较可靠地识别集合、变量和约束。但把形式变成能跑的脚本后,多智能体路线从直接调用的 14.8% 提升到 59.3%,单智能体为 33.3%;在四个较简单的问题上,多智能体达到 80.6%。
代价同样清楚:多智能体平均每次运行 370 秒、消耗 73 万 token,单智能体为 258 秒、44 万 token,直接调用仅 142 秒、约 1.2 万 token。智能体路线 96% 的 token 是输入,且随工具调用次数近似线性增长,因为每轮都要重发整段对话。Formulator 只占 1.7% 的 token,却占 30% 的时间。
真正的难点集中在两个扩展仓储问题:当可选区间、整数分配和两千多条约束同时出现,形式正确率骤降,PC6 的 27 次运行只有 4 次达到参考目标。论文的结论是,复杂模型仍需专家介入;而实现错误大多会显式报错,适合在生成后接一个执行反馈驱动的修复回路。
可复用的工程启发
这项工作的价值不只是“大模型会写 CP”,而是给出了一条把求解器知识变成可检索工具的路:符号索引保证名称可查,精度工具返回完整签名,检索结果确定可复现;先验证 API 再写代码,比让模型凭记忆猜函数更可靠。对制造企业而言,排产建模的门槛可能先降在“写对代码”这一层,而不是一步跨到全自动建模。
资料来源:Agentic AI-Assisted Modeling for Production Scheduling: Assessment in Constraint Programming — arXiv(2026)。本文为技术要点整理/编译,非原文全文。