
企业知识图谱和公开基准里的图谱不是一回事。公开数据集通常稀疏、开放域,实体与关系名还常常和预训练语料重叠;企业 CMDB 建出来的图则密集、受模式(schema)强约束,问题还带着业务规则。SCAIR 的作者先做了一个来自真实制造 CMDB 的基准:11.6 万条三元组、9 类查询、19080 道题,然后证明现有智能体式图谱检索增强在这种图上会系统性失效。
两种主流范式为什么失灵
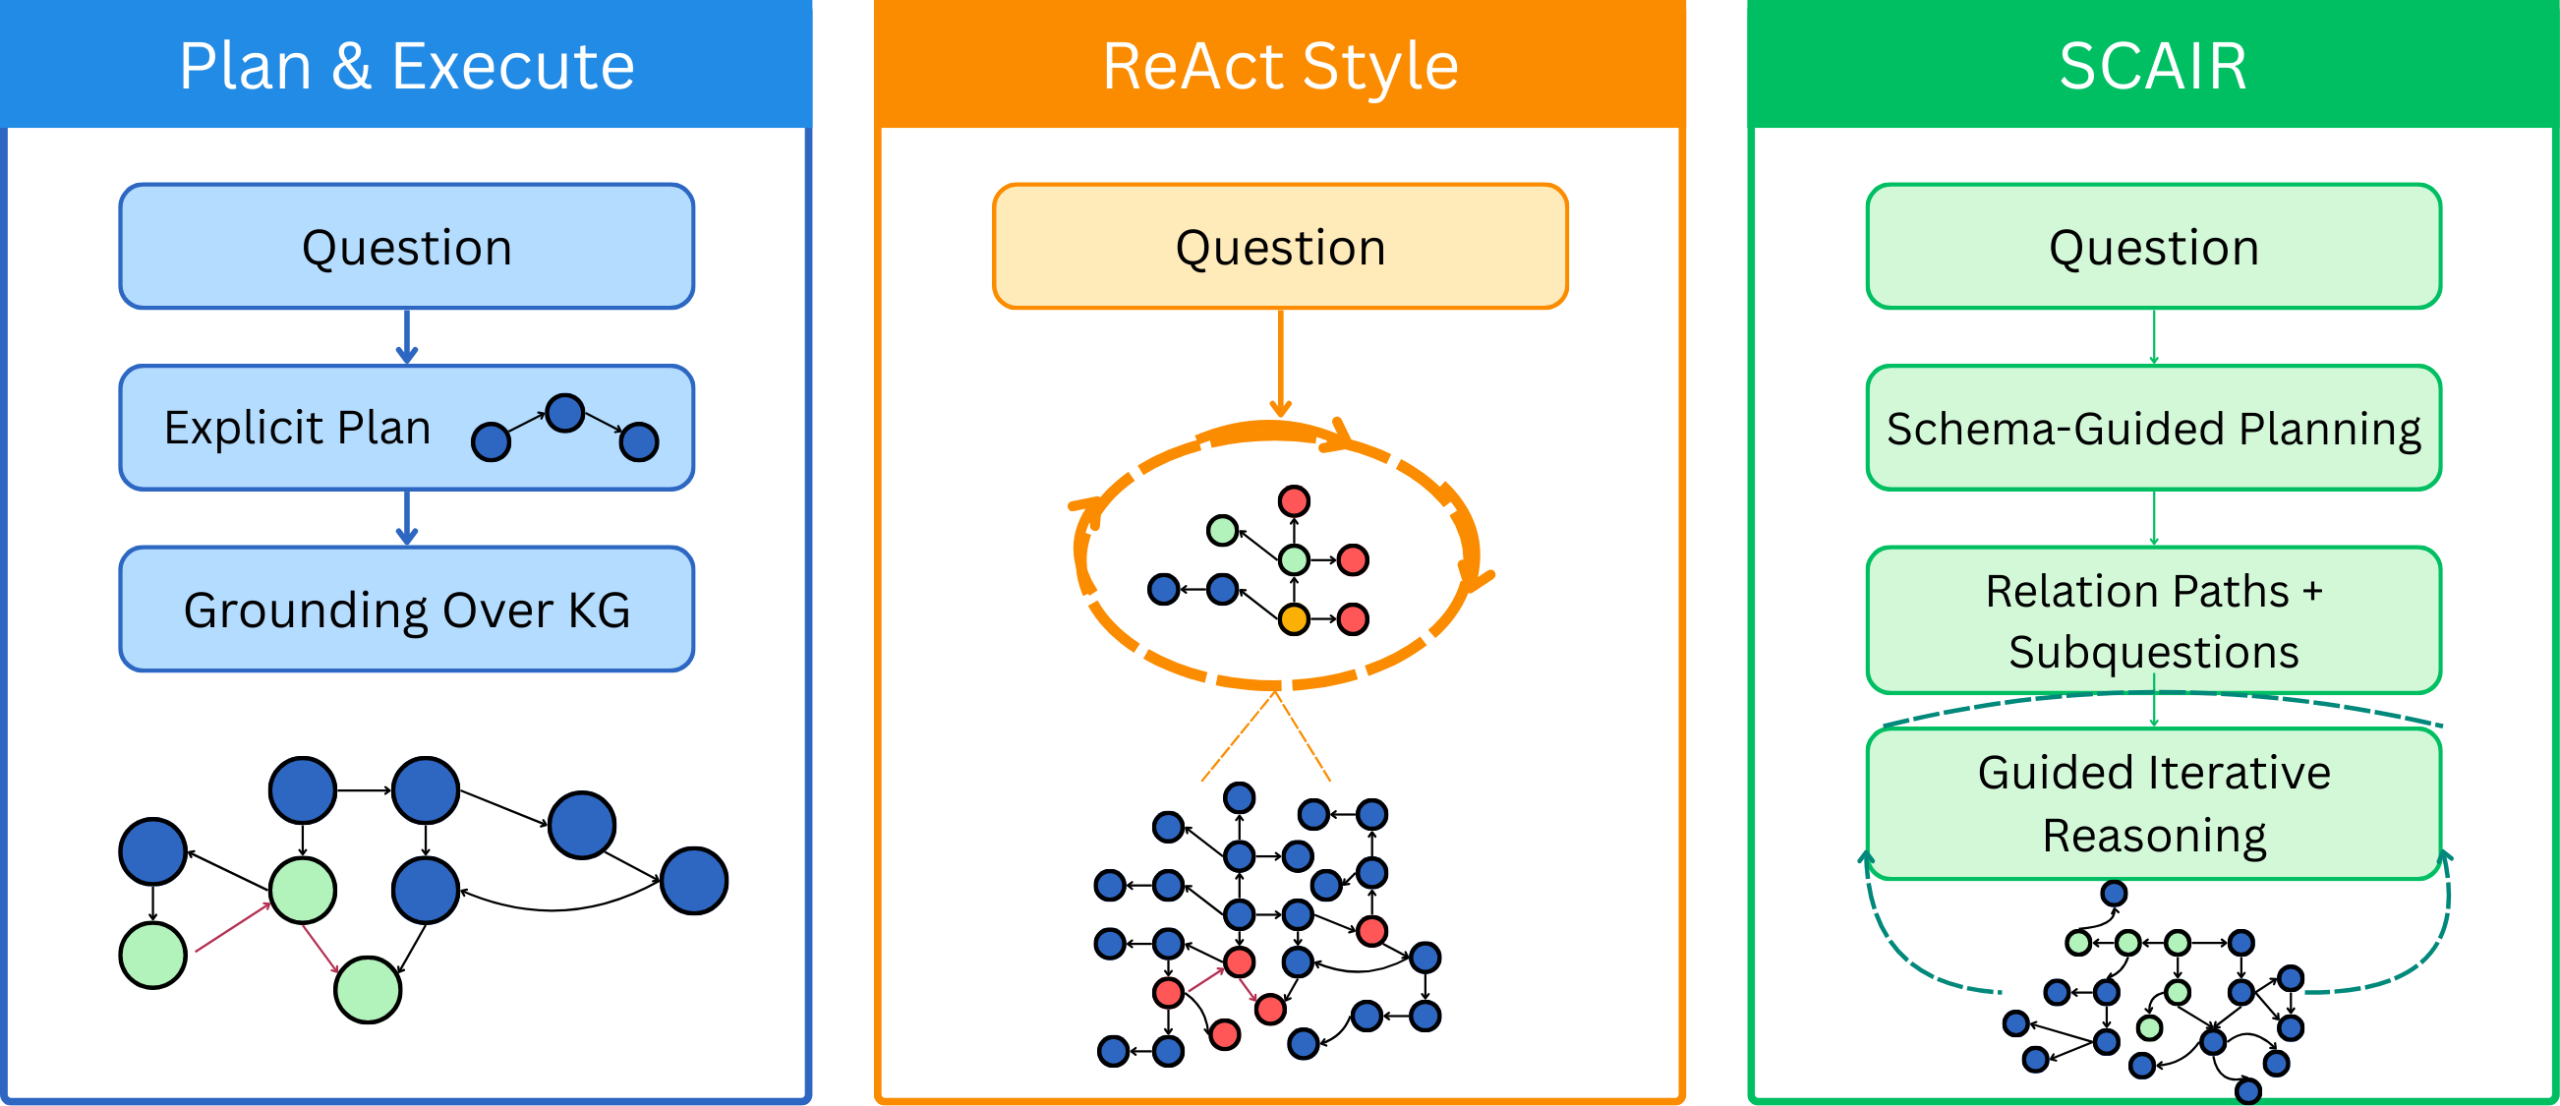
计划-执行类方法先学推理计划或选子图,再按计划检索。问题在于它依赖充分的训练覆盖:查询分布或关系分布一变,学到的计划模板就过拟合,换一套模式就难迁移。ReAct 式迭代探索则按语义相关性一步步走,在密集企业图里容易顺着高连接度的属性节点(编码、状态值)爆炸式扩张;更麻烦的是语义上像、结构上不合法的路径会被当成证据,推理越深越偏,最终语义漂移。
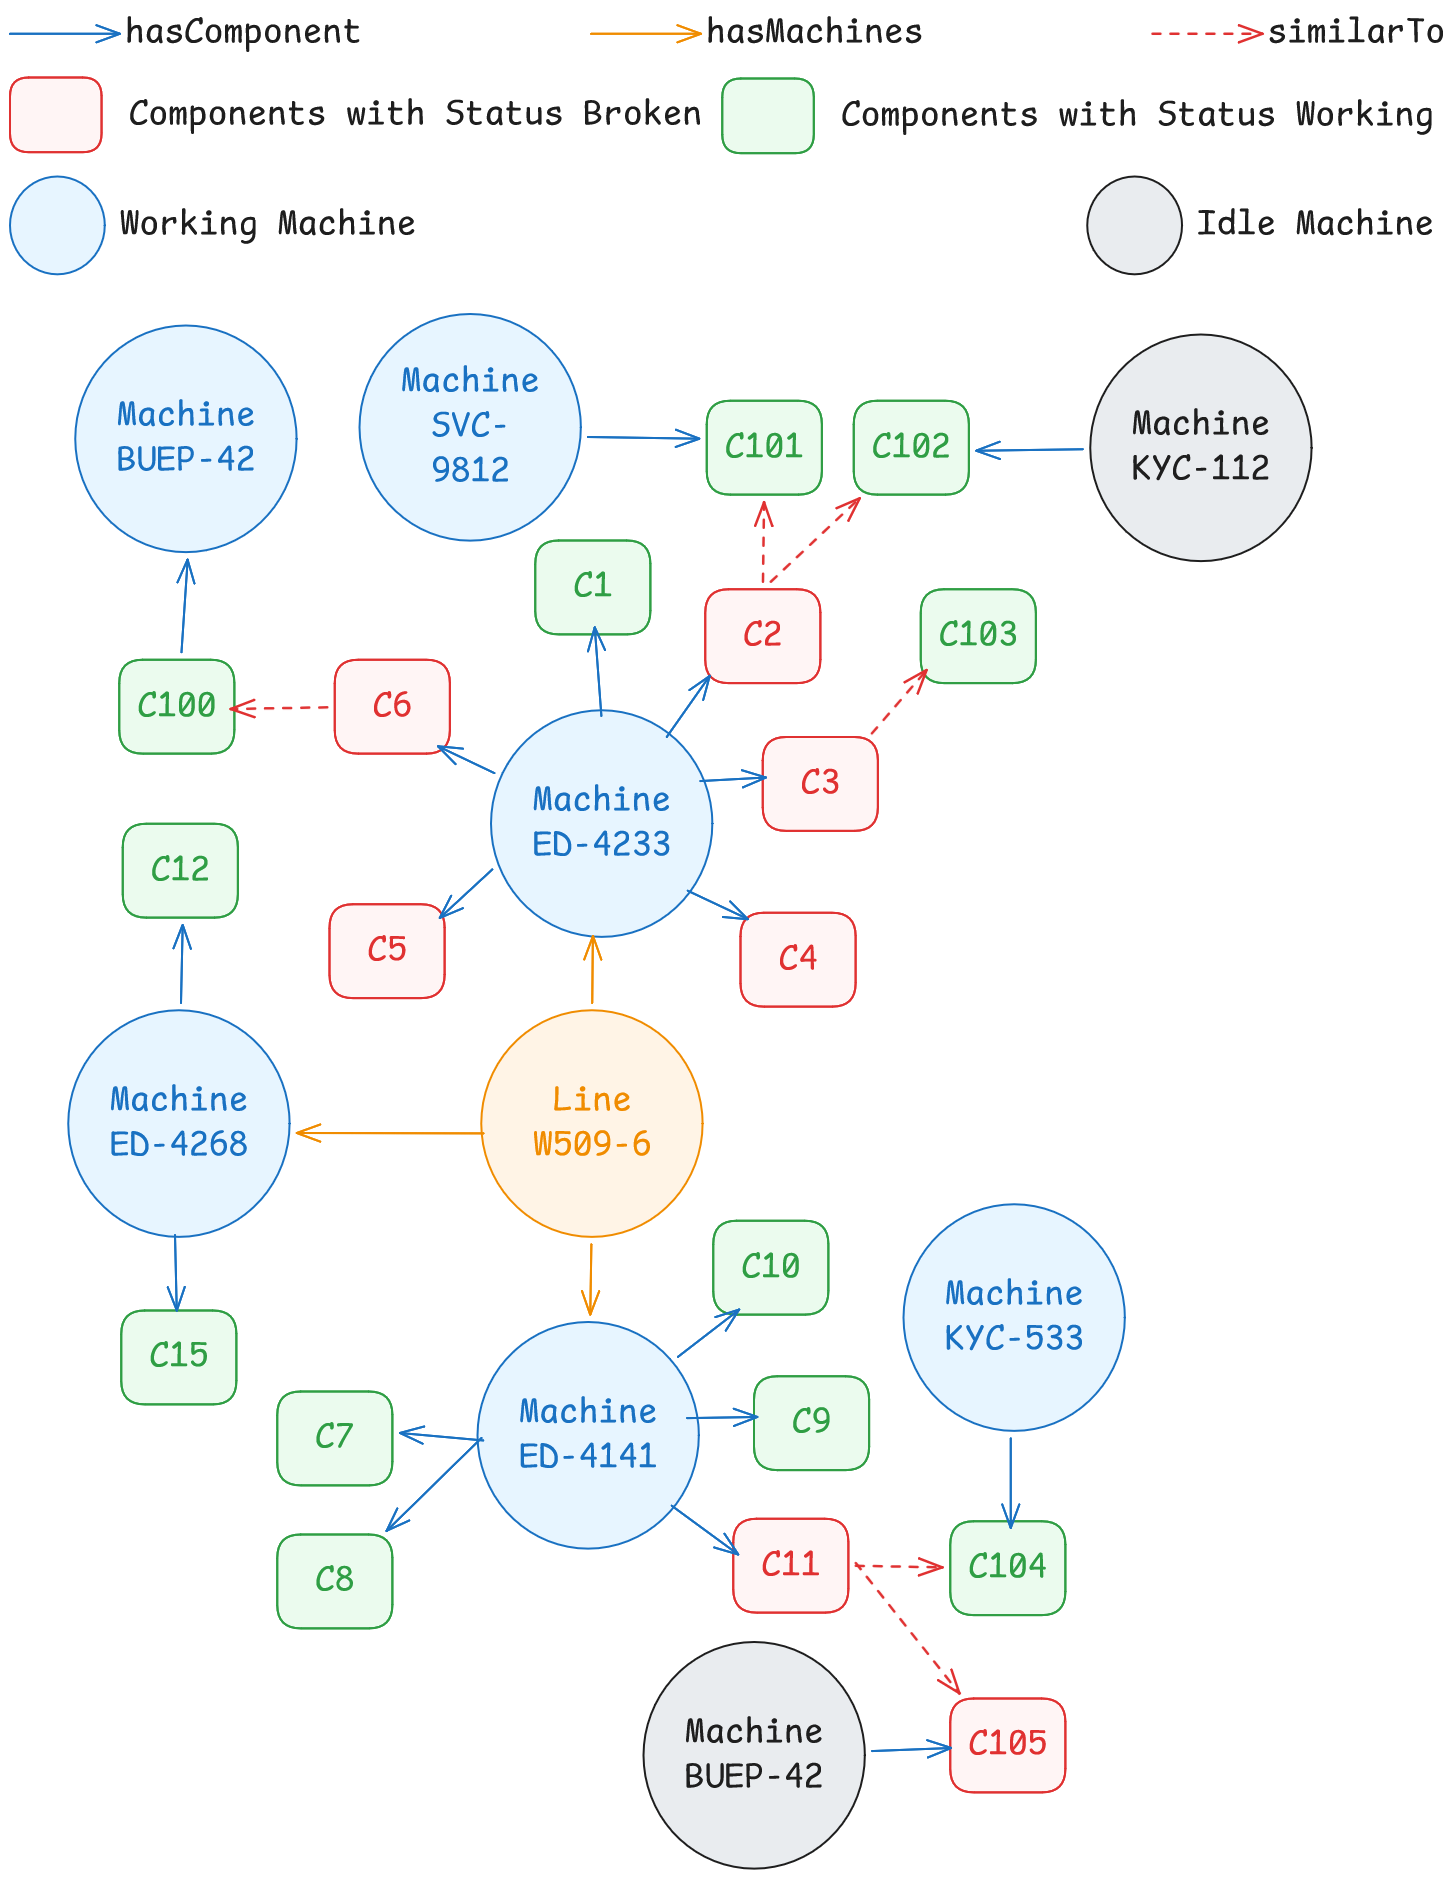
论文举了一个典型问题:某产线上损坏的部件,有哪些在工作的部件可以替换。这不能写成一条固定逻辑式:先找该产线的损坏件,再经功能相似关系找可互换件,还要求替换件本身处于工作状态、且装在空闲设备上——否则拆下来会干扰别的产线。这类隐含业务约束写在图谱结构里,不在问题文本里。
三条设计原则
SCAIR 是免训练框架,把计划与迭代合成一体,但两者都不做死。第一步是模式条件化的轻量规划:按实体类型与关系定义生成符合模式的关系路径,把遍历限制在合法的关系组合内;同时把问题拆成与推理深度对齐的子问题,明确每一跳要找什么。它不承诺单一固定计划,只提供结构先验。
第二步是模式感知的迭代推理:每一层先取当前主题实体的候选关系,用模式约束过滤,再按对应子问题打分;选中的关系展开成候选实体后,继续按累积上下文打分剪枝。语义相关性与结构合法性同时参与决策。
第三步是受控的主题实体传播:每层保留已发现实体与新扩展实体的并集,而不是只用新实体替换工作集。前者保住此前的推理锚点,后者容易过早丢掉还能通向其他关系的入口。
结果与代价
在自建企业基准上,训练式基线里 G-Retriever 综合最强,准确率 25.27、F1 24.28;RoG 的命中任意正解率最高,38.49,但精确率与召回偏低;免训练的 ToG、PoG 全面落后。SCAIR 在所有指标上超过基线,多跳、交集和复杂查询上的提升尤其明显。消融显示,去掉模式关系过滤或实体约束,各查询类型都会稳定退化。
代价是更深的遍历:SCAIR 平均每题 42.36 次模型调用、输入 22.5k token、输出 5.9k,平均深度 2.54 跳;ToG 为 13.95 次、深度 2.14,PoG 为 5.60 次、深度 1.61。多数基准题型本身需要 2 到 4 跳,浅尝辄止的基线因此答不对。输入 token 占大头,但累积上下文适合提示缓存,部署时可用 50% 到 90% 的缓存折扣摊薄成本。
给知识工程的启示
这篇论文的结论对做企业知识库的人更直接:在真实业务图上,通用智能体设计不等于可部署。模式不是建模的附属品,而是推理时必须被执行的约束;把业务逻辑显式写进遍历策略,往往比再训一个模型更划算。反过来说,如果图谱本身缺少类型体系和关系定义,再强的模型也只能在噪声里猜。
资料来源:SCAIR: Schema-Conditioned Agentic Iterative Reasoning for Enterprise Knowledge Graphs — arXiv(2026)。本文为技术要点整理/编译,非原文全文。