

过程孪生(process twin)与只盯单台设备的资产孪生不同,它要实时描述整条生产流程:每一步工序、该工序使用的设备与产品专属设定,以及同一产品下的工艺变体。澳大利亚一家中型食品制造商的HACCP标准作业程序里,26个编码工序组成了16条生产流程,覆盖冷藏、冷冻和无菌常温三类产品。要把这些纸面流程变成能接实时数据的孪生,过去靠人逐条建模、逐个绑定测点。FacProcessTwin 把这两件事交给大模型,但把最终签字权留在人手里。
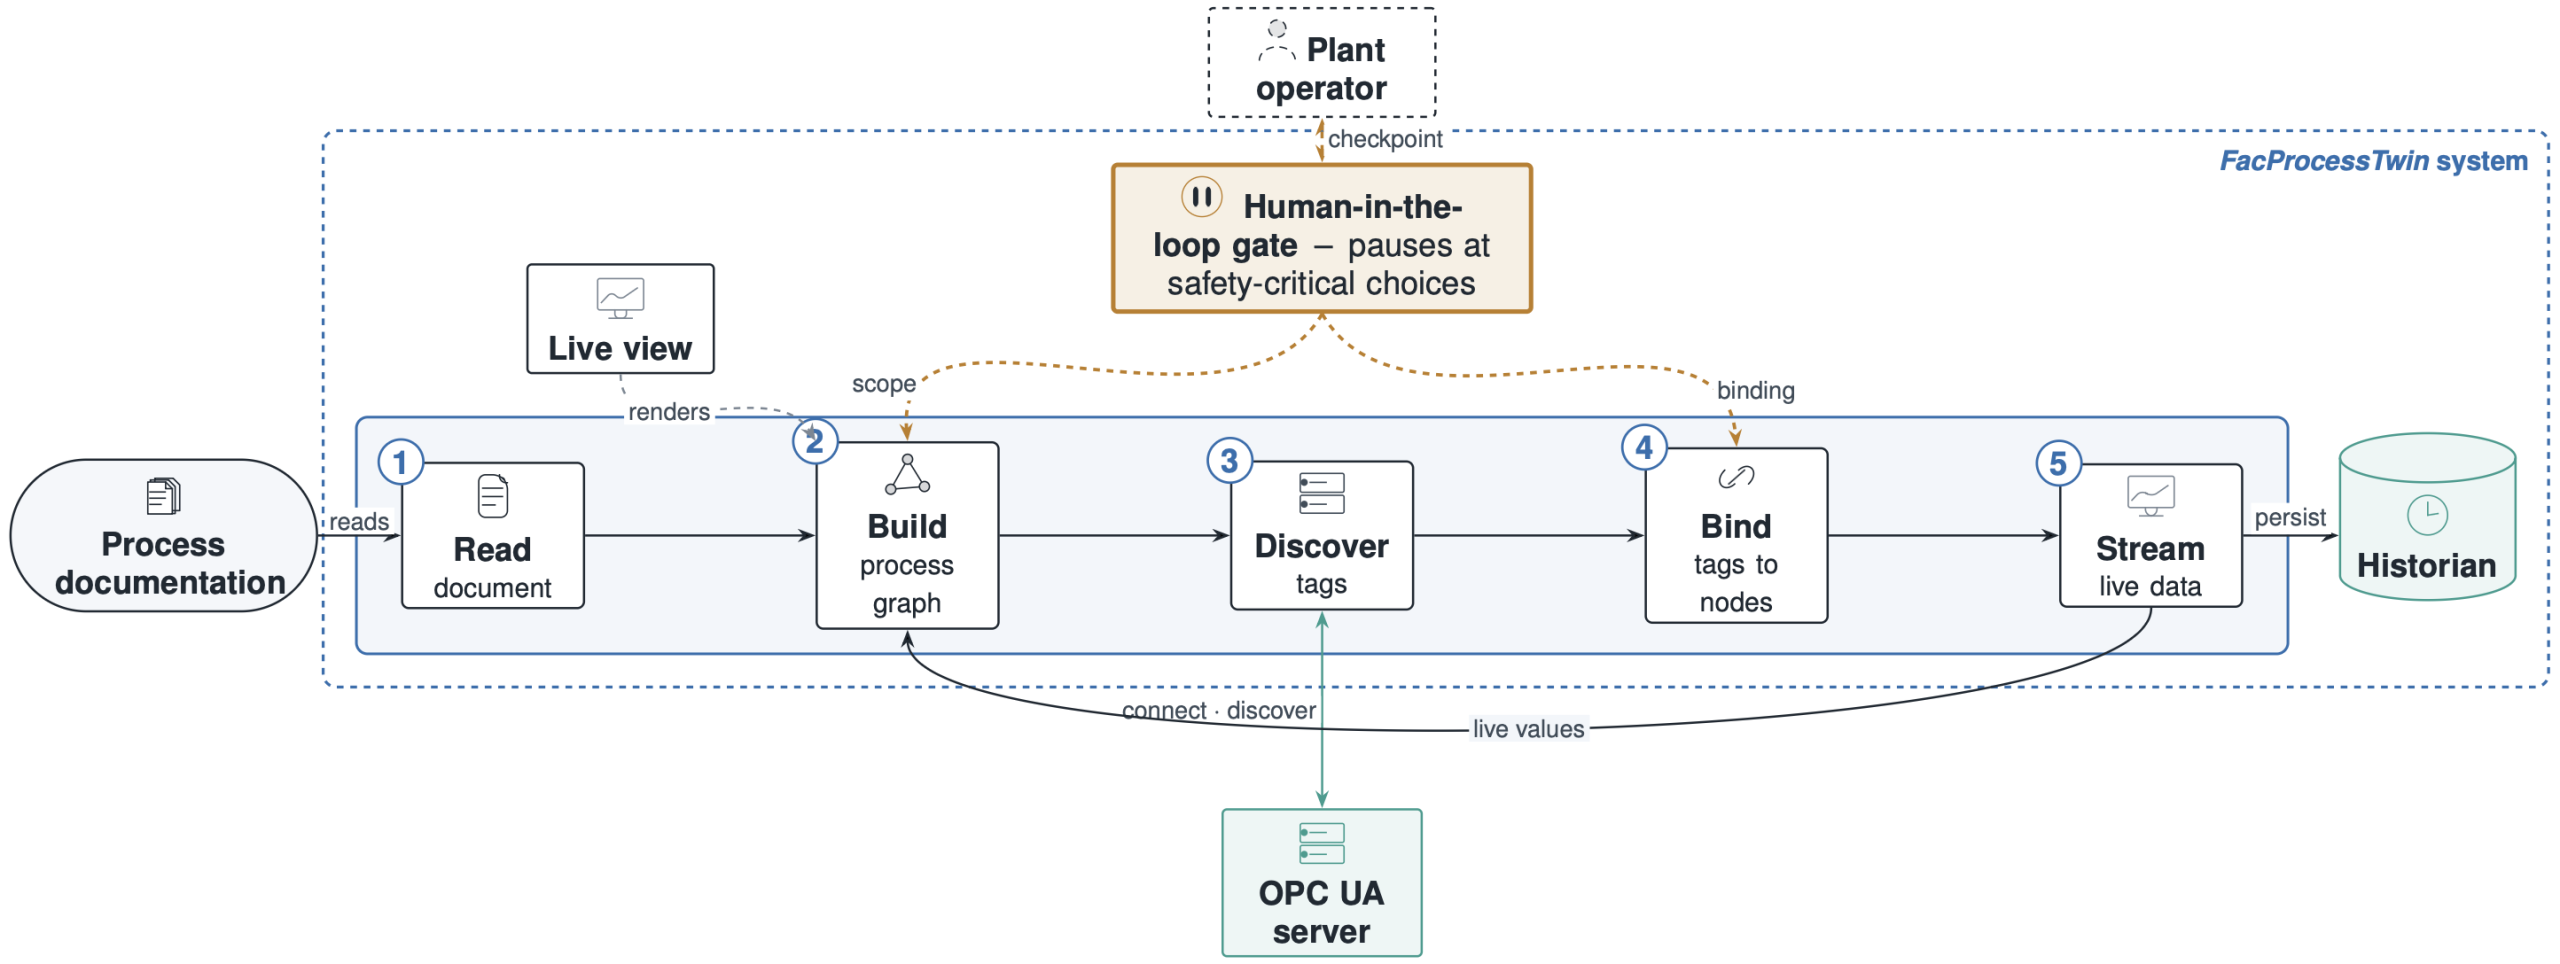
五个步骤,一条可检查的流水线
系统的输入是工厂已有的工艺文档(PDF/DOCX 中的散文和表格)和操作员的自然语言补充。流水线分五步:读取文档、抽取工序并绘制流程图、连接工厂的 OPC UA 服务器并列出测点、把测点绑定到工序节点、订阅实时值并写入历史数据库。每一步都由确定性的小工具执行,模型只能调用、不能绕开;整个代理循环设有40步上限,模型出错只会表现为漏掉一道工序或推迟一次绑定,而不会悄悄改坏流程结构。
流程图画完后不会直接进入绑定,而是先请操作员确认产品流程和布局——这是三个人在环检查点中的前两个。第三个检查点专门处理有歧义的测点:例如无菌流程的超高温灭菌服务器暴露了两个温度测点 T1 和 T2,二者都可能对应灭菌工序,而该工序是 HACCP 的关键控制点,系统拒绝替人选,停下来问操作员哪个是保温管温度。
95.2% 的结构还原,靠的是把人放在关键处
在16条真实流程上,系统从225个标准工序中还原出214个,Topology F1 为95.3%(逐流程平均95.2%,最低85.7%);工序顺序完全正确的有8条,序列准确率平均90.2%;关键控制点标注的保留率为96.4%。测点绑定召回率100%,92个必需测点全部落到正确节点;精确率74.2%,缺口来自文档没有说明某条流程用哪台蒸煮设备,代理把两台设备的测点都绑上了——这是文档信息缺失,不是推理错误。
真正体现设计意图的是那20个“两个测点争同一工序”的歧义样本:单遍基线不问人,绑错15个,错误率75%;带人在环治理的版本全部转交操作员,错误率为0%。在无歧义测点上,两者准确率分别为90.0%和89.4%,几乎无差。也就是说,治理没有用精度换安全,只是把最危险的静默错绑变成了每流程约两次人工问询。
建模时间与模型无关性
每条流程从读文档到孪生上线平均5.2分钟(3.4–7.5分钟),人工基线为31.8分钟(25.2–40.1分钟),降幅83.6%,约六倍。换用 GPT-5-mini、DeepSeek-V4-Flash、MiniMax-M2.7 三个骨干后,结构 F1、序列准确率和建模时间的波动都在约±1个百分点以内,说明效果主要由流程与提示策略决定,而不是某个模型。
作者也划了边界:评测只覆盖一家工厂的一套SOP,16条流程共享同一套工序词汇,跨厂泛化尚未验证;每次歧义都转交人工,操作员是否接受这种负担还需要专门研究。若要解决“哪台设备”这类文档没写的信息,下一步应接入 ERP 与 MES 的生产数据,而不是换更大的模型。
资料来源:FacProcessTwin: An LLM-Based System for Process Twin Development — arXiv(2026-06-16)。本文为技术要点整理/编译,非原文全文。