
柔性作业车间里,订单插单、设备故障、加工时间偏差会不断改写调度状态,也会改写“下一步先做谁”的优先级。固定调度规则快、可解释,但一套逻辑难以适配所有状态。华中科技大学机械科学与工程学院提出的 DSevolve,把这个问题拆成两半:离线用大模型进化出一个多样化的规则库,在线用神经网络按当前车间状态挑规则。
一条“冠军规则”管不了动态车间
柔性作业车间调度(FJSP)要在可选机床上分配工序并排定顺序,本身是 NP-hard 问题。动态版本(DFJSP)又叠加了新订单到达、机器故障和加工时间波动,调度状态持续变化。精确的混合整数规划或约束规划能给出高质量方案,但在线反复重优化很难满足响应要求;启发式调度规则快而透明,却把同一套优先逻辑套用到所有状态;基因表达式编程能进化出更丰富的规则,但部署后仍然固定;深度强化学习引入状态相关决策,但端到端调度器常受规模迁移和可解释性困扰,规则选择型方法又受限于预定义规则集的质量与多样性。
大模型驱动的自动启发式设计提供了新路径。EoH、ReEvo、HSEvo 等工作表明,大模型能合成比手工规则更易读的复合优先级函数。但关键缺口在于:这些规则通常离线进化一次,随后固定部署。同一动态轨迹中,不同事件状态可能偏好不同的优先级行为;而在每次扰动后重跑一遍大模型进化,又与在线重调度的速度要求相冲突。
离线造库:要多样性,不要单一精英
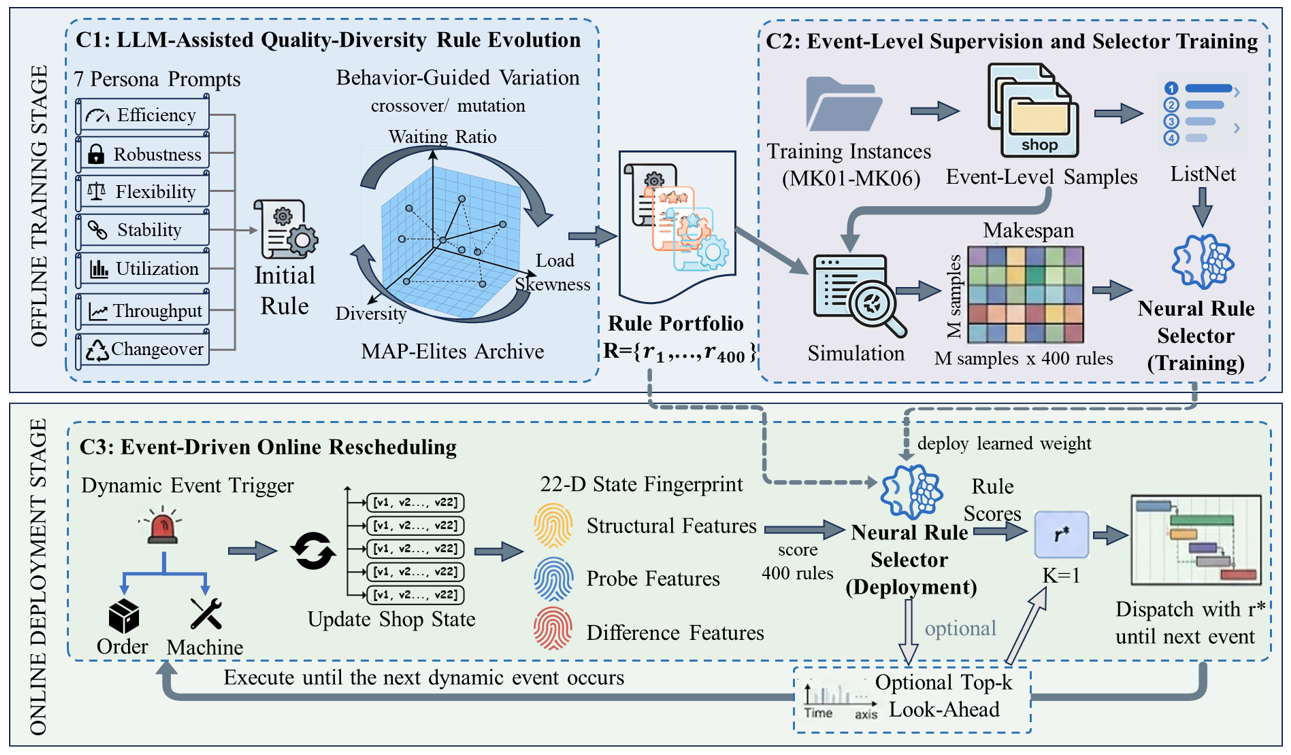
DSevolve 的离线阶段是一次质量—多样性搜索。它用多角色种子(multi-persona seeding)产生初始规则,用 MAP-Elites 行为档案按行为特征归档候选,再用行为引导的变异算子扩展搜索,目标是保留一组行为互补的规则,而不是只留下训练集上最好的那一条。实验中,规则库由 Qwen-Plus 生成,规模为 400 条复合调度规则。
规则库建好后,论文用事件级仿真产生训练标签,训练一个神经选择器。选择器学习的是候选规则的相对排序,而不是“哪条规则最好”的单标签,损失函数采用 ListNet 排序损失。
在线选规则:22 维状态指纹
在线阶段,每次初始化、订单到达或机器故障之后,选择器都会接收一个 22 维状态指纹,输出 400 维规则得分,选出排名最高的规则并执行到下一个事件。状态指纹由比值和归一化差值构成,以便在规模变化时仍可用。论文称,选规则可在约一秒内完成;可选的 Top-K 前瞻则在响应时间与调度质量之间提供一个可调旋钮。
实测:小规模训练,大规模零样本
实验用 Brandimarte 基准构造动态实例:MK01–MK06 生成 500 个小规模训练实例(425 训练、75 验证),MK07–MK10 生成 320 个中等规模测试实例,MK11–MK15 生成 400 个大规模泛化实例,插单后最大达到 330 个工件。
在主结果中,DSevolve 的平均 makespan 为 5296.75,相对差距 2.74%。对静态自动启发式设计的精英规则,它对 EoH、HSEvo、ReEvo 的胜率分别为 72.50%、71.25% 和 71.88%;对七种经典调度规则胜率超过 97%;对 DRL-GP、GEP-Nie、GEP-Shady 的胜率分别为 75.62%、89.69% 和 72.81%。论文还指出,经典单特征规则的相对差距都在 50% 以上,复合规则基线都在 20% 以内——多特征组合已吃掉大部分差距,DSevolve 的优势来自按状态切换。
只在 MK01–MK06 上训练的选择器,零样本迁移到更大规模实例后仍保持优势:大规模集上平均 makespan 为 7113.22,EoH 为 7250.09,相对差距 2.19%;对三种大模型进化基线的胜率为 75.00%–77.75%,对全部经典规则在 400 个泛化实例上全胜。消融也支持这一判断:把规则库坍缩成单条训练最优规则,平均 makespan 升到 5396.52;去掉多角色初始化升到 5519.84;去掉行为特征空间升到 5489.75。
边界与启示
代价是复杂度移到了离线:规则库要进化、选择器要仿真训练,在线只做一次轻量排序。实验全部建立在基准衍生的动态实例上,采用“同一时刻只激活一条规则”的部署协议,尚未覆盖真实产线的数据噪声与规则切换开销。但它给出了一条清晰思路:大模型不必直接当调度器,它可以负责“造规则”,把实时决策留给一个可解释、可审计的选择器。
资料来源:DSevolve: Enabling Real-Time Adaptive Scheduling on Dynamic Flexible Job Shop with LLM-Evolved Heuristic Portfolios — arXiv(2026)。本文为技术要点整理/编译,非原文全文。