
基于本体的知识图谱构建,是实现领域知识多维理解与高级推理的核心技术。工业标准文档尤其含有大量技术信息与复杂规则,以表格、适用范围、约束、例外与数值计算等形式高度结构化地呈现,使知识图谱构建格外困难。本文介绍一种面向工业标准文档的本体知识图谱框架,它通过层级化与命题化的组织方式,把文档的层级结构与逻辑结构统一到本体—知识图谱中,并借助大语言模型完成三元组抽取。
工业标准文档的三项技术挑战
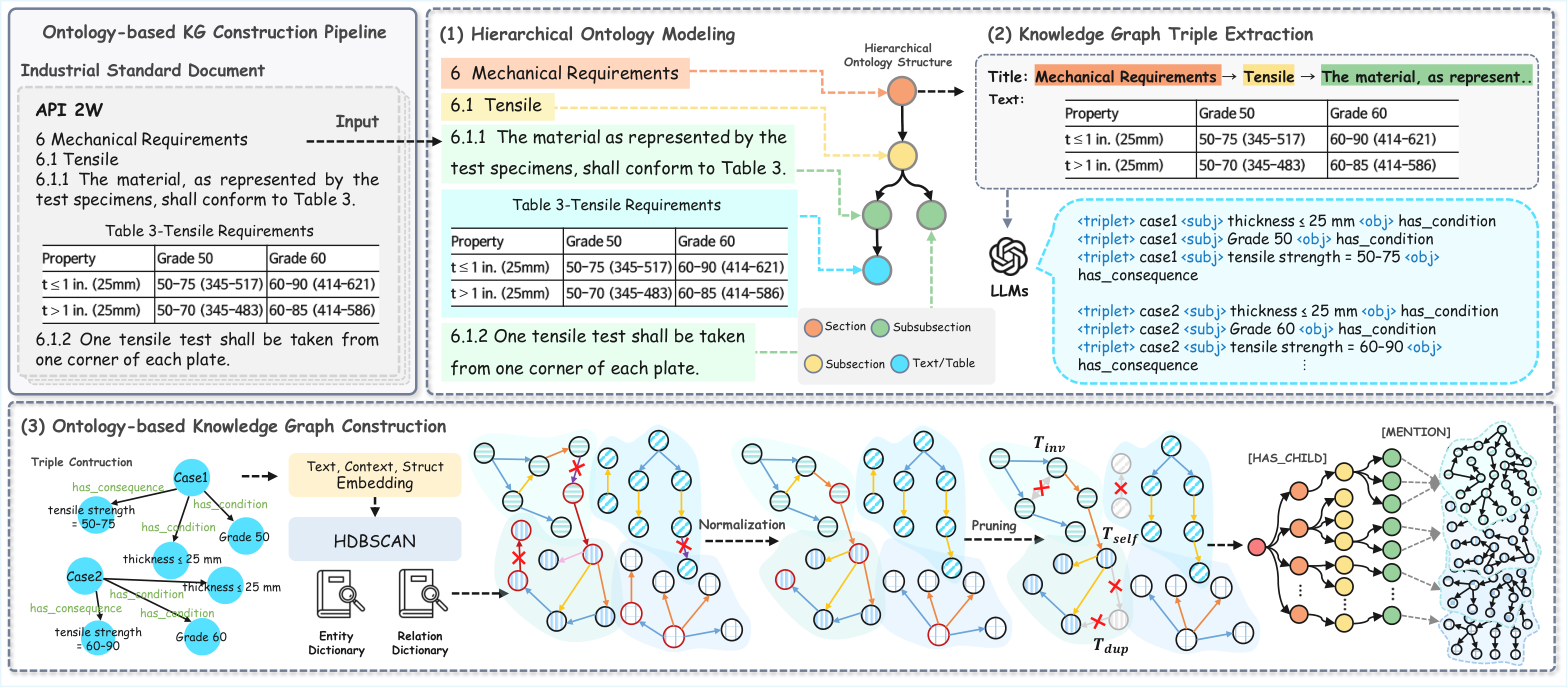
工业标准是船舶与海洋工程等行业用于保证材料与制造过程一致性和质量的重要规范,包含成千上万条相互关联的条款,其中涵盖表格、适用范围、约束、例外与数值规格,解读难度大,而条款中的“毒性条款”或解释差异还可能引发争议。当前这些文档主要依靠领域专家人工比对与审查,成本高、效率低。研究归纳出三项技术挑战:其一,工业标准格式复杂且不规范,难以准确解析其层级结构并统一规范化文本与表格;其二,需要可靠的方法从条件规则(if–then)、适用范围与例外、数值换算以及复杂表格中抽取有意义的三元组;其三,大语言模型抽取的三元组需与本体结构对齐,包括同义词规范化与关系剪枝等精化过程,以去除冗余或无关链接。为此,研究提出三阶段流水线:层级化本体建模、原子命题本体建模与基于本体的知识图谱构建。
层级化本体建模
层级化本体建模定义一个反映标准文档层级组织的模式。研究基于经 OCR 解析的 PDF 数据,在保留文档中位置与版式信息的前提下提取文本与结构,揭示出文档并非单纯的文本集合,而是由父子关系支配的语义组织结构。每个文档被划分为 Section、Subsection、Subsubsection、text、table、footnote 等单元,共同构成层级结构。在层级结构识别中,使用正则表达式识别“1. Scope”“5.6 Scanning”“Annex A”等章节编号格式,并转换为一致的层级结构;表格与脚注也依据上下文链接到对应的父章节。随后,带层级结构的文本被切分为适合知识抽取的最小句单元,形式上表示为标题—文本对:标题作为锚点界定上下文范围,文本提供该范围内的具体事实。由于工业标准中常出现“3-in. [75-mm]”“ASTM A6/A6M”等领域特定模式,研究采用保留单位、缩写与表格标识的分词规则。
原子命题本体建模与图谱构建
在原子命题本体建模阶段,条件语句、例外与数值规则被分解为原子级的句子表达,以便进行基于大语言模型的三元组抽取。第三个阶段是基于本体的知识图谱构建,将抽取到的三元组链接到本体模式,并通过同义词规范化与关系剪枝精化实体与关系,从而在保证一致性的同时提升效率。研究使用 ASTM A578/A578M、API_2W 与 ASTM A6/A6M 等工业标准构建本体知识图谱,并实现本体感知的 KG-RAG 框架。研究表明,传统知识图谱构建方法常因同义词与表达差异而出现冗余、稀疏与不一致,进而降低图谱嵌入与检索增强生成(RAG)的性能;而 Wikidata、DBpedia、YAGO 等通用知识图谱虽广泛用于信息检索与推理,却难以表达领域特定规则与基于表格的知识,因此面向高度结构化的技术文档需要可靠且一致的本体知识图谱构建方法。
数据集与实验评估
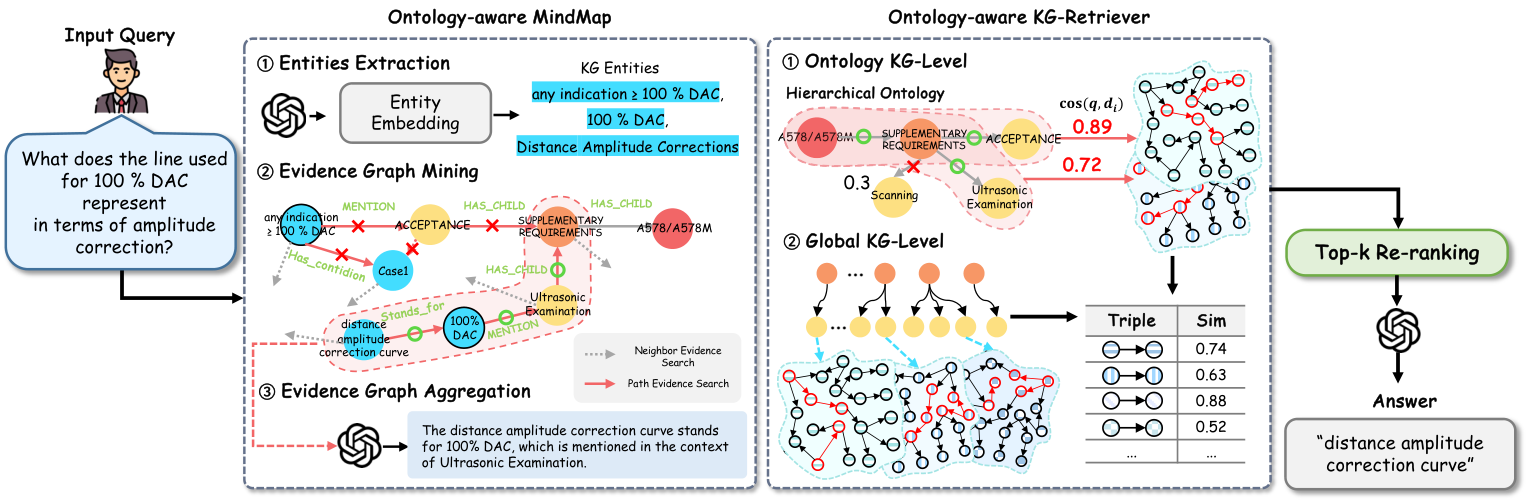
为验证方法的有效性,研究从工业标准中构建了涵盖规则、表格与多跳类型的问答数据集,以及一个毒性条款检测数据集,并实现本体感知的 KG-RAG 框架进行对比评估。对比对象包括仅使用大语言模型、使用完整文档的大语言模型、基于 BM25/Ada-002 的 RAG,以及已有的 KG-RAG 方法。实验结果表明,相比现有 KG-RAG 方法,所提方法在各类问答任务上均取得显著的性能提升。研究认为,即使面对条件、约束与适用范围相互交织的工业文档,也能实现可靠且可扩展的知识表示,可为面向领域的 RAG 开发与智能文档管理提供支持;相关代码亦已公开。
小结
该框架的价值在于把工业标准文档的层级结构与逻辑结构同时纳入表示:层级化本体建模将章节、表格与脚注组织为父子结构;原子命题本体建模把条件与数值规则分解为可抽取的原子表达;基于本体的图谱构建再通过同义词规范化与关系剪枝保证一致性。结合本体感知的 KG-RAG 与新建的问答、毒性条款数据集,该方法验证了在高度结构化、条件交织的工业文档上实现可靠知识表示的可行性。
参考来源
本文根据 Ontology-Based Knowledge Graph Framework for Industrial Standard Documents 等公开资料整理,版权归原作者与原媒体所有。